
Huffman kd tmrtsi algoritmus BENCSIK GERG NYY 8
Huffman kód – tömörítési algoritmus BENCSIK GERGŐ [NYY 8 IY] Algoritmusok és Adatszerkezetek II.
A Huffman-kódolás karakterek (jelek, betűk, számjegyek) olyan kódolását jelenti, amelyben az egyes kódok nem azonos hosszúságúak (különböző számú bitből állnak) annak érdekében, hogy a szövegek átlagosan rövidebbek legyenek, mint az azonos hosszúságú kódoknál. Ez a karakterek gyakoriságának figyelembe vételével történik. A kódolás egy mohó stratégián alapszik, és az adattömörítésben igen hatékonyan használható.
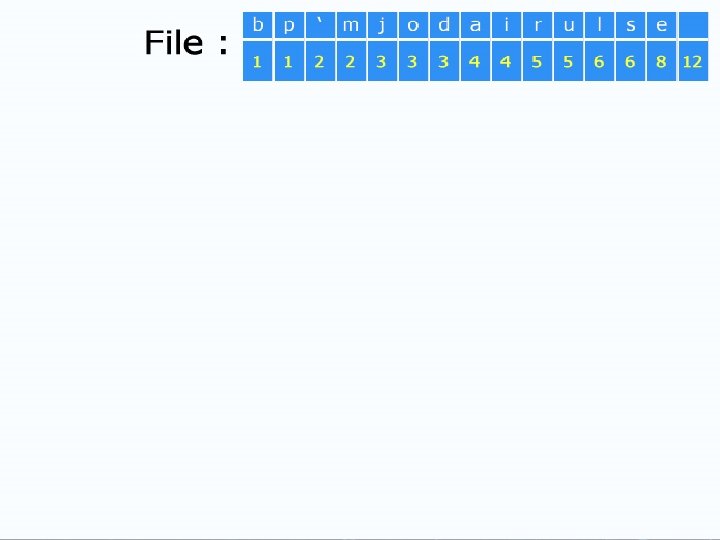
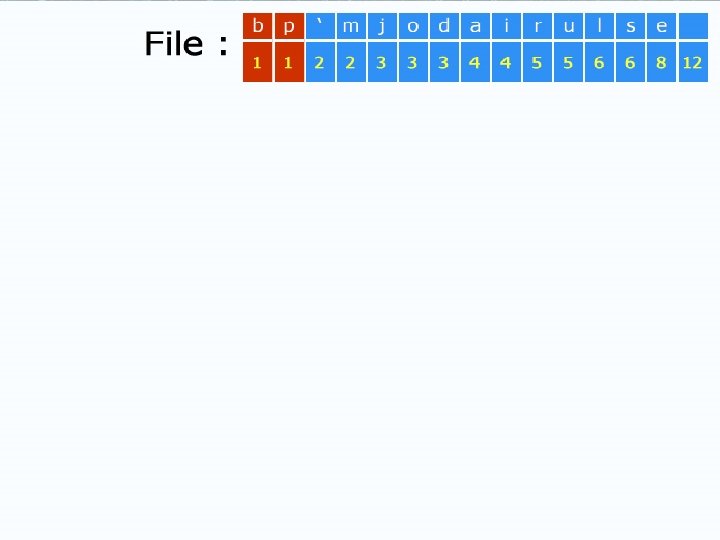
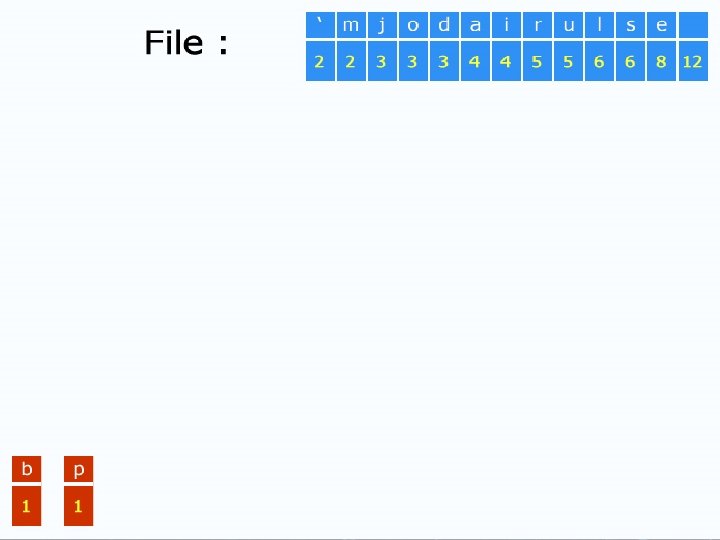
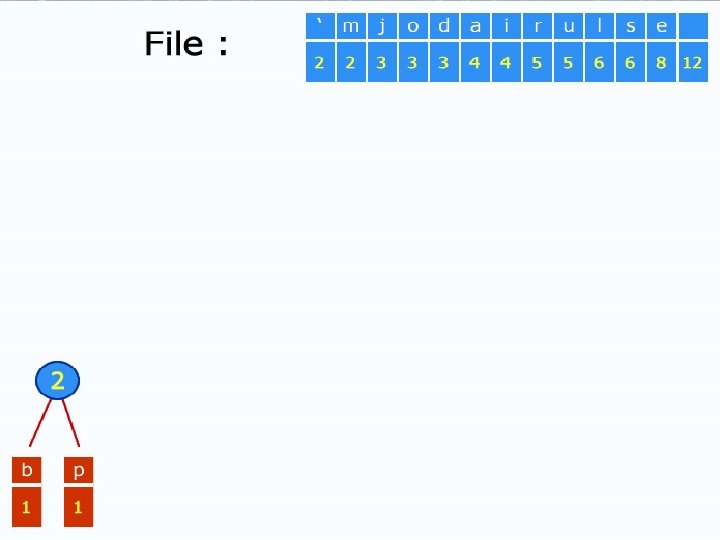
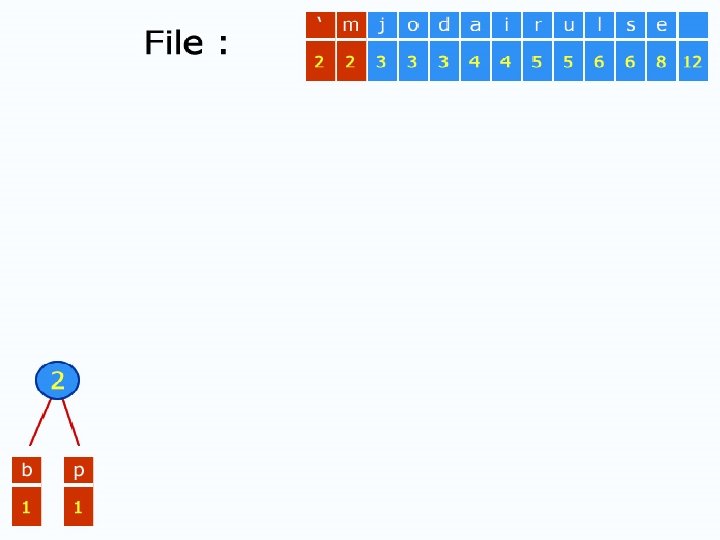
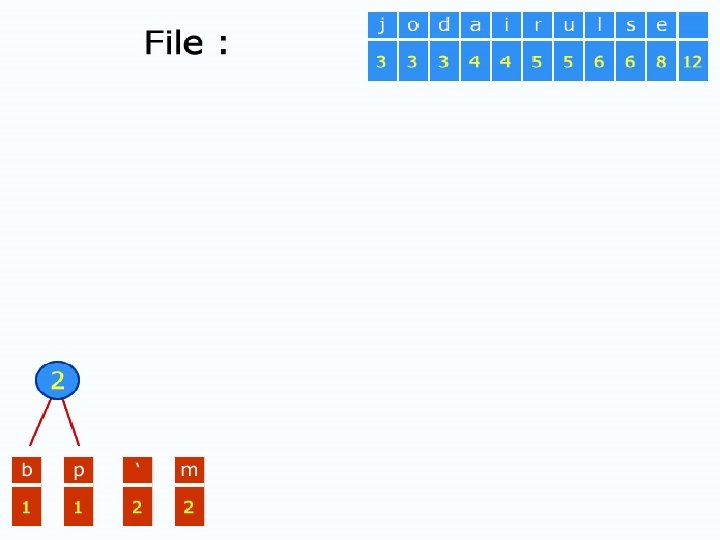
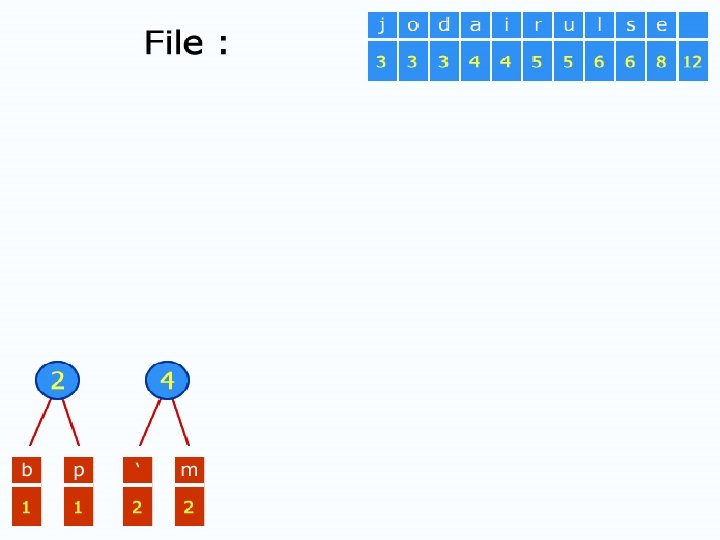
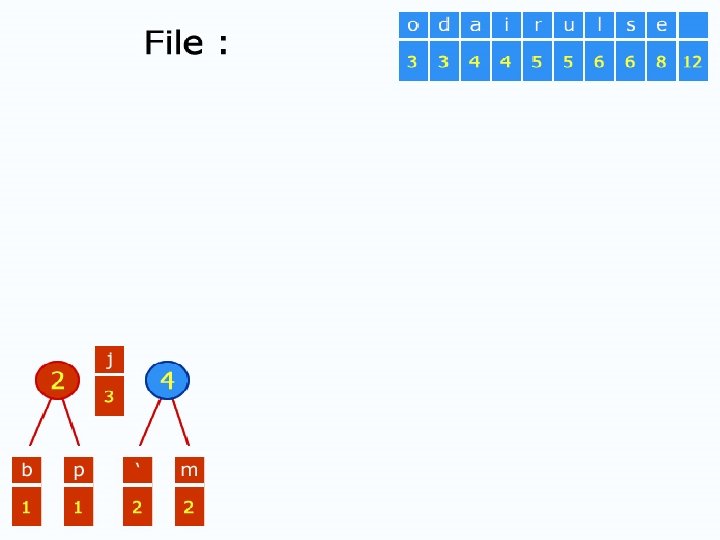
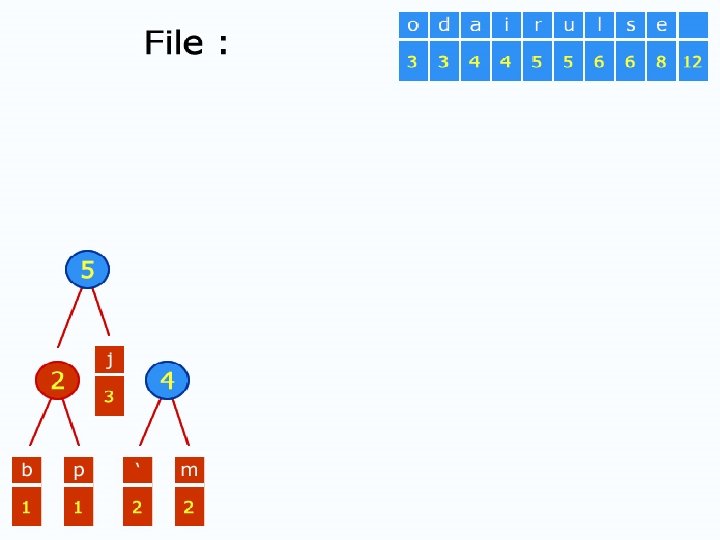
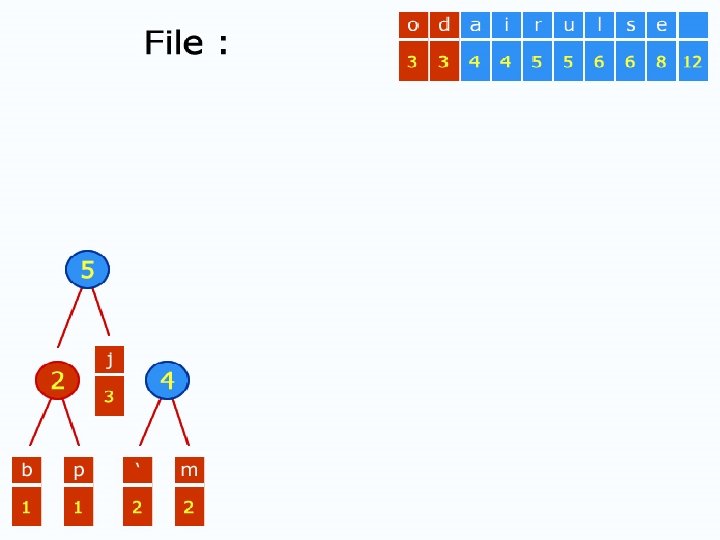
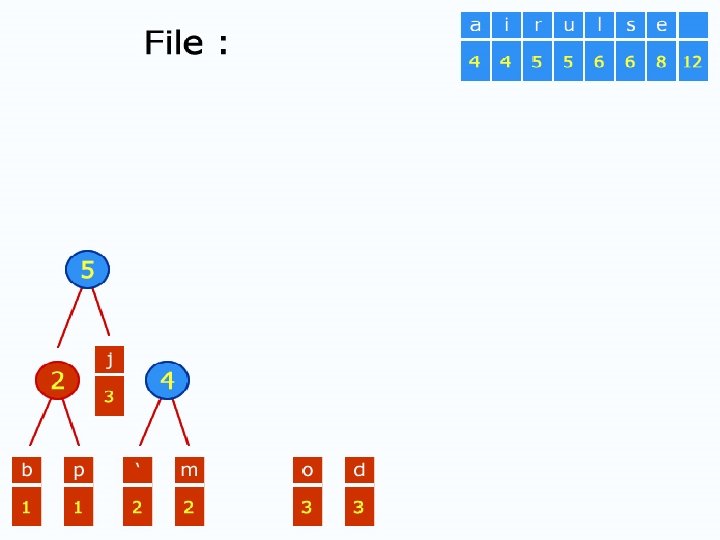
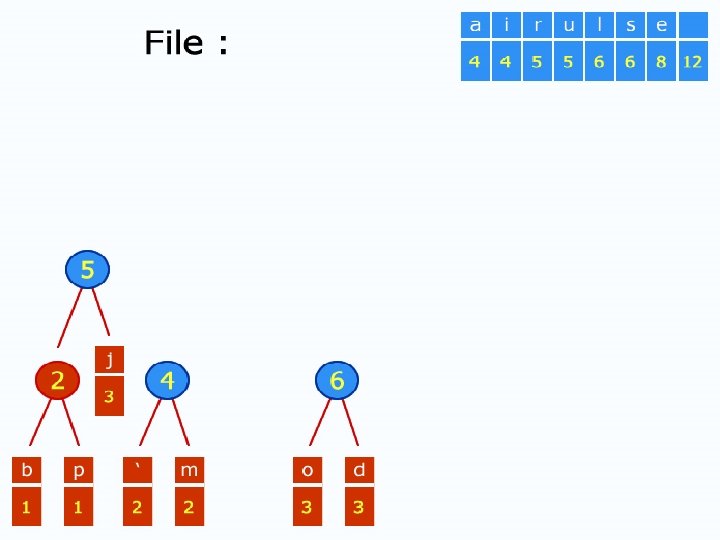
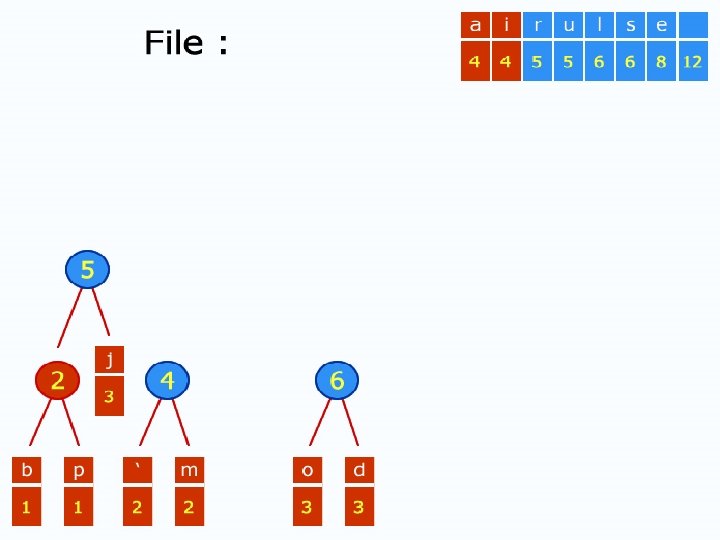
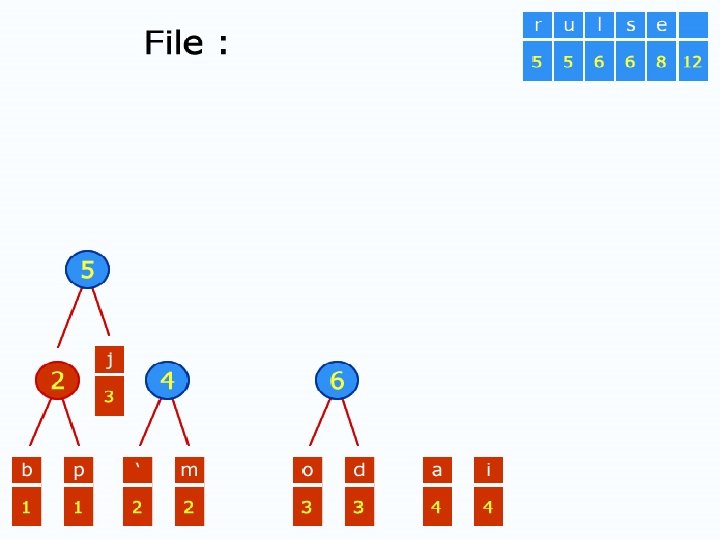
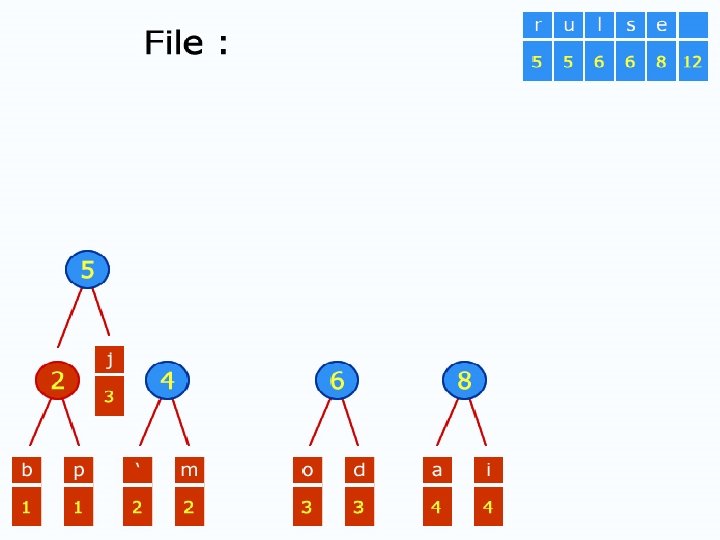
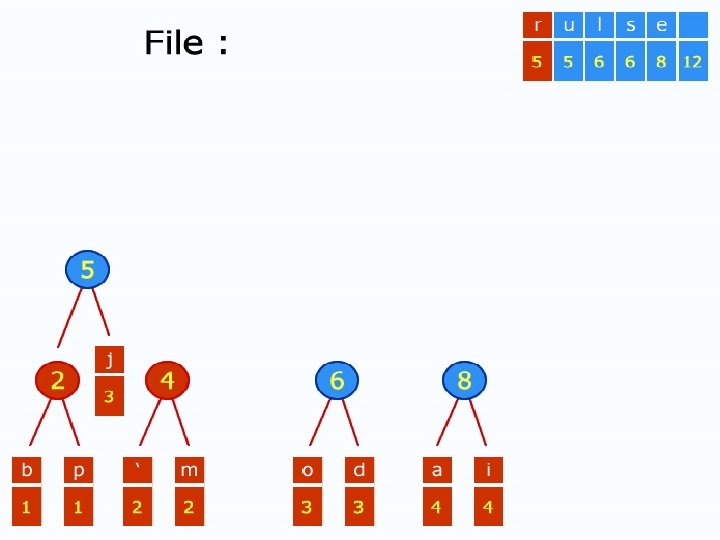
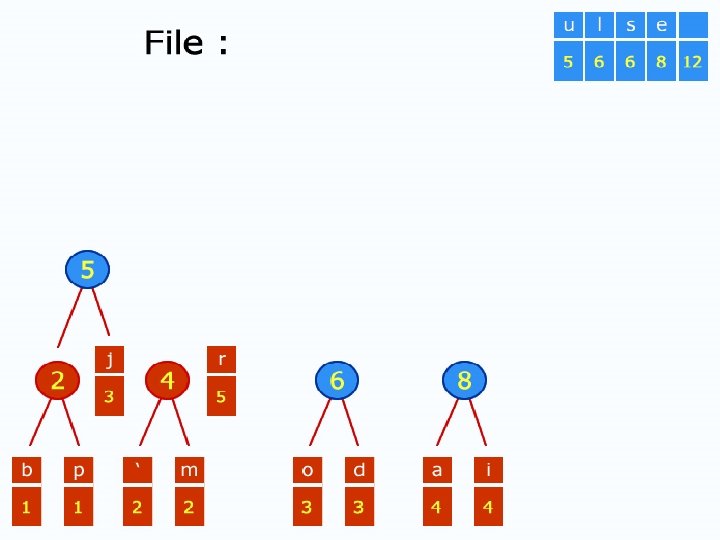
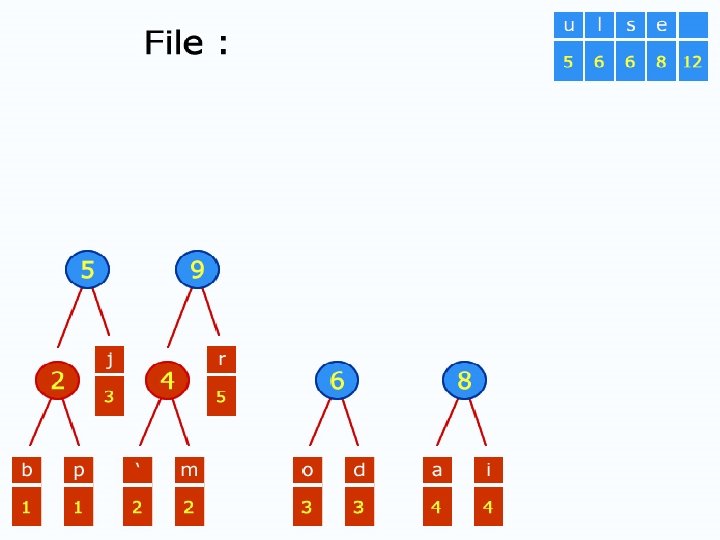
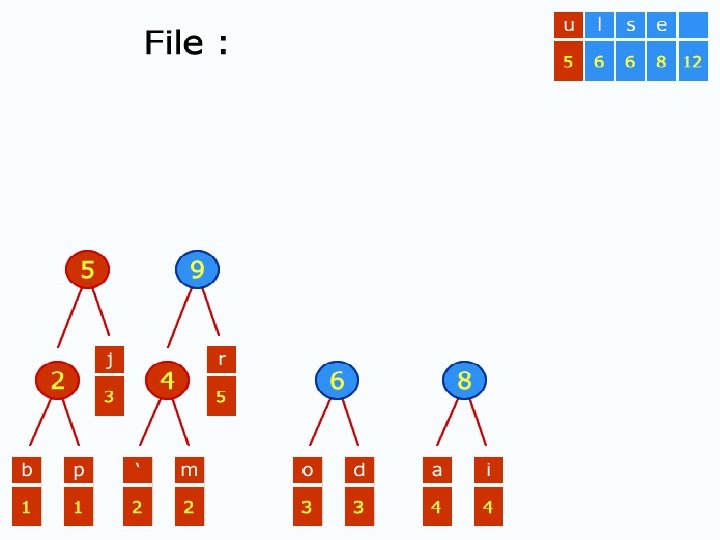
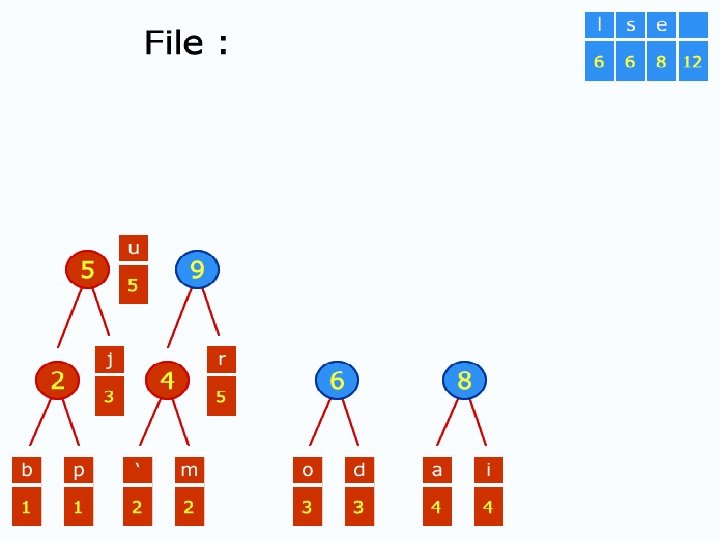
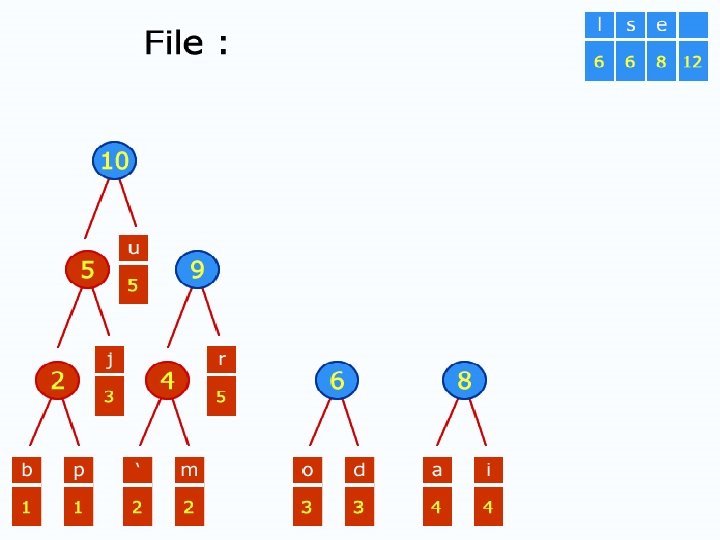
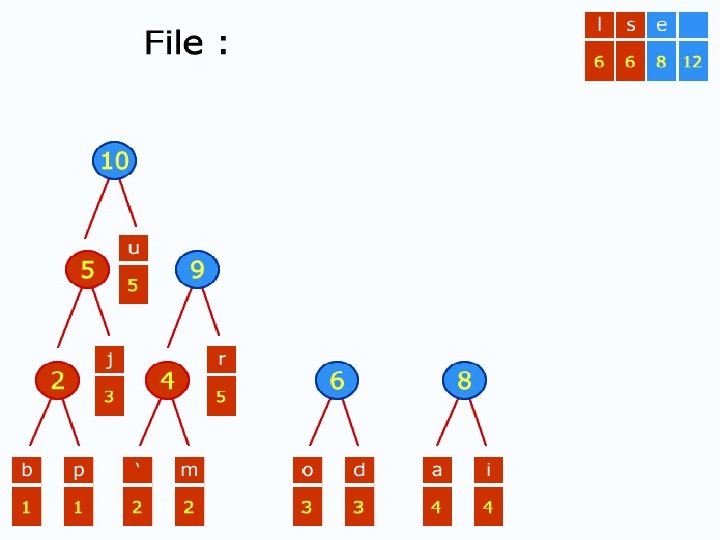
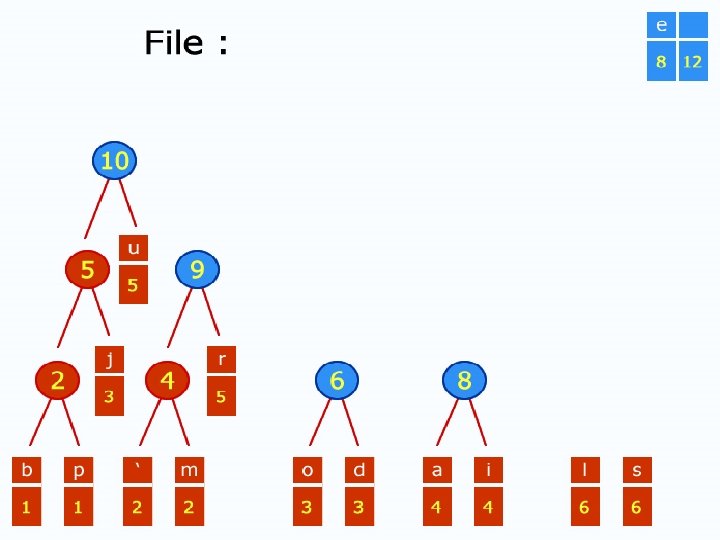
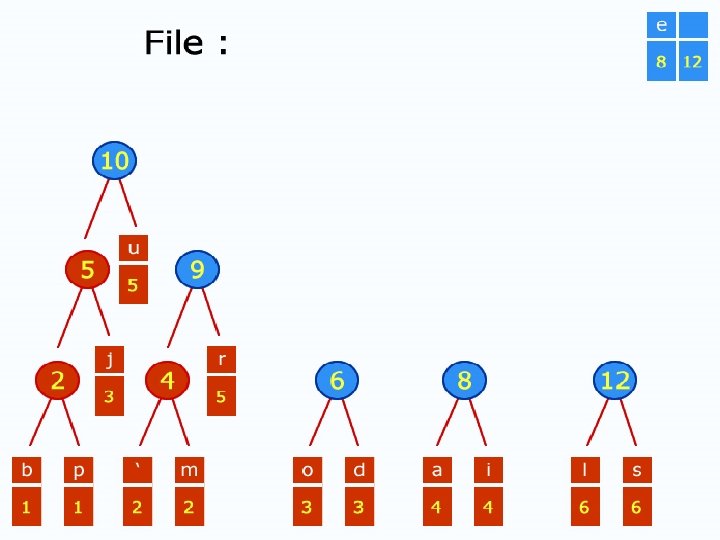
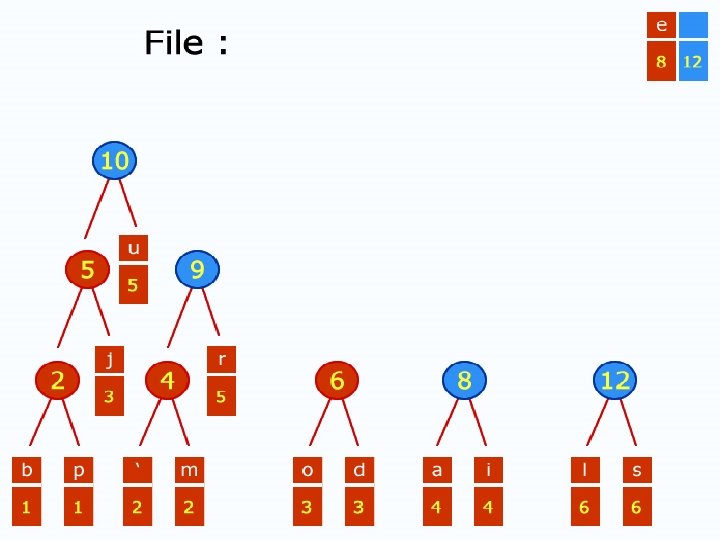
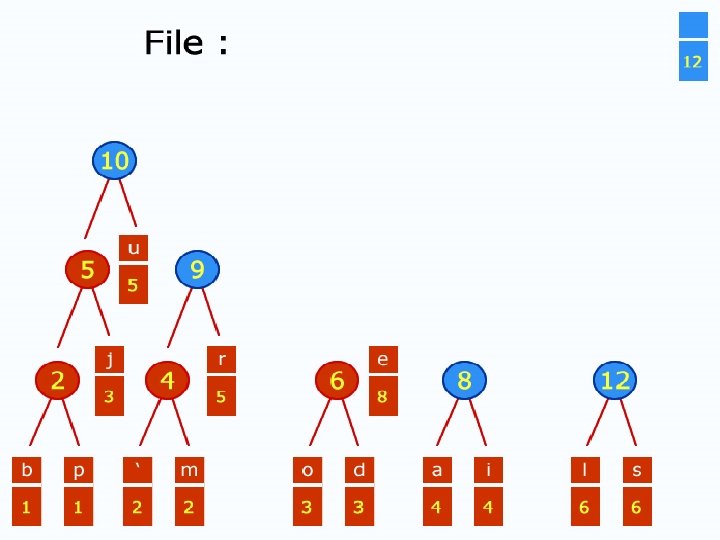
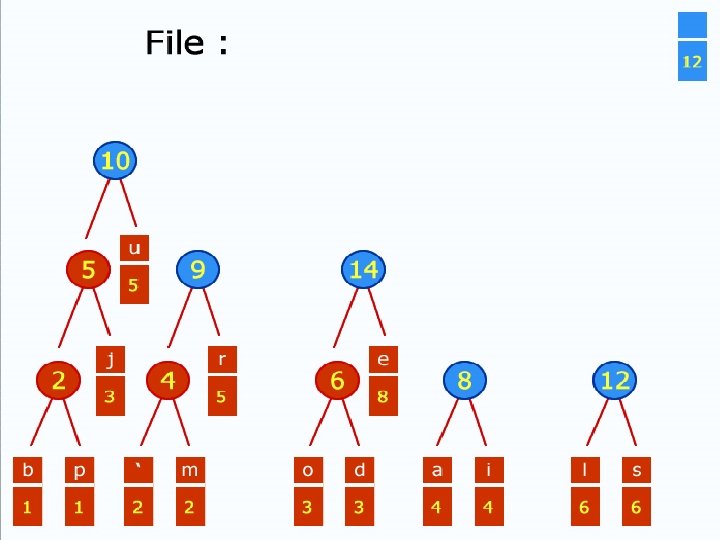
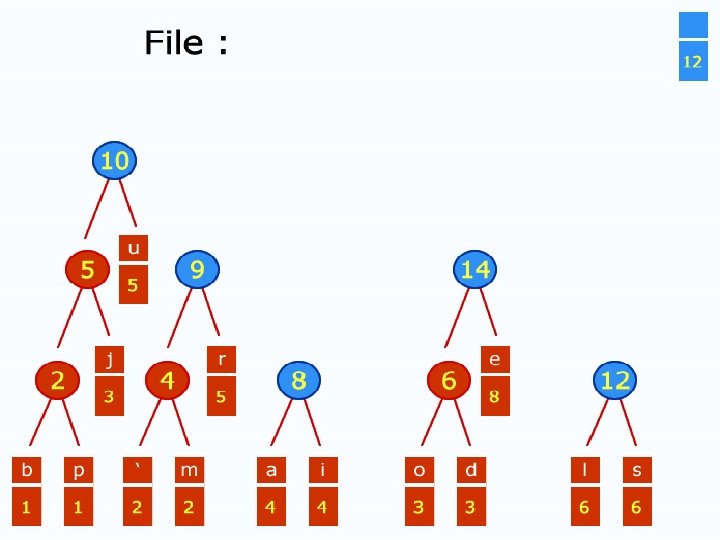
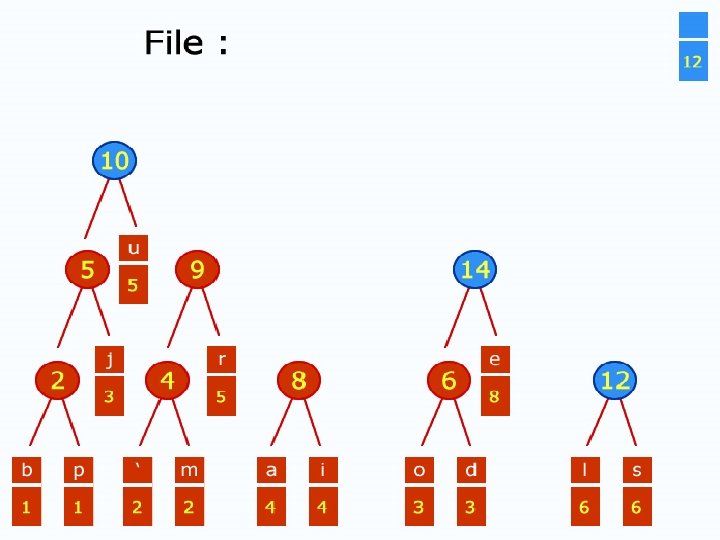
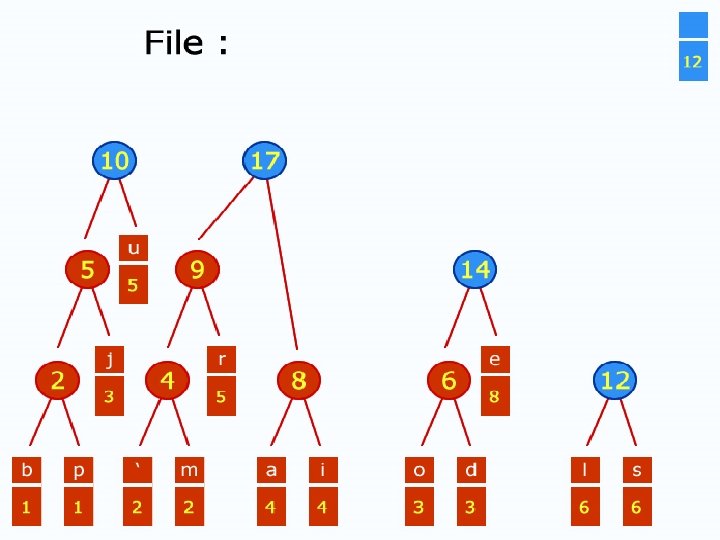
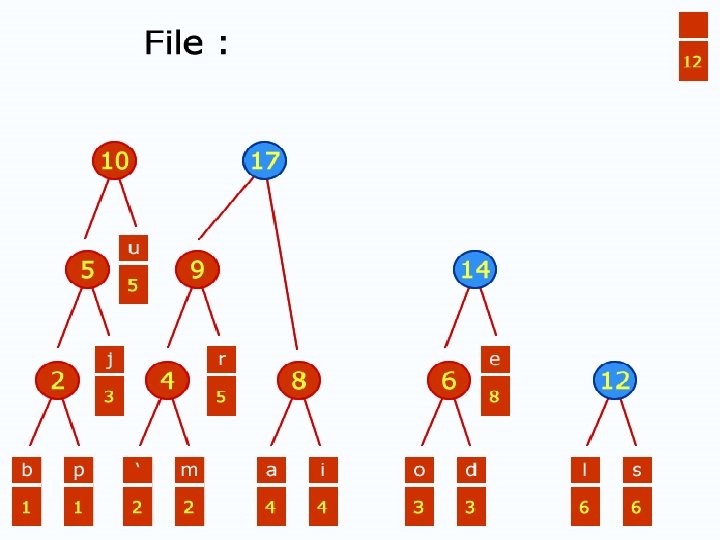
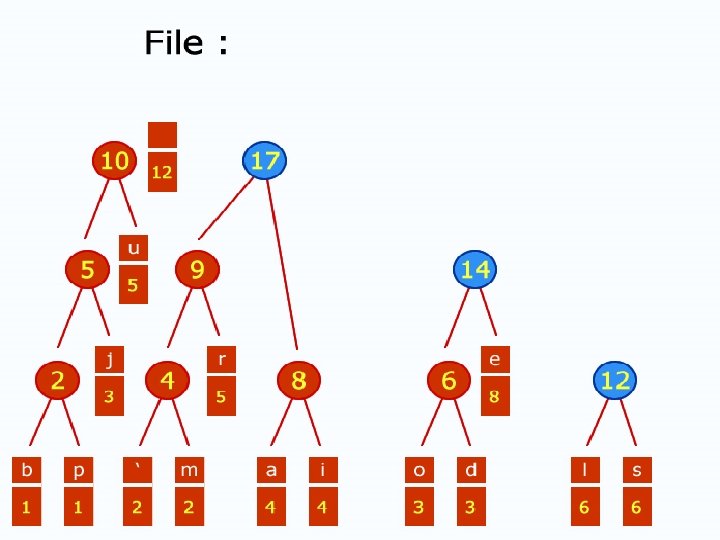
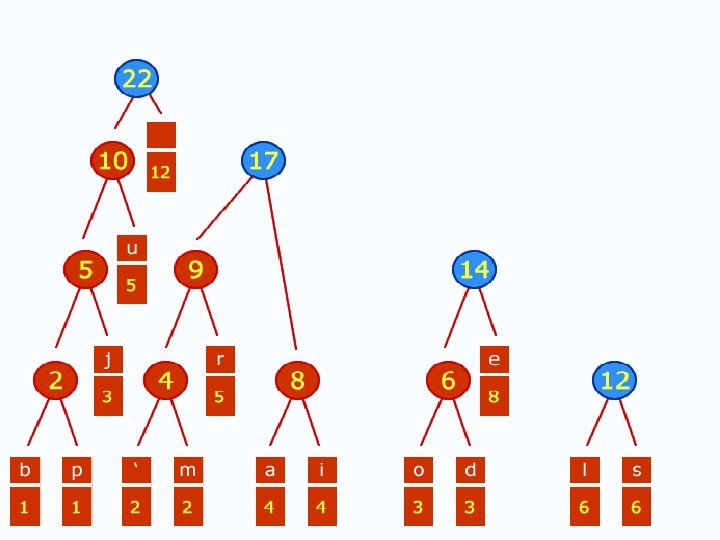
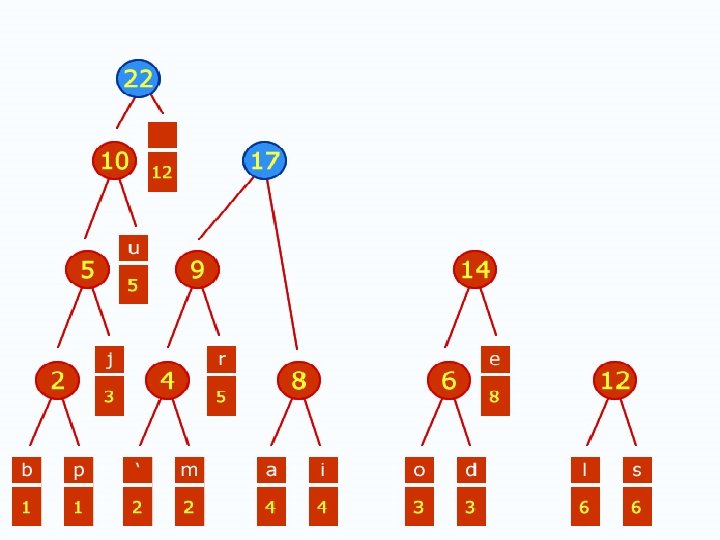
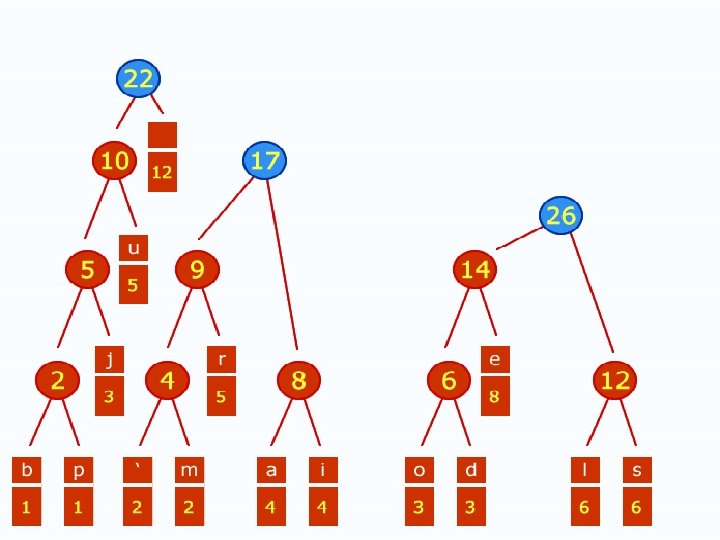
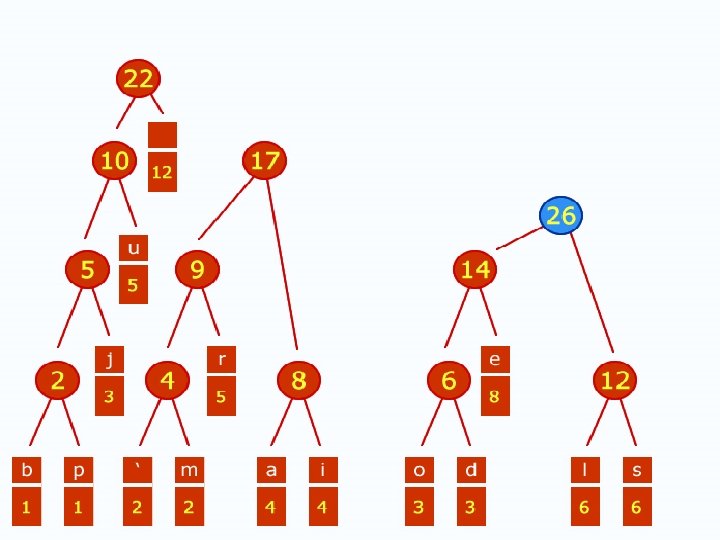
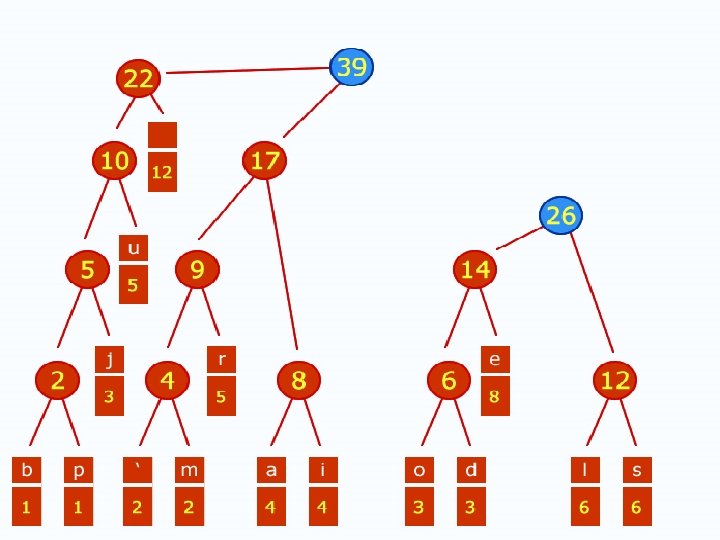
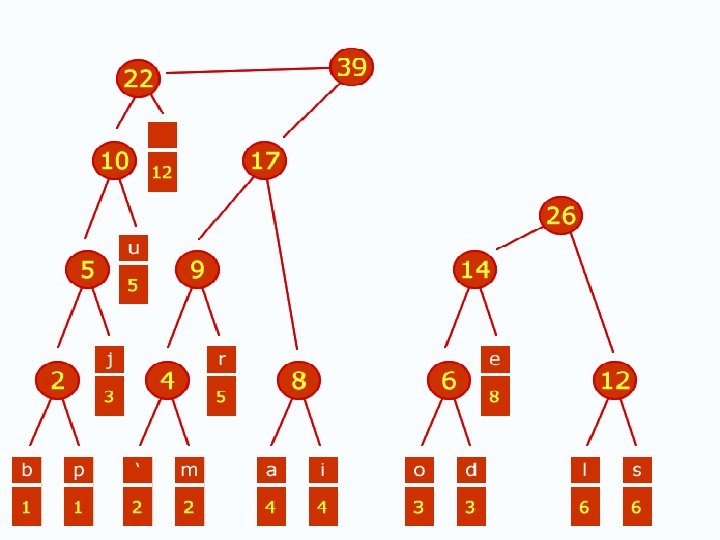
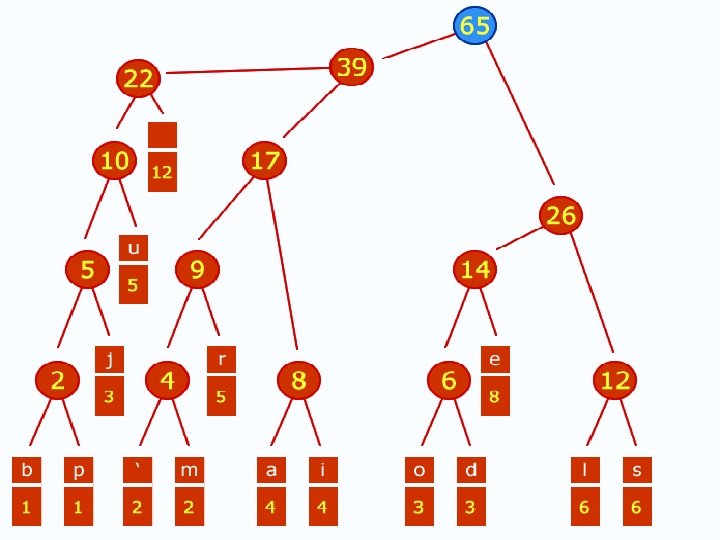
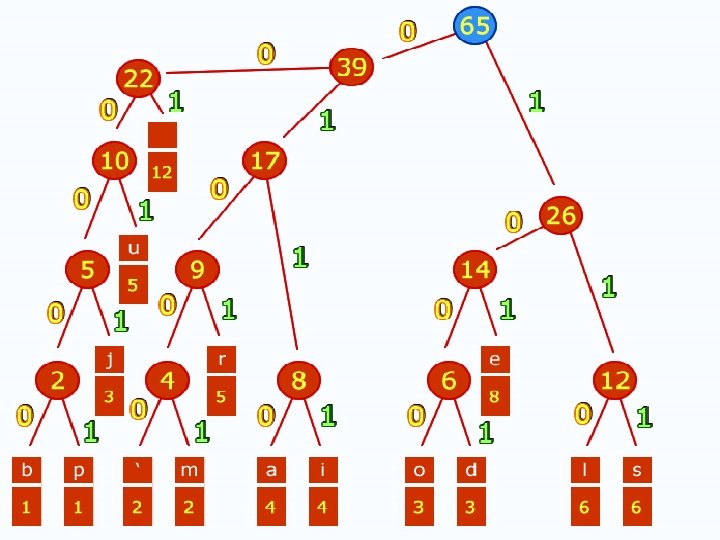
A Huffman kódok egy fa felrajzolásából kapjuk: 1. 2. 3. 4. 5. Kiválasztjuk a két legkisebb előfordulási valószínűséggel rendelkező elemet, és egymás mellé írjuk a két előfordulási valószínűségi értéket. Majd ezt a két értéket levélként kezelve, az összegüket csomópontként a két levél fölé írjuk. Ezek után kiválasztjuk a harmadik legkisebb valószínűségű elemet, és megnézzük, hogy ennek értéke kisebb-e, mint a csomópont, amiben a két legkisebb valószínűségű elem összege van. Ha kisebb, akkor az említett csomóponttól jobbra, ha nagyobb, akkor a csomóponttól balra írjuk le a gyakorisági értéket, majd a többi elem valószínűségi értékét is ez alapján helyezzük el a fában, míg a gyökérig el nem jutunk (100%, vagy arányoknál a nevező értéke). Ekkor az egy csomópontból balra kiinduló ágra 1 -est, a jobbra kiindulóra pedig 0 -át írunk, és az egyes elemekhez vezető útvonal alapján felírjuk a kódot.
Az algoritmus pontos leírása: • Legyenek a gyakoriságok: f 1 ≤ f 2≤. . . ≤ fn. • Ameddig a sorozat nem üres, végezzük el a következőket: • Amennyiben nem létezik az f 1 és f 2 címkéjű csúcs (egyike vagy mindkettő), hozzuk azt létre. • Hozzuk létre az f 1 + f 2 címkéjű csúcsot, amely legyen az előbbi két csúcs szülője, azaz kössük össze a szülőcsúcsot az előbbi kettővel egy-egy éllel. • Töröljük ki a sorozatból az f 1 és f 2 értékeket, és szúrjuk be a megfelelő helyre ezek összegét úgy, hogy a sorozat növekvő maradjon. Az így kapott sorozatot jelöljük továbbra is az f 1 ≤ f 2≤. . . módon. • Az eredményül kapott bináris fa éleit címkézzük meg a fentebb leírt módon, megkapva ezáltal az egyes karakterek kódját. Ha az i-edik levél gyökértől mért távolságát -vel jelöljük, akkor a Huffman-algoritmus által kapott fa esetében a összeg a lehető legkisebb. Ez biztosítja, hogy egy szöveg kódolása rövidebb lesz, mintha azonos hosszúságú kódot használtunk volna. Tulajdonképpen, bármilyen más kódolást használva, ennél jobb eredményt nem lehet elérni. A visszakódolást az teszi lehetővé, hogy egyik kód sem előszelete (prefixe, prefixuma) a többi kódnak. Így egy szövegben az első olyan kezdőszelet, amelyik egyenlő egy kóddal, egyértelműen meghatározza a kódolt karaktert
Eredményes tanulást !
- Slides: 45