
HK 07 Les 6 Toepassingen van verborgen Markov
HK 07 – Les 6 Toepassingen van verborgen Markov modellen Yves Moreau 3 de jr. Burg. Ir. Elektrotechniek Dataverwerking & Automatisatie 2001 -2002
Toepassingen van verborgen Markov modellen n Profiel-HMMs n n Schatting Databanksearch Alignering Genvoorspelling n n Elementen voor genvoorspelling Prokaryoten vs. eukaryoten Genvoorspelling via homologie GENSCAN
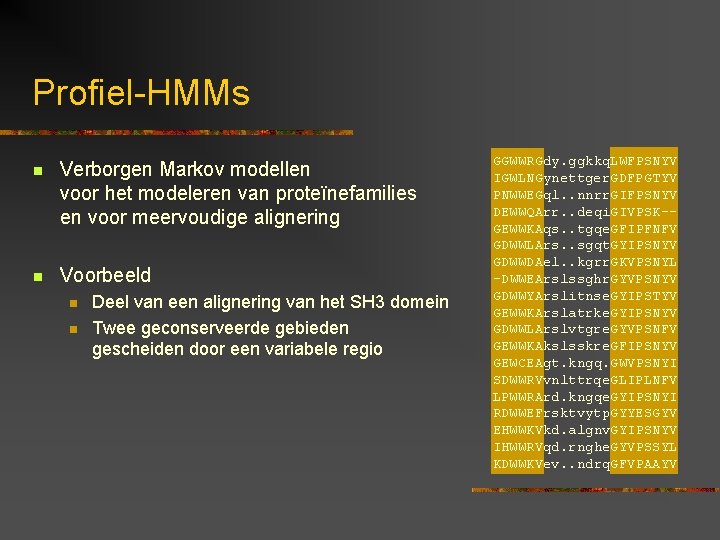
Profiel-HMMs n Verborgen Markov modellen voor het modeleren van proteïnefamilies en voor meervoudige alignering n Voorbeeld n n Deel van een alignering van het SH 3 domein Twee geconserveerde gebieden gescheiden door een variabele regio GGWWRGdy. ggkkq. LWFPSNYV IGWLNGynettger. GDFPGTYV PNWWEGql. . nnrr. GIFPSNYV DEWWQArr. . deqi. GIVPSK-GEWWKAqs. . tgqe. GFIPFNFV GDWWLArs. . sgqt. GYIPSNYV GDWWDAel. . kgrr. GKVPSNYL -DWWEArslssghr. GYVPSNYV GDWWYArslitnse. GYIPSTYV GEWWKArslatrke. GYIPSNYV GDWWLArslvtgre. GYVPSNFV GEWWKAkslsskre. GFIPSNYV GEWCEAgt. kngq. GWVPSNYI SDWWRVvnlttrqe. GLIPLNFV LPWWRArd. kngqe. GYIPSNYI RDWWEFrsktvytp. GYYESGYV EHWWKVkd. algnv. GYIPSNYV IHWWRVqd. rnghe. GYVPSSYL KDWWKVev. . ndrq. GFVPAAYV
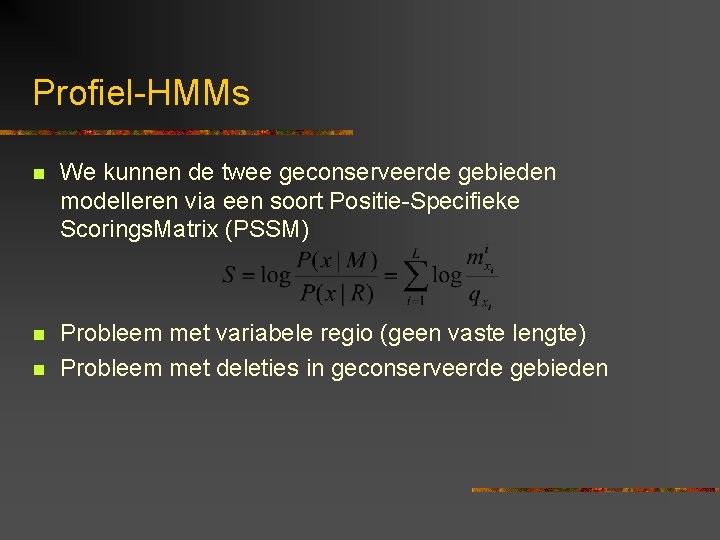
Profiel-HMMs n We kunnen de twee geconserveerde gebieden modelleren via een soort Positie-Specifieke Scorings. Matrix (PSSM) n Probleem met variabele regio (geen vaste lengte) Probleem met deleties in geconserveerde gebieden n
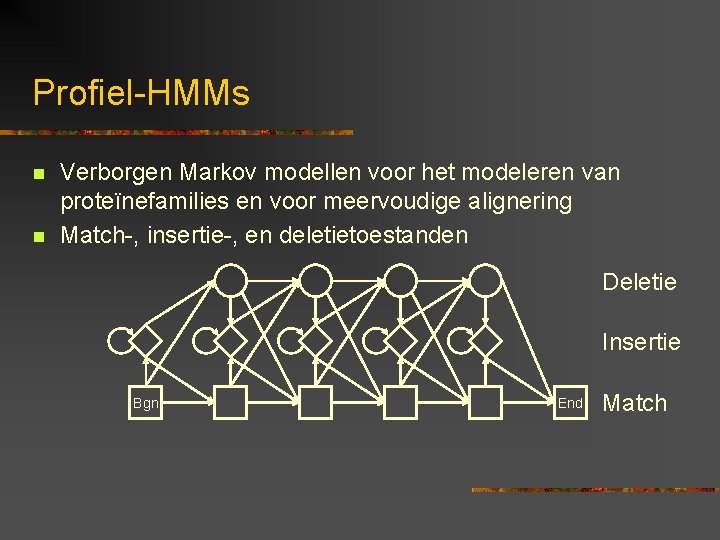
Profiel-HMMs n n Verborgen Markov modellen voor het modeleren van proteïnefamilies en voor meervoudige alignering Match-, insertie-, en deletietoestanden Deletie Insertie Bgn End Match
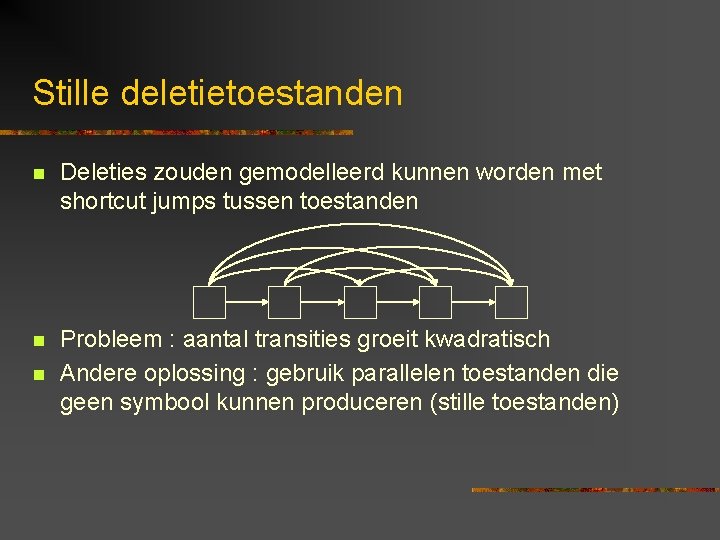
Stille deletietoestanden n Deleties zouden gemodelleerd kunnen worden met shortcut jumps tussen toestanden n Probleem : aantal transities groeit kwadratisch Andere oplossing : gebruik parallelen toestanden die geen symbool kunnen produceren (stille toestanden) n
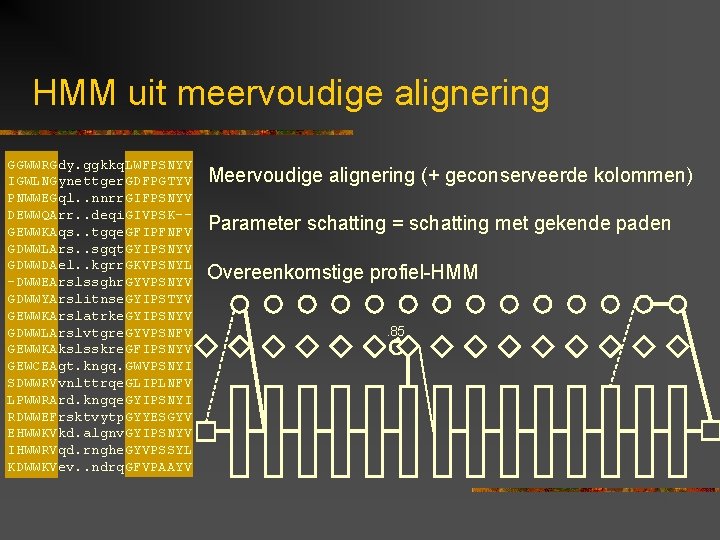
HMM uit meervoudige alignering GGWWRGdy. ggkkq. LWFPSNYV IGWLNGynettger. GDFPGTYV PNWWEGql. . nnrr. GIFPSNYV DEWWQArr. . deqi. GIVPSK-GEWWKAqs. . tgqe. GFIPFNFV GDWWLArs. . sgqt. GYIPSNYV GDWWDAel. . kgrr. GKVPSNYL -DWWEArslssghr. GYVPSNYV GDWWYArslitnse. GYIPSTYV GEWWKArslatrke. GYIPSNYV GDWWLArslvtgre. GYVPSNFV GEWWKAkslsskre. GFIPSNYV GEWCEAgt. kngq. GWVPSNYI SDWWRVvnlttrqe. GLIPLNFV LPWWRArd. kngqe. GYIPSNYI RDWWEFrsktvytp. GYYESGYV EHWWKVkd. algnv. GYIPSNYV IHWWRVqd. rnghe. GYVPSSYL KDWWKVev. . ndrq. GFVPAAYV Meervoudige alignering (+ geconserveerde kolommen) Parameter schatting = schatting met gekende paden Overeenkomstige profiel-HMM. 85
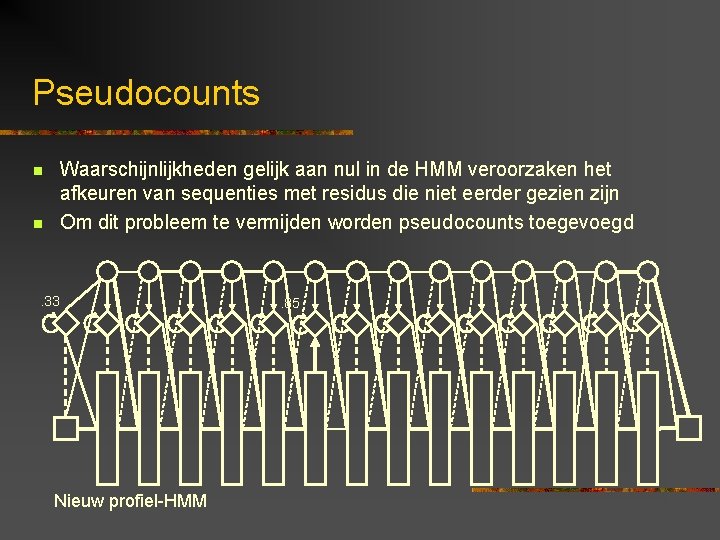
Pseudocounts Waarschijnlijkheden gelijk aan nul in de HMM veroorzaken het afkeuren van sequenties met residus die niet eerder gezien zijn Om dit probleem te vermijden worden pseudocounts toegevoegd n n . 33 Nieuw profiel-HMM . 85
Databanksearch met profiel-HMMs n n n Het geschatte model kan gebruikt worden om nieuwe leden van de proteïnefamilie op te sporen in een sequentiedatabank Voor iedere sequentie in de databank wordt P(x, p* | M) (Viterbi) of P(x | M) (voorwaarts-achterwaarts) berekend In de praktijk worden log odds berekend (t. o. v. het random model P(x | R))
Alignering met profiel-HMMs n Via Viterbi (zoeken naar het beste aligneringspad) kunnen sequenties gealigneerd worden t. o. v. een profiel. HMM n n Trainingsequenties Databankmatches
Meervoudige alignering met profiel-HMM n n Indien de sequenties niet gealigneerd zijn is het toch mogelijk een profiel-HMM te trainen Initialisatie : kies de lengte van de profiel-HMM n n Training : schat het model via Viterbi training of Baum. Welch training n n Lengte van profiel-HMM is aantal matchtoestand sequentielengte Heuristieken om lokale minimas te voorkomen Meervoudige alignering : gebruik Viterbi decoding om de sequenties te aligneren
Uitbreidingen n Meer gesofisticeerde pesudocounts kunnen gebruikt worden n Aligneringsvarianten zijn mogelijk n n n Dirichlet mengelingen Substitutiematrixmengelingen Locale alignering Methoden zijn beschikbaar om de matchtoestanden vs. de insertietoestanden systematisch te bepalen Methoden zijn beschikbaar om sequenties te wegen in functie van evolutieafstanden
Software voor profiel-HMMs n SAM: University of California Santa Cruz n n n http: //www. cse. ucsc. edu/research/compbio/sam. html Web service: http: //www. cse. ucsc. edu/research/compbio/HMMapps/HMM-applications. html Hmmer (‘hammer’): Washington University, St. Louis n http: //genome. wustl. edu/eddy/hmmer. html
Proteïnefamilies n PFAM n n http: //www. sanger. ac. uk/Software/Pfam/search. shtml Verzameling van proteïnefamilies en proteïnedomeinen n Meervoudige aligneringen van de proteïnefamilies t. o. v. hun domeinen Domeinorganizatie van proteïnen die worden gematched aan een familie Profiel-HMMs van de domeinen
Genvoorspelling
Overzicht n n Elementen voor genvoorspelling Prokaryoten vs. eukaryoten Genvoorspelling via homologie GENSCAN
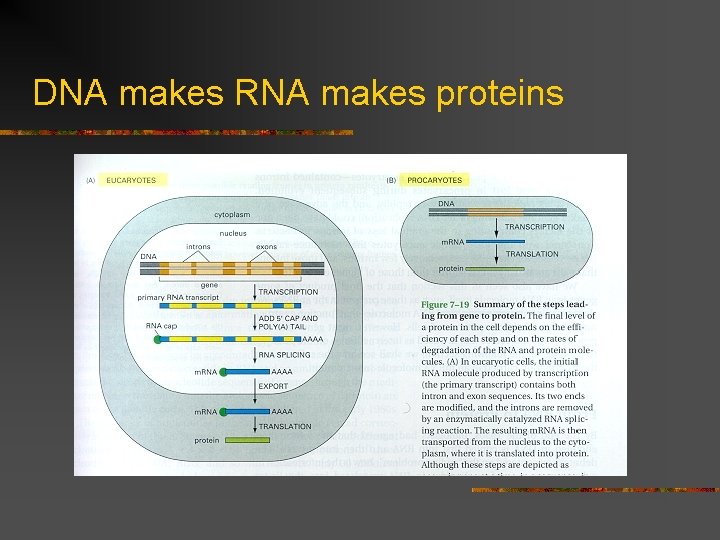
DNA makes RNA makes proteins
Elementen voor genvoorspelling n Moeilijk probleem n n n Prokaryoten vs. eukaryoten n Hogere densiteit van genen in prokaryoten Geen intronen in prokaryoten Aanwijzingsbronnen (positief en negatief) n n n Genomische signalen zijn gedegenereerd Sequentiefouten Similariteit met features die coderende gebieden meestal niet overlappen (e. g. , Alu repeats) Sequentie similariteit met gekende genen (e. g. , gevonden via BLASTX) Statistische maat van codonvoorkeur Templatematches met functionele lokaties (e. g. , splice site) De voorspelde structuur moet de biologische grammatica respecteren (promotor, exon, intron, . . . )
‘Search by signal vs. search by content’ n Search by signal n n Search by content n n Opsporing van korte signalen in het genoom e. g. , splice site, kernpromotor Positiegewichtsmatrices en neurale netwerken zijn hier bruikbaar Opsporing van specifieke uitgestrekte gebieden op basis van uitgemiddelde frequenties e. g. , coderende gebieden, Cp. G eilanden Verborgen Markov modellen zijn hier bruikbaar Genevoorspellingsalgoritmes combineren beiden standpunten
Probabilistische modellering vs. homologie n Verborgen Markov modellen kunnen gebruikt worden voor genvoorspelling n Homologie van een sequentie met een gekend gen geeft ook een sterke aanwijzing voor het bestaan van een gen in deze sequentie n Genvoorspelling kan de twee aanpakken combineren
Problemen : prokaryoten n Korte genen zijn moeilijk te detecteren Operonen Overlappende genen
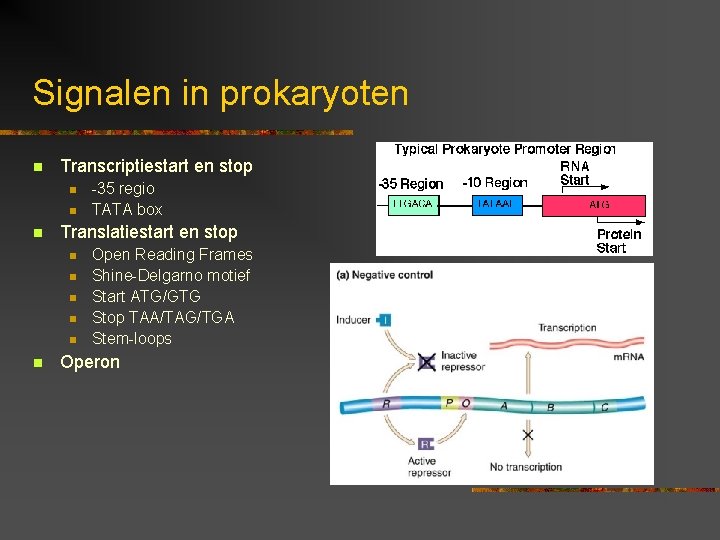
Signalen in prokaryoten n Transcriptiestart en stop n n n Translatiestart en stop n n n -35 regio TATA box Open Reading Frames Shine-Delgarno motief Start ATG/GTG Stop TAA/TAG/TGA Stem-loops Operon
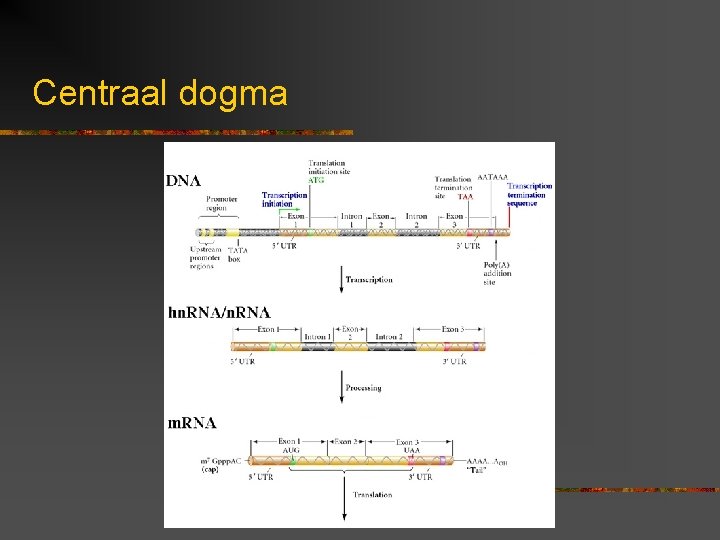
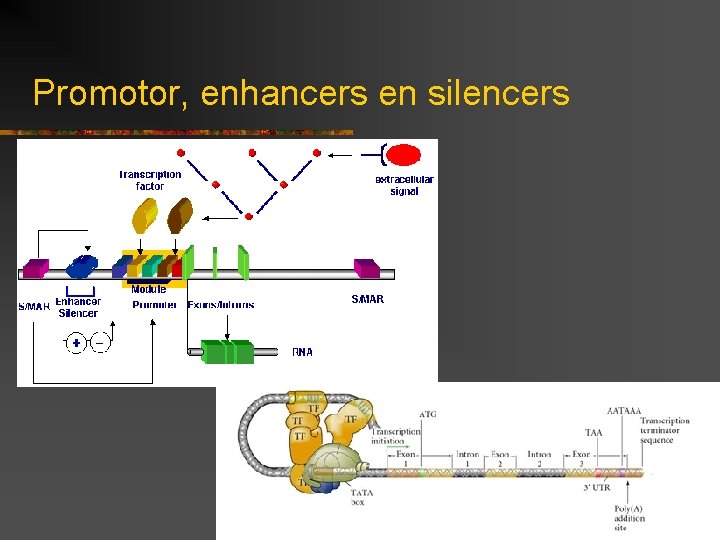
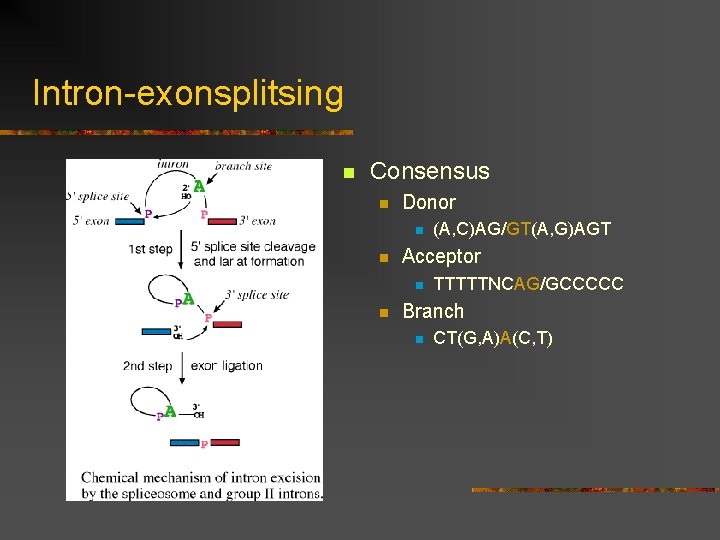
Signalen in eukaryoten n n Transcriptie Promotor/enhancer/silencer TATA box Introns/exons n n n poly. A Repeats n n n Donor/acceptor/branch Alu, satelieten, expansies Cp. G eilanden Cap/CCAAT&GC boxes n n n Translation 5’ and 3’ UTR Kozak consensus Start ATG Stop TAA/TAG/TGA
Centraal dogma
Promotor, enhancers en silencers
Intron-exonsplitsing n Consensus n Donor n n Acceptor n n (A, C)AG/GT(A, G)AGT TTTTTNCAG/GCCCCC Branch n CT(G, A)A(C, T)
Probleem : alternatieve splitsing
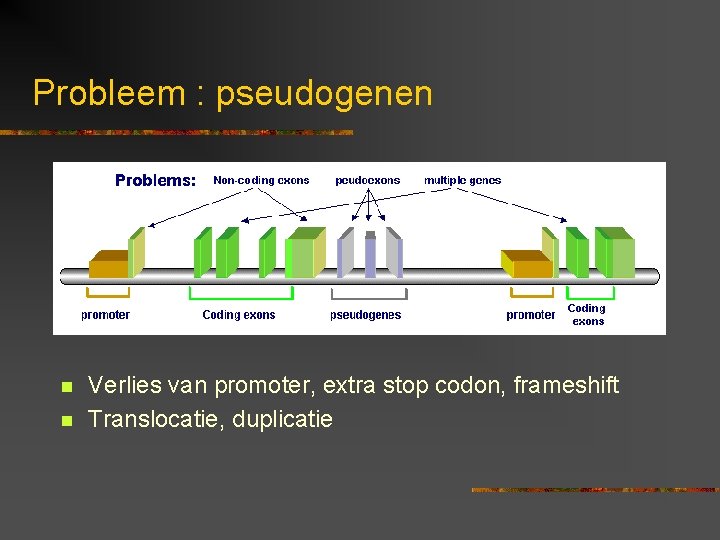
Probleem : pseudogenen n n Verlies van promoter, extra stop codon, frameshift Translocatie, duplicatie
Probleem : RNA genen n n r. RNA (ribosoom) t. RNA (transfer) sn. RNA (splitsing) tm. RNA (telomerase)
Genvoorspelling via homologie
Genvoorspelling via homologie n n Coderende gebieden evolueren trager dan niet coderende gebied (geconserveerd door natuurlijke selectie omwille van hun functionele rol) Niet enkel de proteïnesequentie maar ook de genstructuur kan geconserveerd zijn Gebruik van standard homologiemethoden Gensyntax moet gerespecteerd worden
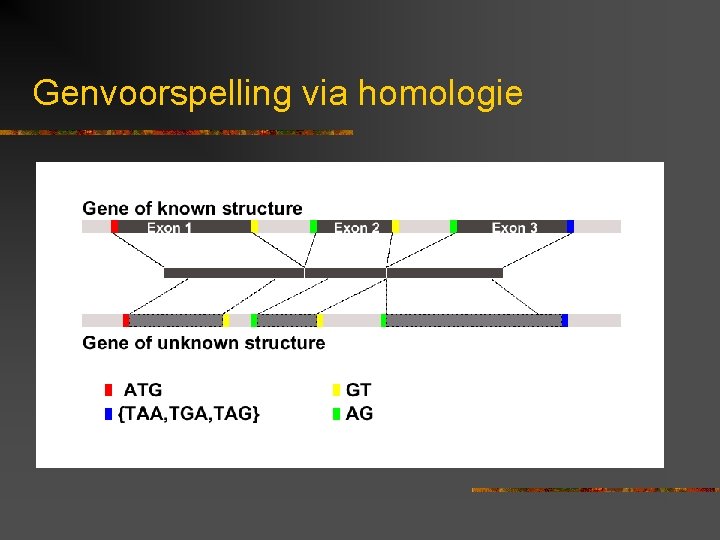
Genvoorspelling via homologie
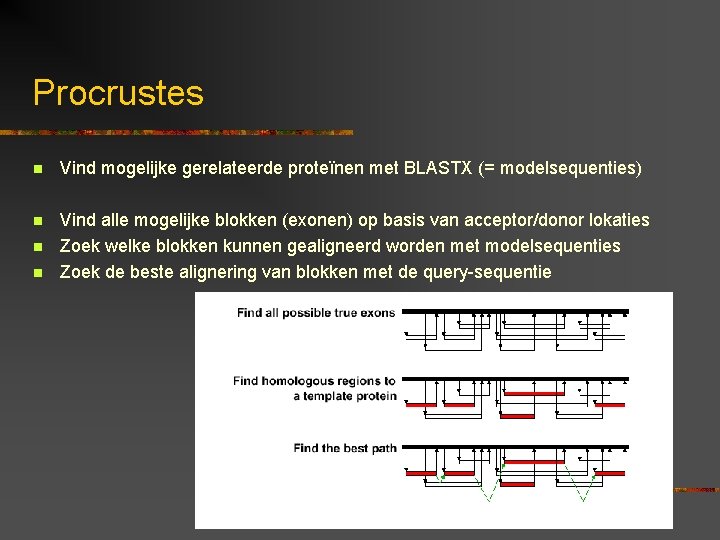
Procrustes n Vind mogelijke gerelateerde proteïnen met BLASTX (= modelsequenties) n Vind alle mogelijke blokken (exonen) op basis van acceptor/donor lokaties Zoek welke blokken kunnen gealigneerd worden met modelsequenties Zoek de beste alignering van blokken met de query-sequentie n n
Genvoorspelling via homologie n Voordelen n Erkenning van korte exonen en atypische exonen Juiste assemblage van complexe genen (> 10 exonen) Nadelen n Genen zonder gekenden homologen worden gemist Goede homologen nodig voorspelling van genstructuur Zeer gevoelig voor sequentiefouten
GENSCAN
GENSCAN n GENSCAN werd gebruikt voor de annotatie van het menselijk genoom in het Human Genome Project n Genvoorspelling m. b. v. verborgen semi-Markov modellen (Hidden Semi-Markov Model) n Verschillende modellen in functie van GC-inhoud (<43% G+C, 43 -50%, 50 -57%, >57%)
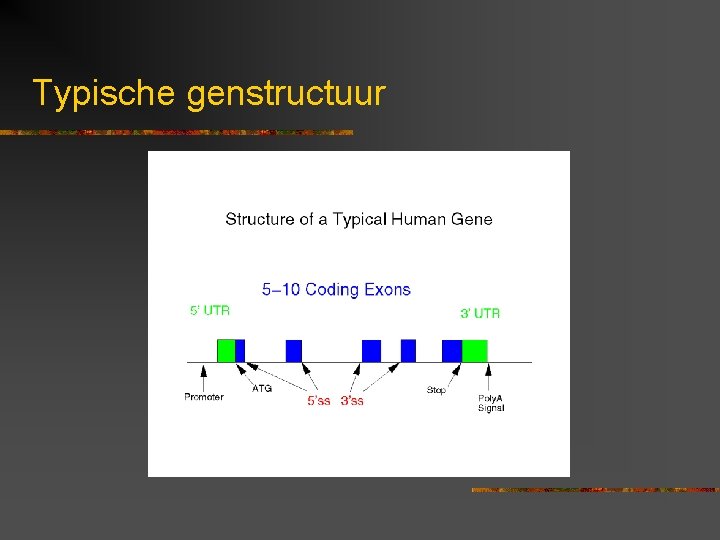
Typische genstructuur
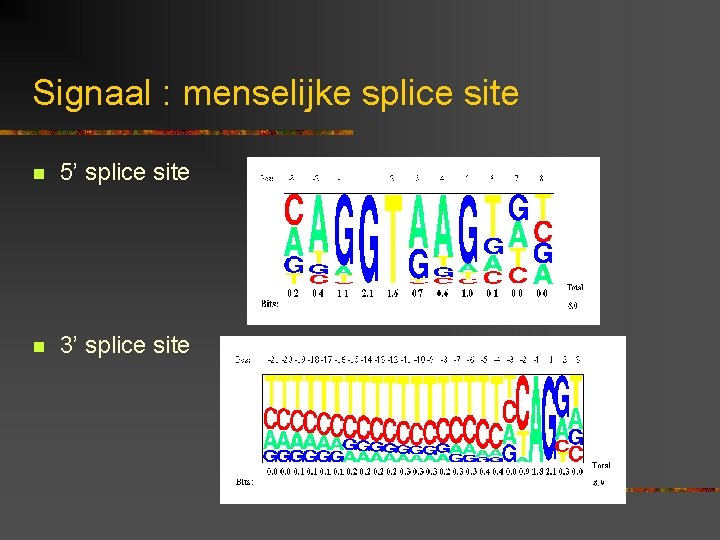
Signaal : menselijke splice site n 5’ splice site n 3’ splice site
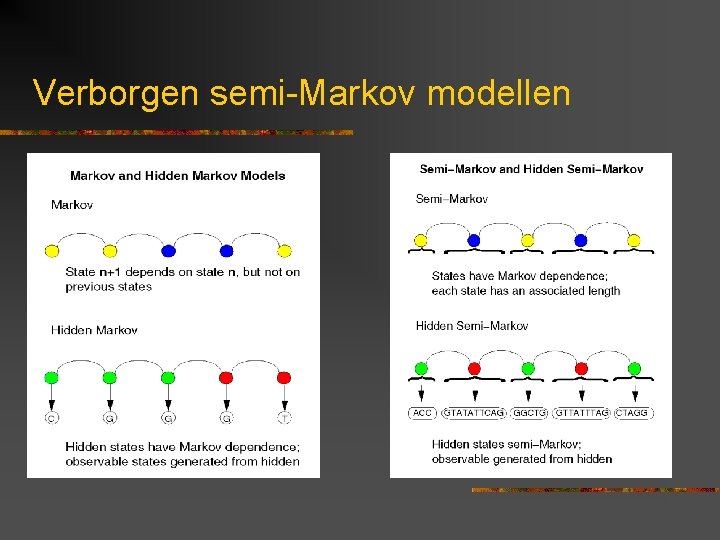
Verborgen semi-Markov modellen
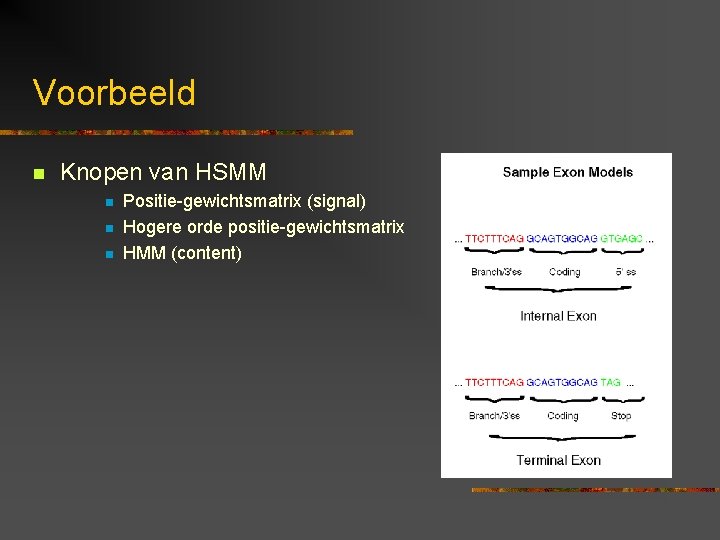
Voorbeeld n Knopen van HSMM n n n Positie-gewichtsmatrix (signal) Hogere orde positie-gewichtsmatrix HMM (content)
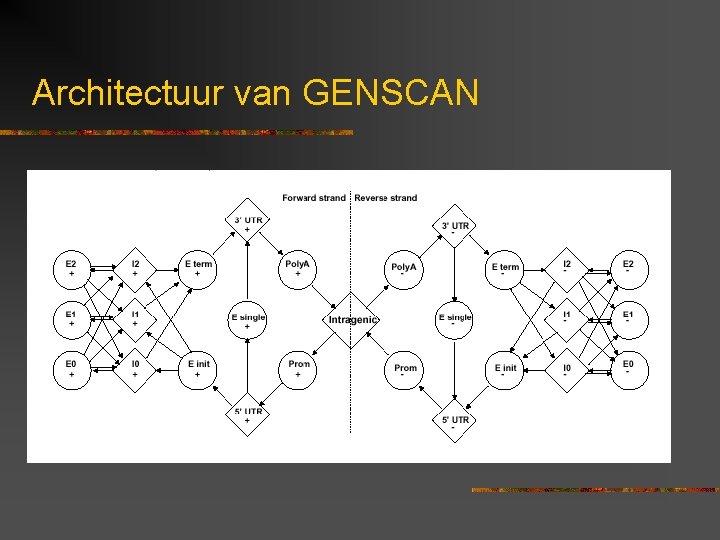
Architectuur van GENSCAN
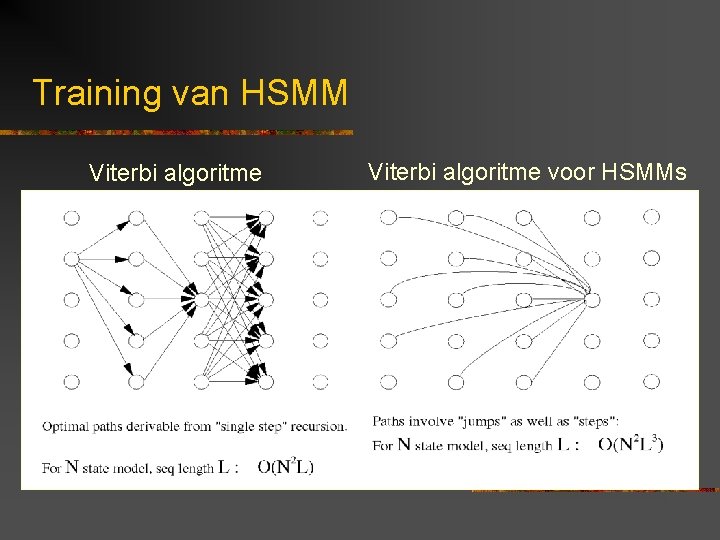
Training van HSMM Viterbi algoritme voor HSMMs
- Slides: 43