
GDR Statistique et Sant Journes 2007 26 et
- Slides: 43
GDR Statistique et Santé Journées 2007 - 26 et 27 novembre 2007 Recherche des facteurs génétiques de susceptibilité aux maladies en populations consanguines Emmanuelle Génin INSERM U 535, Univ. Paris Sud, Villejuif
Plan • Les populations consanguines – Consanguinité aléatoire et non aléatoire – La consanguinité dans le monde – Conséquences sur le plan génétique • Etudes de liaison génétique en populations consanguines – Validité des méthodes classiques – Les alternatives – Puissance des tests • Etudes d'association en populations consanguines – Validité des méthodes classiques – Les alternatives – Puissance des tests
Les populations consanguines • Dans de nombreuses populations humaines, les mariages entre individus apparentés sont fréquents – Grandes populations où ce type d'unions est favorisé
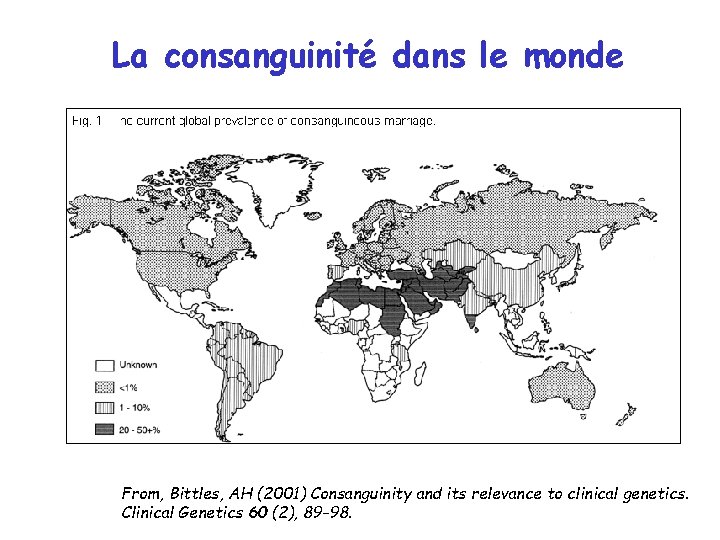
La consanguinité dans le monde From, Bittles, AH (2001) Consanguinity and its relevance to clinical genetics. Clinical Genetics 60 (2), 89 -98.
Les populations consanguines • Dans de nombreuses populations humaines, les mariages entre individus apparentés sont fréquents – Grandes populations où ce type d'unions est favorisé – Petites populations isolées où le nombre de conjoints potentiels est réduit • Populations à effet fondateur – un petit nombre d'ancêtres (les fondateurs) – une période d'isolement puis de croissance exponentielle • L'isolement peut être – géographique (Finlande, Québec, îles) – religieux (Hutterites, Juifs Ashkenazes) – culturel (Gitans, villages de pêcheurs)
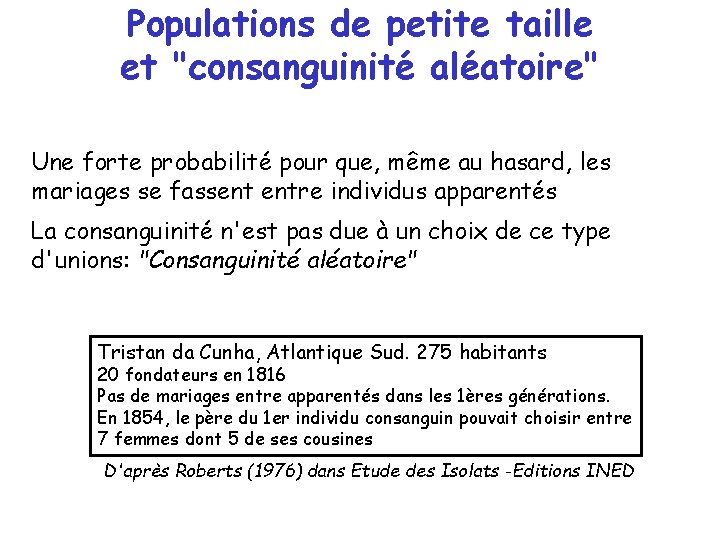
Populations de petite taille et "consanguinité aléatoire" Une forte probabilité pour que, même au hasard, les mariages se fassent entre individus apparentés La consanguinité n'est pas due à un choix de ce type d'unions: "Consanguinité aléatoire" Tristan da Cunha, Atlantique Sud. 275 habitants 20 fondateurs en 1816 Pas de mariages entre apparentés dans les 1ères générations. En 1854, le père du 1 er individu consanguin pouvait choisir entre 7 femmes dont 5 de ses cousines D'après Roberts (1976) dans Etude des Isolats -Editions INED
Conséquences génétiques de la consanguinité • Modification de la structure génétique de la population – augmentation des homozygotes – déficit en hétérozygotes • Possibilité pour un individu d'avoir reçu deux allèles provenant d'un même ancêtre (Identité-par-Descendance, IBD).
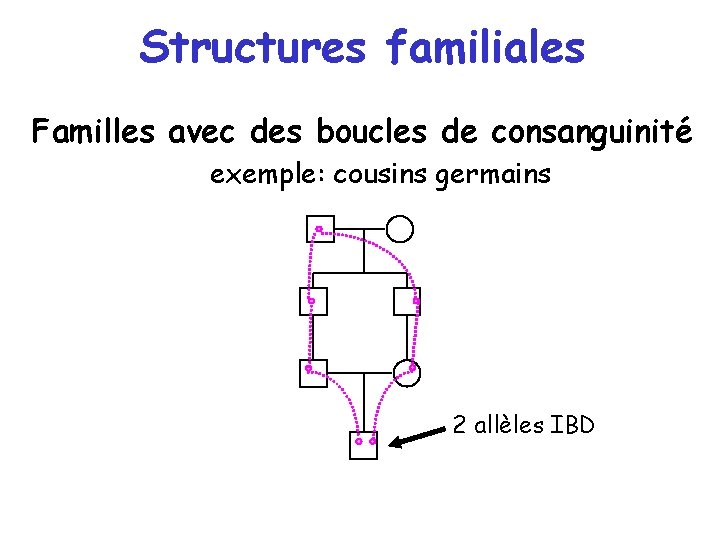
Structures familiales Familles avec des boucles de consanguinité exemple: cousins germains 2 allèles IBD
Coefficient de consanguinité • Coefficient de consanguinité F d'un individu: Probabilité pour que ses deux allèles à un locus soient IBD • Comment peut-on estimer F ? – à partir de la généalogie
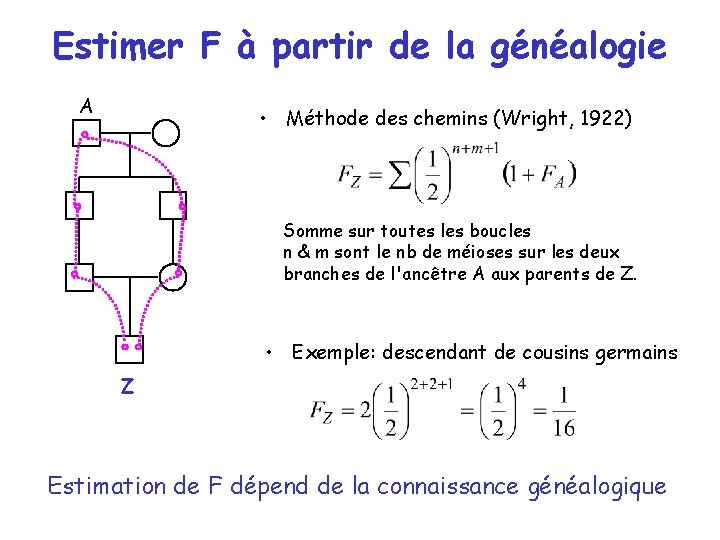
Estimer F à partir de la généalogie A • Méthode des chemins (Wright, 1922) Somme sur toutes les boucles n & m sont le nb de méioses sur les deux branches de l'ancêtre A aux parents de Z. • Exemple: descendant de cousins germains Z Estimation de F dépend de la connaissance généalogique
Coefficient de consanguinité • Coefficient de consanguinité F d'un individu: Probabilité pour que ses deux allèles à un locus soient IBD • Comment peut-on estimer F ? – à partir de la généalogie – à partir des marqueurs génétiques
Estimer F à partir des marqueurs Leutenegger et al (2003). Am J Hum Genet • Observation des génotypes pour des marqueurs régulièrement espacés sur le génome – IBD non observable – marqueurs non indépendants • Modèle de Markov caché pour écrire la probabilité de ces observations en fonction – deux paramètres inconnus F coeff. de consang. de l'individu (prop. de génome IBD) a taux de changement d'état IBD/c. M (long. des blocs IBD) – deux paramètres supposés connus • distance entre les marqueurs • fréquences alléliques è Estimation de (F, a) par maximum de vraisemblance Estimation de F dépend de la densité de marqueurs et des fréquences alléliques aux marqueurs
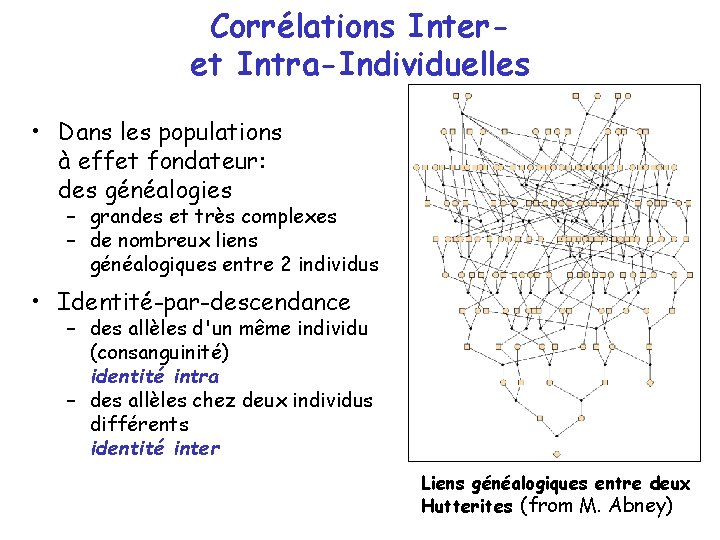
Corrélations Interet Intra-Individuelles • Dans les populations à effet fondateur: des généalogies – grandes et très complexes – de nombreux liens généalogiques entre 2 individus • Identité-par-descendance – des allèles d'un même individu (consanguinité) identité intra – des allèles chez deux individus différents identité inter Liens généalogiques entre deux Hutterites (from M. Abney)
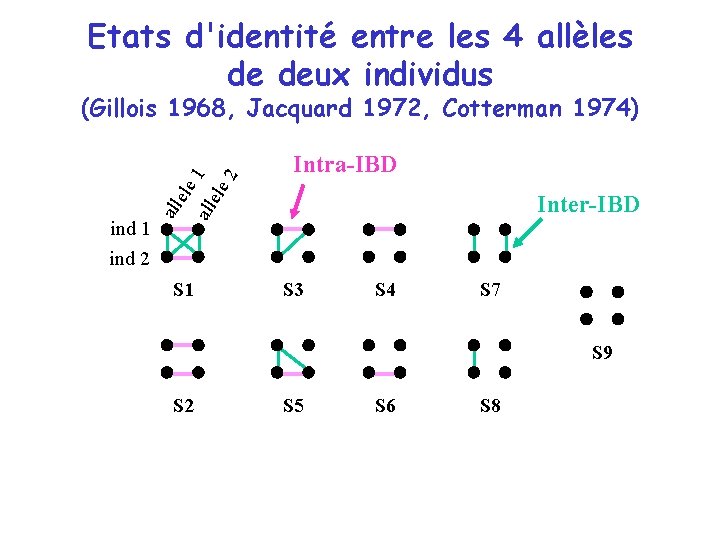
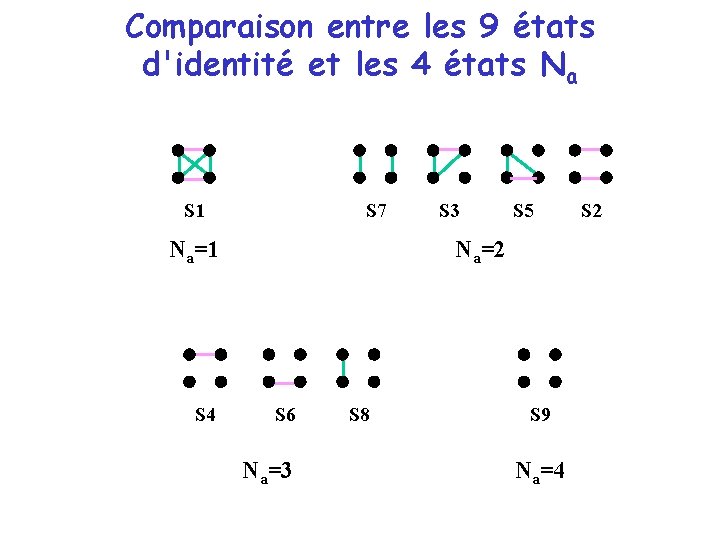
Etats d'identité entre les 4 allèles de deux individus Intra-IBD Inter-IBD all ind 1 ind 2 ele all 1 ele 2 (Gillois 1968, Jacquard 1972, Cotterman 1974) S 1 S 3 S 4 S 7 S 9 S 2 S 5 S 6 S 8
Les études génétiques en populations consanguines • Identification des mutations impliquées dans les maladies monogéniques – récessives (grandes populations ou isolats) "Homozygosity Mapping" – dominantes (isolats / effet fondateur) • Etude des gènes impliqués dans les maladies complexes en populations consanguines ?
Les tests de liaison génétique en populations consanguines
Principe • Recherche de fragments d'ADN plus partagés par des malades apparentés qu'attendu du fait de leur apparentement • Dans les grandes populations panmictiques: des échantillons de paires de germains atteints indépendantes
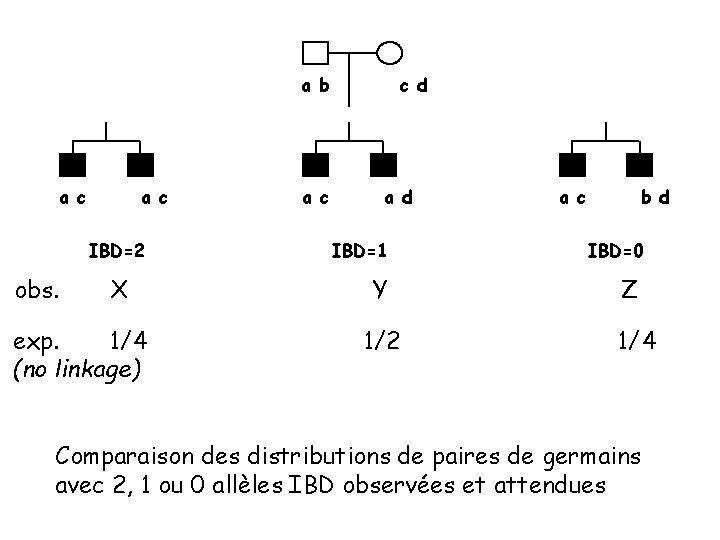
a b a c IBD=2 obs. X exp. 1/4 (no linkage) a c c d a d IBD=1 a c b d IBD=0 Y Z 1/2 1/4 Comparaison des distributions de paires de germains avec 2, 1 ou 0 allèles IBD observées et attendues
Principe • Recherche des segments d'ADN plus partagés par des malades apparentés qu'attendu du fait de leur apparentement • Dans les grandes populations panmictiques: des échantillons de paires de germains atteints indépendantes • Dans les populations consanguines: – des paires de germains atteints consanguins – des paires non indépendantes (isolats en particulier) è les probabilités IBD attendues sont augmentées è risque de conclure à tort à la liaison
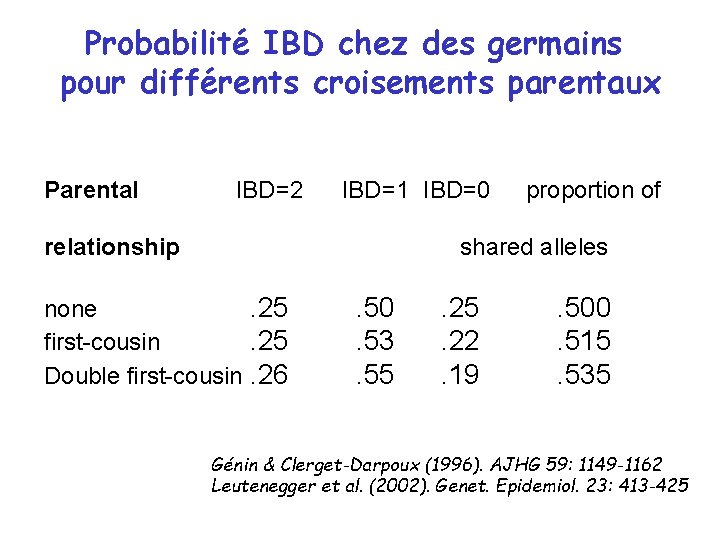
Probabilité IBD chez des germains pour différents croisements parentaux Parental IBD=2 IBD=1 IBD=0 relationship proportion of shared alleles none. 25 first-cousin. 25 Double first-cousin. 26 . 50. 53. 55 . 25. 22. 19 . 500. 515. 535 Génin & Clerget-Darpoux (1996). AJHG 59: 1149 -1162 Leutenegger et al. (2002). Genet. Epidemiol. 23: 413 -425
Calcul des proportions IBD dans une population consanguine • Si la généalogie est disponible: – Nécessité de tenir compte de l'ensemble de la généalogie – Problèmes computationels: il faut couper la généalogie en petites unités • Si la généalogie n'est pas disponible ou fiable: – Contraste entre l'IBD observé en un point donné et celui observé sur l'ensemble du génome: "genomic control" Genome Mismatch Scanning (Nelson 1993; Durham 1997)
Prise en compte de l'IBD intra dans les tests de liaison • Les tests classiques ne tiennent compte que de l'IBD inter (entre les frères et soeurs) • IBD intra-individuelle aussi possible dans les populations consanguines: 9 états d'identité
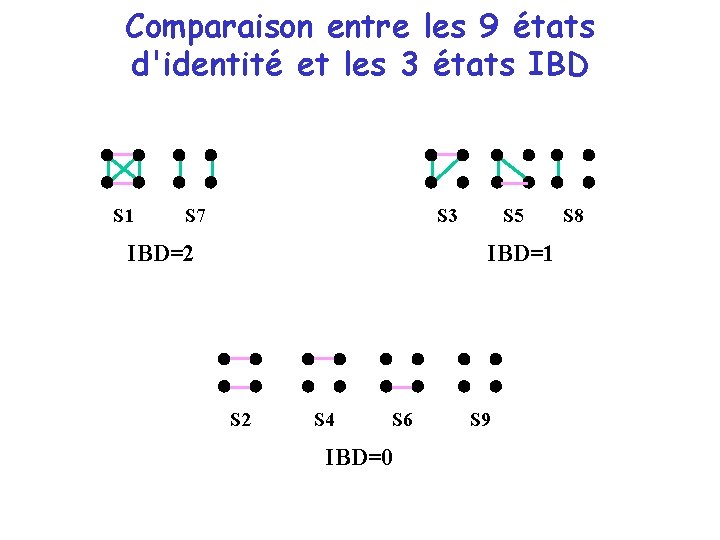
Comparaison entre les 9 états d'identité et les 3 états IBD S 1 S 5 S 3 S 7 IBD=2 IBD=1 S 2 S 4 S 6 IBD=0 S 9 S 8
Prise en compte de l'IBD intra dans les tests de liaison • Les tests classiques ne tiennent compte que de l'IBD inter (entre les frères et soeurs) • IBD intra-individuelle aussi possible dans les populations consanguines: 9 états d'identité • Un test pour tenir compte de l'IBD inter et intra dans les paires de germains: basé sur le nombre d'allèles différents (non IBD) dans les paires (Na=1, 2, 3 or 4)
Comparaison entre les 9 états d'identité et les 4 états Na S 1 S 7 Na=1 S 4 S 3 S 5 Na=2 S 6 Na=3 S 8 S 9 Na=4 S 2
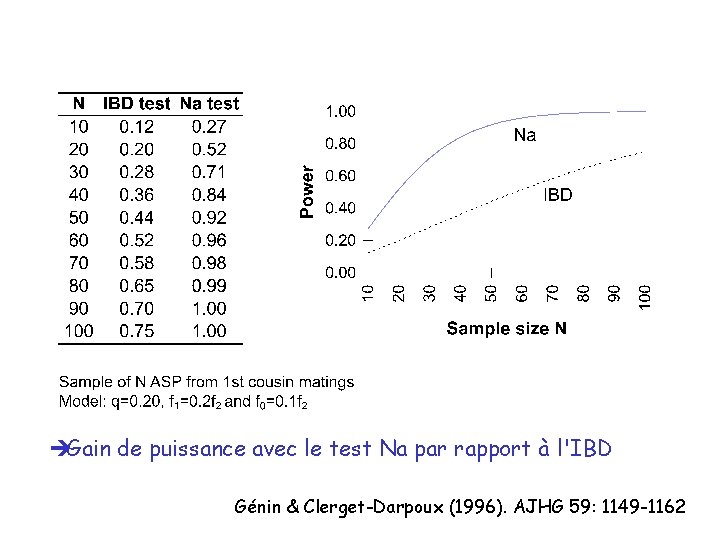
èGain de puissance avec le test Na par rapport à l'IBD Génin & Clerget-Darpoux (1996). AJHG 59: 1149 -1162
Tests de liaison en populations consanguines • La puissance des tests de liaison peut être augmentée en présence de consanguinité si on tient compte conjointement des IBD inter et intra-individuels • Cependant, une bonne connaissance des coefficients de consanguinité et de parenté est nécessaire
Tests d'association en populations consanguines
Principe • Comparaison des fréquences génotypiques dans des échantillons de malades et de témoins
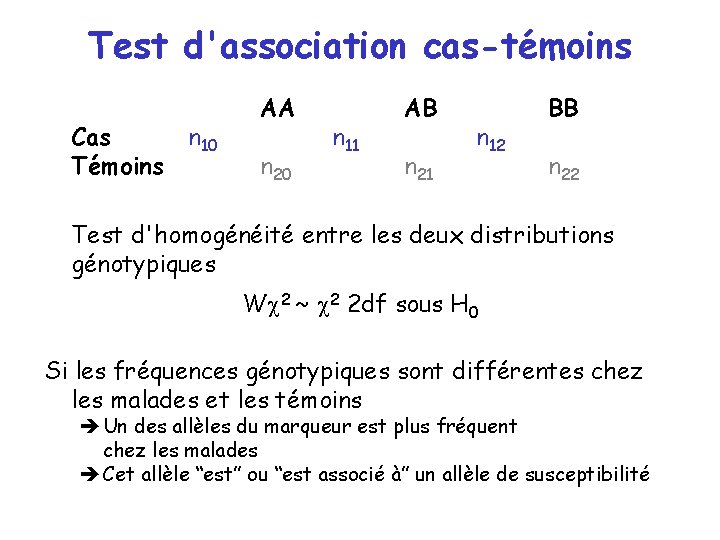
Test d'association cas-témoins Cas Témoins n 10 AA n 20 n 11 AB n 21 n 12 BB n 22 Test d'homogénéité entre les deux distributions génotypiques Wc 2 ~ c 2 2 df sous H 0 Si les fréquences génotypiques sont différentes chez les malades et les témoins è Un des allèles du marqueur est plus fréquent chez les malades è Cet allèle “est” ou “est associé à” un allèle de susceptibilité
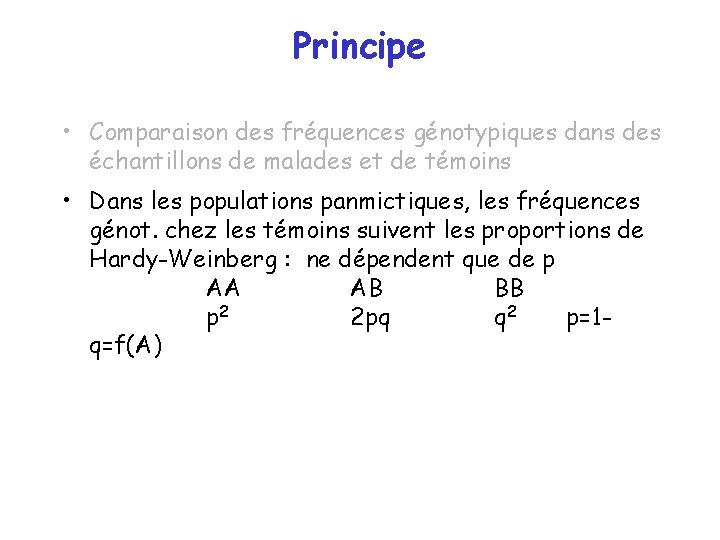
Principe • Comparaison des fréquences génotypiques dans des échantillons de malades et de témoins • Dans les populations panmictiques, les fréquences génot. chez les témoins suivent les proportions de Hardy-Weinberg : ne dépendent que de p AA AB BB p 2 2 pq q 2 p=1 q=f(A)
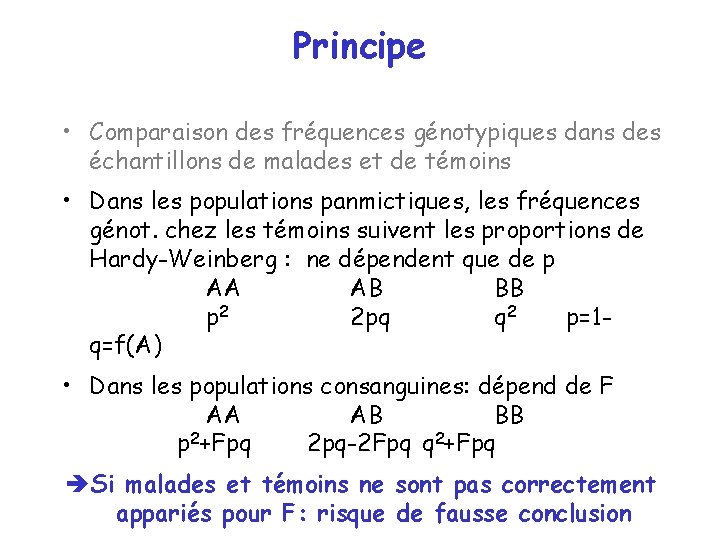
Principe • Comparaison des fréquences génotypiques dans des échantillons de malades et de témoins • Dans les populations panmictiques, les fréquences génot. chez les témoins suivent les proportions de Hardy-Weinberg : ne dépendent que de p AA AB BB p 2 2 pq q 2 p=1 q=f(A) • Dans les populations consanguines: dépend de F AA AB BB p 2+Fpq 2 pq-2 Fpq q 2+Fpq è Si malades et témoins ne sont pas correctement appariés pour F: risque de fausse conclusion
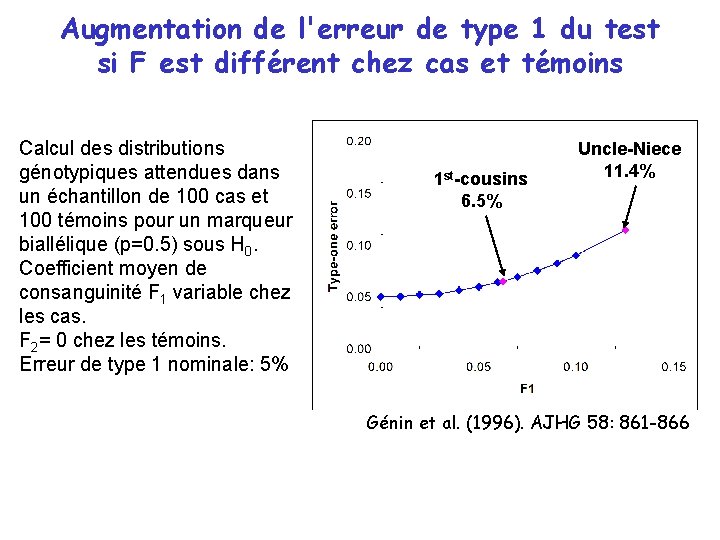
Augmentation de l'erreur de type 1 du test si F est différent chez cas et témoins Calcul des distributions génotypiques attendues dans un échantillon de 100 cas et 100 témoins pour un marqueur biallélique (p=0. 5) sous H 0. Coefficient moyen de consanguinité F 1 variable chez les cas. F 2= 0 chez les témoins. Erreur de type 1 nominale: 5% 1 st-cousins 6. 5% Uncle-Niece 11. 4% Génin et al. (1996). AJHG 58: 861 -866
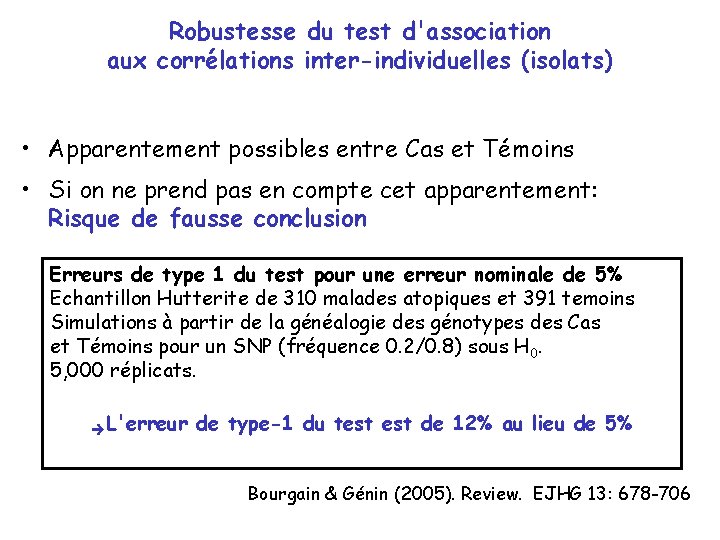
Robustesse du test d'association aux corrélations inter-individuelles (isolats) • Apparentement possibles entre Cas et Témoins • Si on ne prend pas en compte cet apparentement: Risque de fausse conclusion Erreurs de type 1 du test pour une erreur nominale de 5% Echantillon Hutterite de 310 malades atopiques et 391 temoins Simulations à partir de la généalogie des génotypes des Cas et Témoins pour un SNP (fréquence 0. 2/0. 8) sous H 0. 5, 000 réplicats. è L'erreur de type-1 du test de 12% au lieu de 5% Bourgain & Génin (2005). Review. EJHG 13: 678 -706
Quelles solutions ? • Utiliser des méthodes de permutation pour évaluer les degrés de signification
Quelles solutions ? • Utiliser des méthodes de permutation pour évaluer les degrés de signification: PAS VALIDE car hypothèse d'indépendance sur les génotypes Sur l'exemple Hutterite: erreur de type 1 de 13%
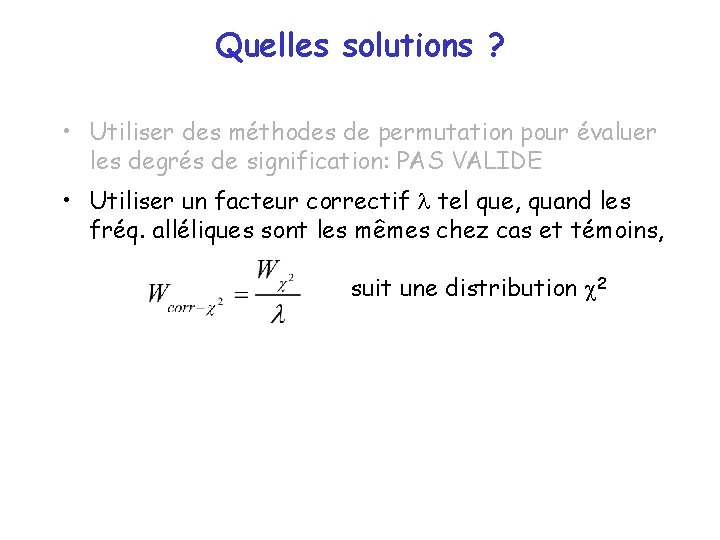
Quelles solutions ? • Utiliser des méthodes de permutation pour évaluer les degrés de signification: PAS VALIDE • Utiliser un facteur correctif l tel que, quand les fréq. alléliques sont les mêmes chez cas et témoins, suit une distribution c 2
Calcul du facteur correctif l 1. l ne dépend pas des caractéristiques du marqueur mais dépend 1. des coefficients de consanguinité de tous les cas et de tous les témoins 2. des coefficients de parenté entre tous les cas et tous les témoins 2. Si la généalogie est connue: Calcul direct Bourgain et al (2003), AJHG 73: 612 -626 3. Si la généalogie n'est pas connue: Utilisation de marqueurs aléatoires: "Genomic Controls" Devlin & Roeder, Biometrics, 1999
Quelles solutions ? • Utiliser des méthodes de permutation pour évaluer les degrés de signification: PAS VALIDE • Utiliser un facteur correctif l: OK si généalogie connue ou marqueurs aléatoires disponibles • Utiliser des données familiales: Transmission Disequilibrium Test
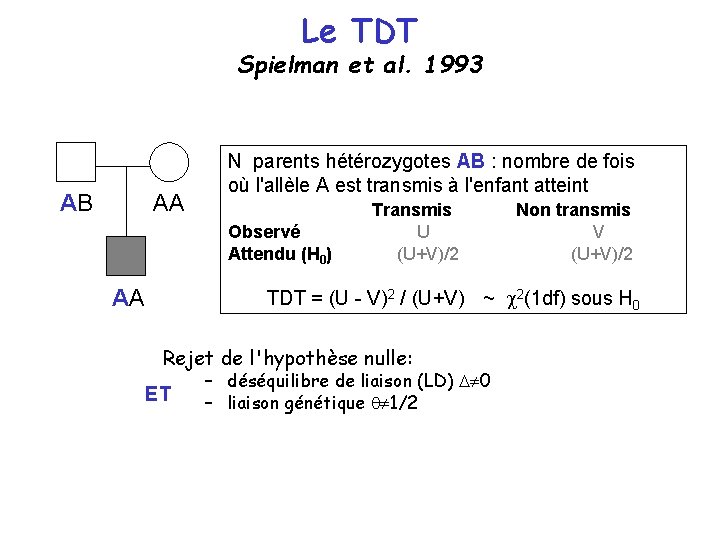
Le TDT Spielman et al. 1993 AB AA N parents hétérozygotes AB : nombre de fois où l'allèle A est transmis à l'enfant atteint Observé Attendu (H 0) AA Transmis U (U+V)/2 Non transmis V (U+V)/2 TDT = (U - V)2 / (U+V) ~ c 2(1 df) sous H 0 Rejet de l'hypothèse nulle: ET – déséquilibre de liaison (LD) D 0 – liaison génétique q 1/2
Puissance des tests d'association en présence de consanguinité • La puissance des tests cas/témoins et TDT peut être augmentée en présence de consanguinité. • Pour Cas/Témoins: le gain de puissance peut être plus grand que pour le TDT mais nécessite d'estimer le facteur correctif l – sur la généalogie complète si connue – sur des marqueurs aléatoires • Pour le TDT: seule l'information sur le malade et ses parents est nécessaire (pas besoin de F ou de la généalogie complète)
Identifier les gènes impliqués dans les maladies complexes en populations consanguines : Conclusion • Les populations consanguines ont des caractéristiques génétiques intéressantes (IBD inter et intra) qui peuvent aider pour identifier les facteurs génétiques – dans les maladies monogéniques – dans les maladies multifactorielles • Les méthodes développées dans les grandes populations ne sont généralement pas appropriées – Hypothèses non vérifiées – Augmentation de l'erreur de type 1 des tests: Fausses conclusions
èUn besoin de nouvelles méthodes qui tiennent compte des particularités de ces populations