
EMC Full Time Auto Start Clustering EMC Full
- Slides: 44
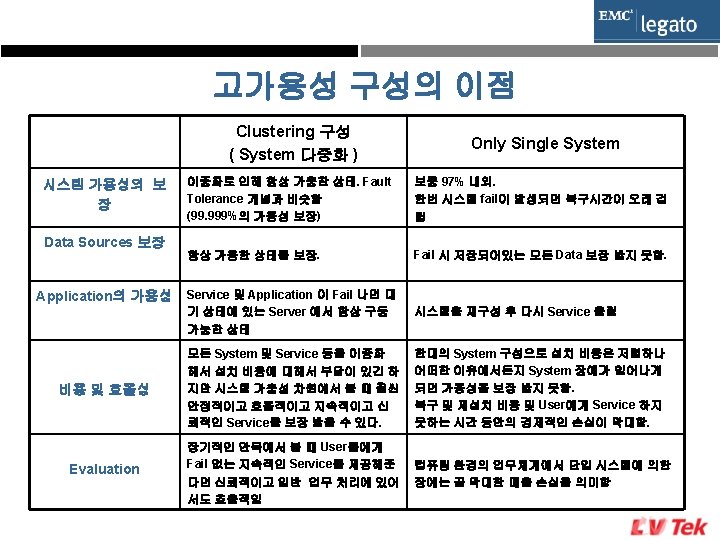
EMC Full. Time Auto. Start
Clustering 이란?
EMC Full. Time Auto. Start 란?
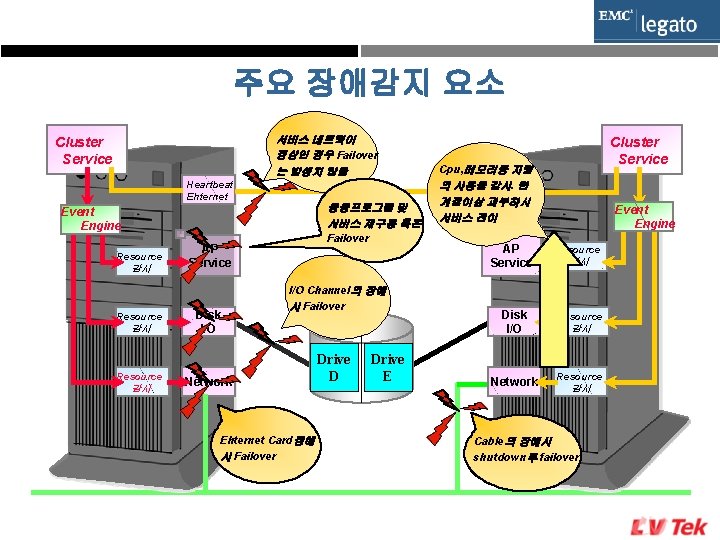
주요 장애감지 요소 서비스 네트웍이 정상인 경우 Failover 는 발생치 않음 Cluster Service Heartbeat Ehternet 응응프로그램 및 서비스 재구동 혹은 Event Engine Resource 감시 Failover AP Service Disk I/O Channel의 장애 시 Failover Network Ehternet Card장애 시 Failover Drive D Drive E Cluster Service Cpu, 메모리등 자원 Heartbeat 의 사용율 감시. 한 Ethernet 계점이상 과부하시 서비스 전이 Event Engine AP Service Resource Disk I/O Resource Network Resource 감시 감시 감시 Cable의 장애시 shutdown후 failover
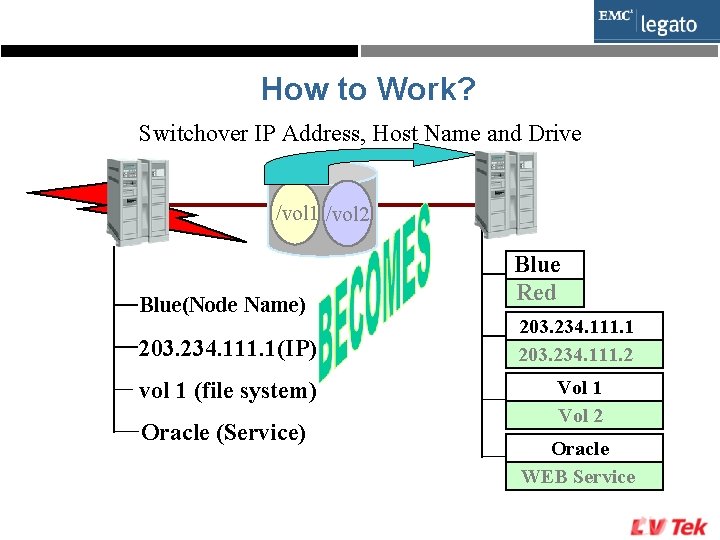
How to Work? Switchover IP Address, Host Name and Drive /vol 1 /vol 2 Blue(Node Name) 203. 234. 111. 1(IP) vol 1 (file system) Oracle (Service) Blue Red 203. 234. 111. 1 203. 234. 111. 2 Vol 1 Vol 2 Oracle WEB Service
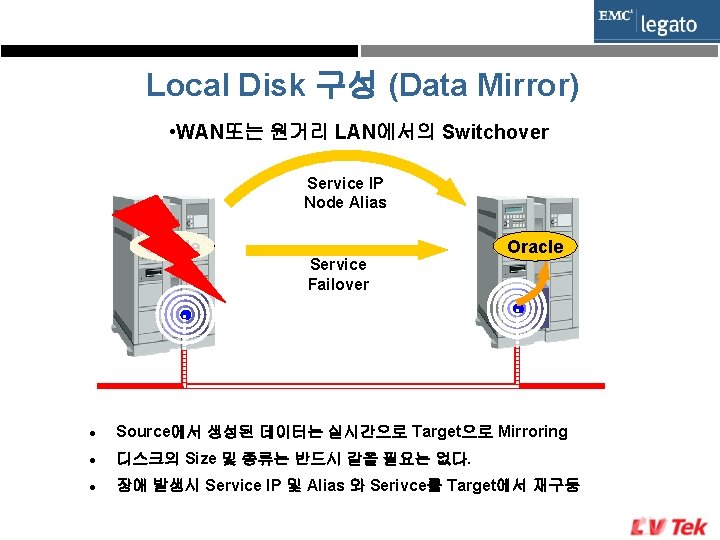
Local Disk 구성 (Data Mirror) • WAN또는 원거리 LAN에서의 Switchover Service IP Node Alias Oracle Service Failover Oracle l Source에서 생성된 데이터는 실시간으로 Target으로 Mirroring l 디스크의 Size 및 종류는 반드시 같을 필요는 없다. l 장애 발생시 Service IP 및 Alias 와 Serivce를 Target에서 재구동
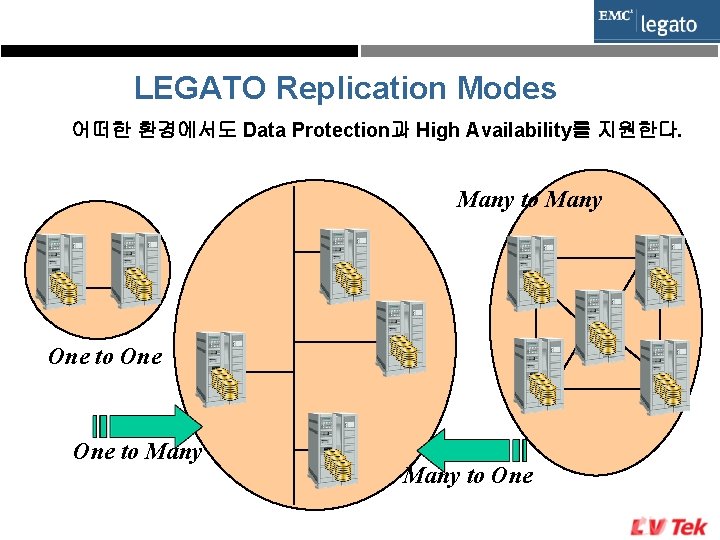
LEGATO Replication Modes 어떠한 환경에서도 Data Protection과 High Availability를 지원한다. Many to Many One to Many to One
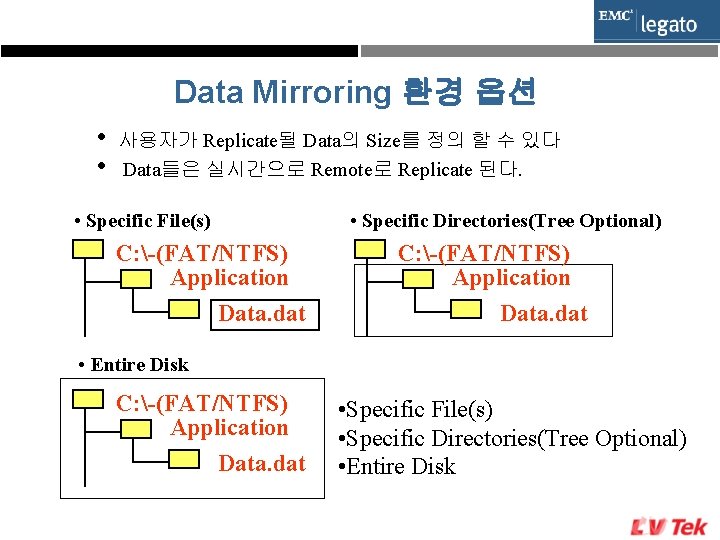
Data Mirroring 환경 옵션 • • 사용자가 Replicate될 Data의 Size를 정의 할 수 있다 Data들은 실시간으로 Remote로 Replicate 된다. • Specific File(s) C: -(FAT/NTFS) Application Data. dat • Specific Directories(Tree Optional) C: -(FAT/NTFS) Application Data. dat • Entire Disk C: -(FAT/NTFS) Application Data. dat • Specific File(s) • Specific Directories(Tree Optional) • Entire Disk
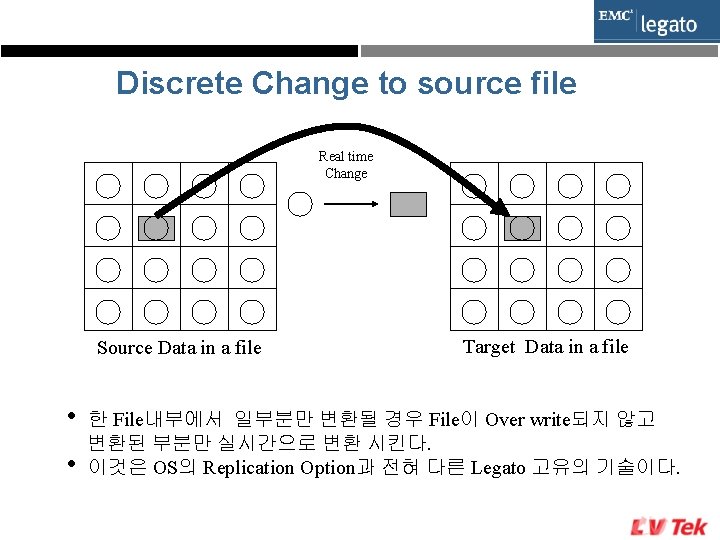
Discrete Change to source file Real time Change Source Data in a file • • Target Data in a file 한 File내부에서 일부분만 변환될 경우 File이 Over write되지 않고 변환된 부분만 실시간으로 변환 시킨다. 이것은 OS의 Replication Option과 전혀 다른 Legato 고유의 기술이다.
Advanced Failover Feature • • • Service Detection Service Grouping 분산 Failover Casecade Failover Auto Failback
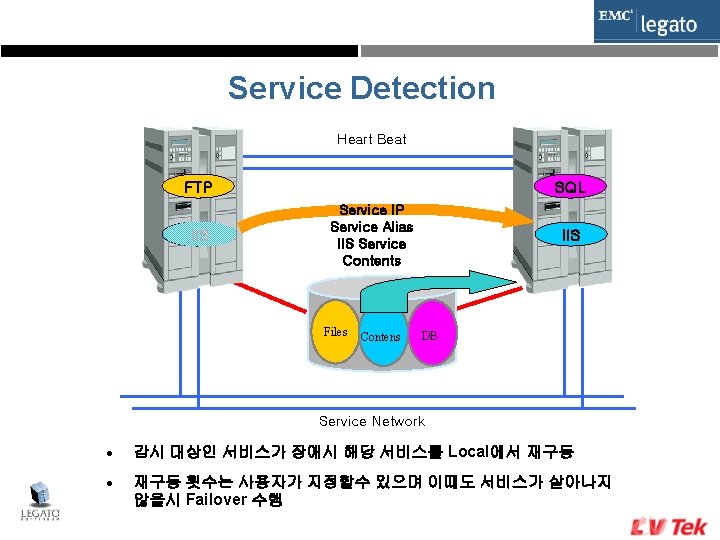
Service Detection Heart Beat FTP IIS SQL Service IP Service Alias IIS Service Contents Files Contens IIS DB Service Network l l 감시 대상인 서비스가 장애시 해당 서비스를 Local에서 재구동 횟수는 사용자가 지정할수 있으며 이때도 서비스가 살아나지 않을시 Failover 수행
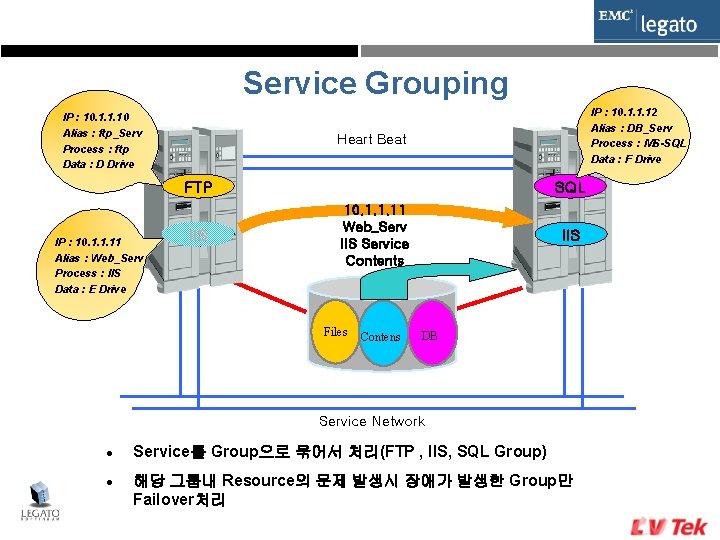
Service Grouping IP : 10. 1. 1. 10 Alias : ftp_Serv Process : ftp Data : D Drive IP : 10. 1. 1. 12 Alias : DB_Serv Process : MS-SQL Data : F Drive Heart Beat FTP IP : 10. 1. 1. 11 Alias : Web_Serv Process : IIS Data : E Drive IIS SQL 10. 1. 1. 11 Web_Serv IIS Service Contents Files Contens IIS DB Service Network l l Service를 Group으로 묶어서 처리(FTP , IIS, SQL Group) 해당 그룹내 Resource의 문제 발생시 장애가 발생한 Group만 Failover처리
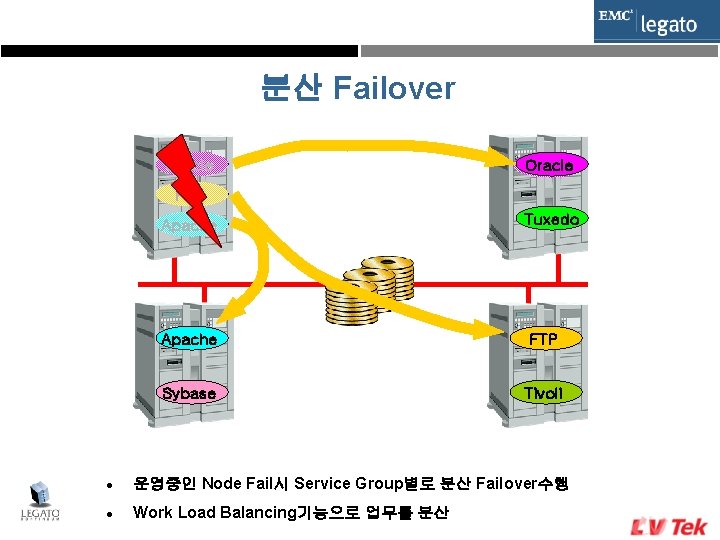
분산 Failover Oracle FTP Apache Tuxedo Apache FTP Sybase Tivoli l 운영중인 Node Fail시 Service Group별로 분산 Failover수행 l Work Load Balancing기능으로 업무를 분산
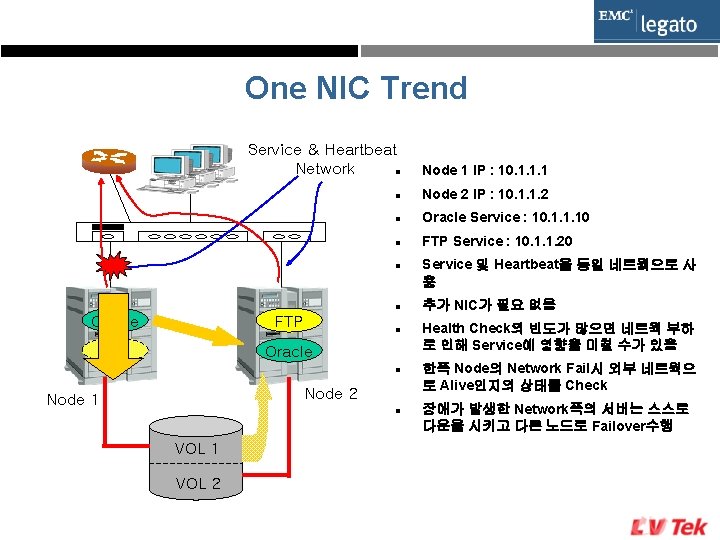
One NIC Trend Service & Heartbeat Network l Node 1 IP : 10. 1. 1. 1 l Node 2 IP : 10. 1. 1. 2 l Oracle Service : 10. 1. 1. 10 l FTP Service : 10. 1. 1. 20 l l Oracle FTP Oracle l l Node 2 Node 1 l VOL 1 VOL 2 Service 및 Heartbeat을 동일 네트웤으로 사 용 추가 NIC가 필요 없음 Health Check의 빈도가 많으면 네트웍 부하 로 인해 Service에 영향을 미칠 수가 있음 한쪽 Node의 Network Fail시 외부 네트웍으 로 Alive인지의 상태를 Check 장애가 발생한 Network쪽의 서버는 스스로 다운을 시키고 다른 노드로 Failover수행
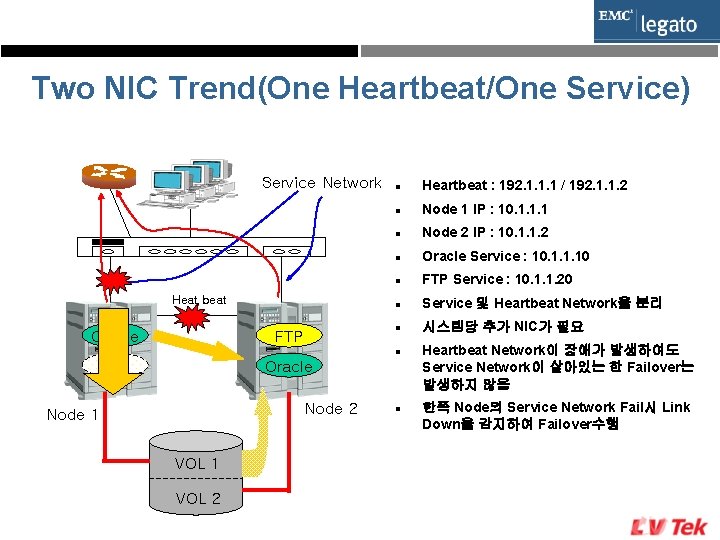
Two NIC Trend(One Heartbeat/One Service) Service Network Heat beat Oracle FTP l Heartbeat : 192. 1. 1. 1 / 192. 1. 1. 2 l Node 1 IP : 10. 1. 1. 1 l Node 2 IP : 10. 1. 1. 2 l Oracle Service : 10. 1. 1. 10 l FTP Service : 10. 1. 1. 20 l Service 및 Heartbeat Network을 분리 l 시스템당 추가 NIC가 필요 l FTP Oracle Node 2 Node 1 VOL 2 l Heartbeat Network이 장애가 발생하여도 Service Network이 살아있는 한 Failover는 발생하지 않음 한쪽 Node의 Service Network Fail시 Link Down을 감지하여 Failover수행
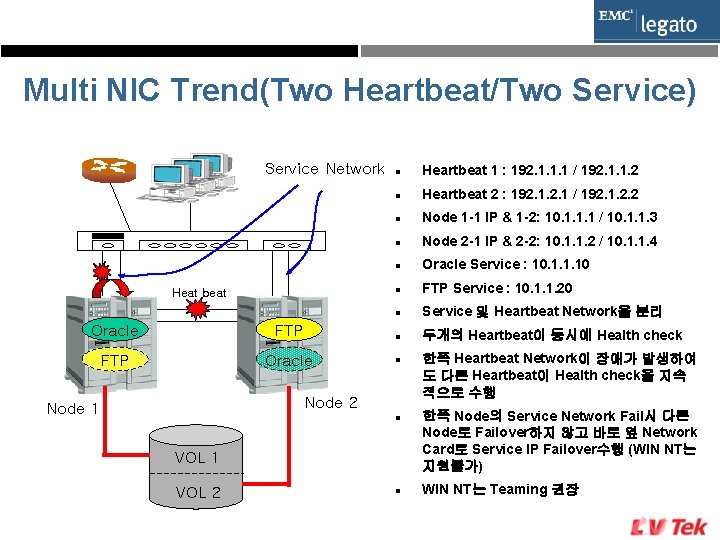
Multi NIC Trend(Two Heartbeat/Two Service) Service Network Heat beat l Heartbeat 1 : 192. 1. 1. 1 / 192. 1. 1. 2 l Heartbeat 2 : 192. 1 / 192. 1. 2. 2 l Node 1 -1 IP & 1 -2: 10. 1. 1. 1 / 10. 1. 1. 3 l Node 2 -1 IP & 2 -2: 10. 1. 1. 2 / 10. 1. 1. 4 l Oracle Service : 10. 1. 1. 10 l FTP Service : 10. 1. 1. 20 l Service 및 Heartbeat Network을 분리 두개의 Heartbeat이 동시에 Health check Oracle FTP l FTP Oracle l Node 2 Node 1 l VOL 1 VOL 2 l 한쪽 Heartbeat Network이 장애가 발생하여 도 다른 Heartbeat이 Health check을 지속 적으로 수행 한쪽 Node의 Service Network Fail시 다른 Node로 Failover하지 않고 바로 옆 Network Card로 Service IP Failover수행 (WIN NT는 지원불가) WIN NT는 Teaming 권장
Fulltime Auto. Start 설정
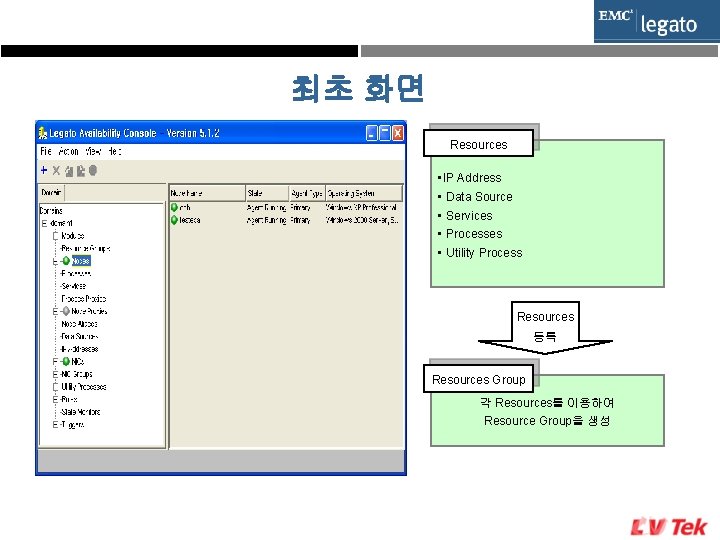
최초 화면 Resources • IP Address • Data Source • Services • Processes • Utility Process Resources 등록 Resources Group 각 Resources를 이용하여 Resource Group을 생성
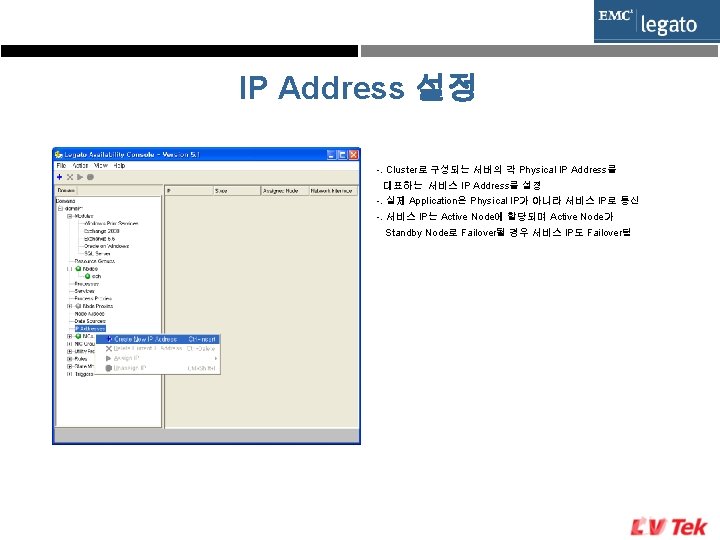
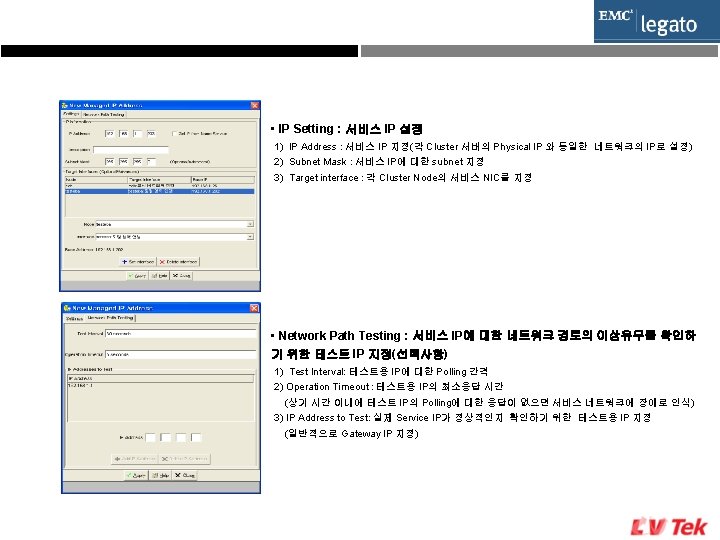
IP Address 설정 -. Cluster로 구성되는 서버의 각 Physical IP Address를 대표하는 서비스 IP Address를 설정 -. 실제 Application은 Physical IP가 아니라 서비스 IP로 통신 -. 서비스 IP는 Active Node에 할당되며 Active Node가 Standby Node로 Failover될 경우 서비스 IP도 Failover됨
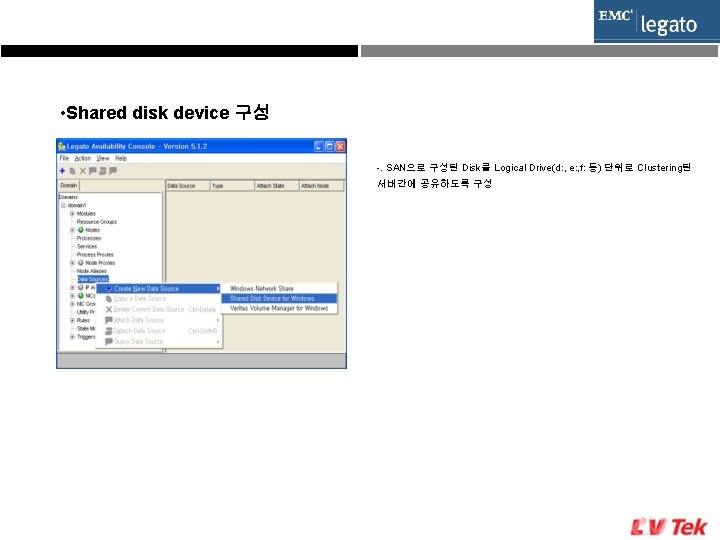
Data Source 설정 • Shared disk device 구성 • Network share 구성 • Veritas volume manager로 구성
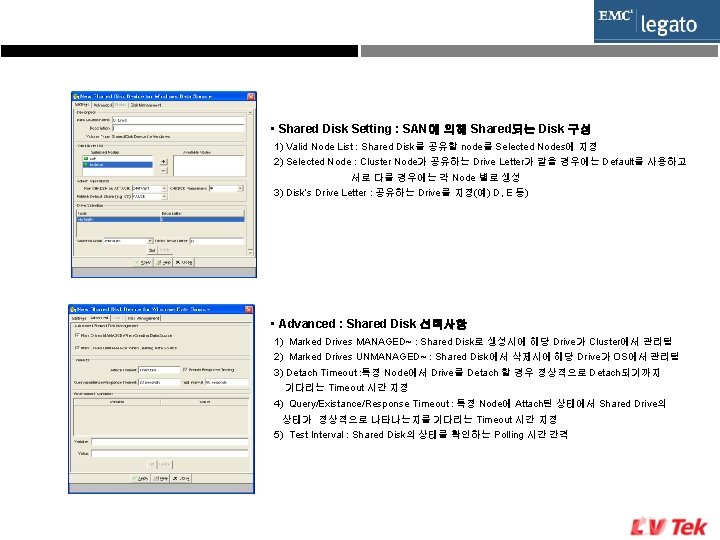
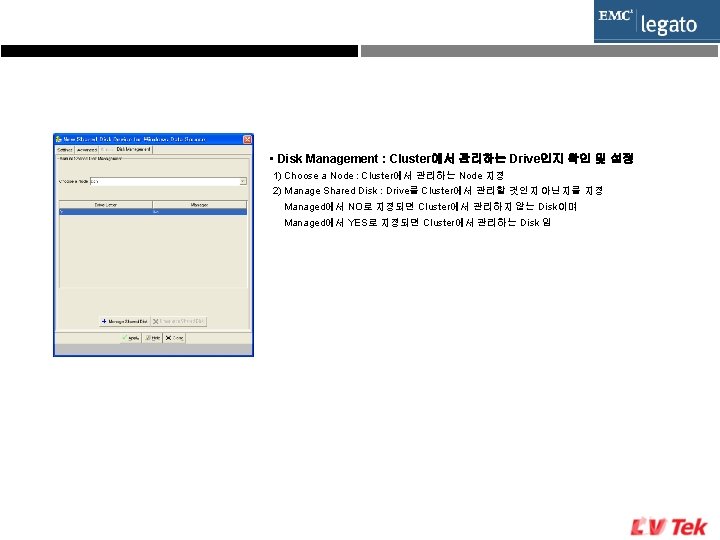
• Shared Disk Setting : SAN에 의해 Shared되는 Disk 구성 1) Valid Node List : Shared Disk를 공유할 node를 Selected Nodes에 지정 2) Selected Node : Cluster Node가 공유하는 Drive Letter가 같을 경우에는 Default를 사용하고 서로 다를 경우에는 각 Node 별로 생성 3) Disk’s Drive Letter : 공유하는 Drive를 지정(예) D, E 등) • Advanced : Shared Disk 선택사항 1) Marked Drives MANAGED~ : Shared Disk로 생성시에 해당 Drive가 Cluster에서 관리됨 2) Marked Drives UNMANAGED~ : Shared Disk에서 삭제시에 해당 Drive가 OS에서 관리됨 3) Detach Timeout : 특정 Node에서 Drive를 Detach 할 경우 정상적으로 Detach되기까지 기다리는 Timeout 시간 지정 4) Query/Existance/Response Timeout : 특정 Node에 Attach된 상태에서 Shared Drive의 상태가 정상적으로 나타나는지를 기다리는 Timeout 시간 지정 5) Test Interval : Shared Disk의 상태를 확인하는 Polling 시간 간격
• Disk Management : Cluster에서 관리하는 Drive인지 확인 및 설정 1) Choose a Node : Cluster에서 관리하는 Node 지정 2) Manage Shared Disk : Drive를 Cluster에서 관리할 것인지 아닌지를 지정 Managed에서 NO로 지정되면 Cluster에서 관리하지 않는 Disk이며 Managed에서 YES로 지정되면 Cluster에서 관리하는 Disk 임
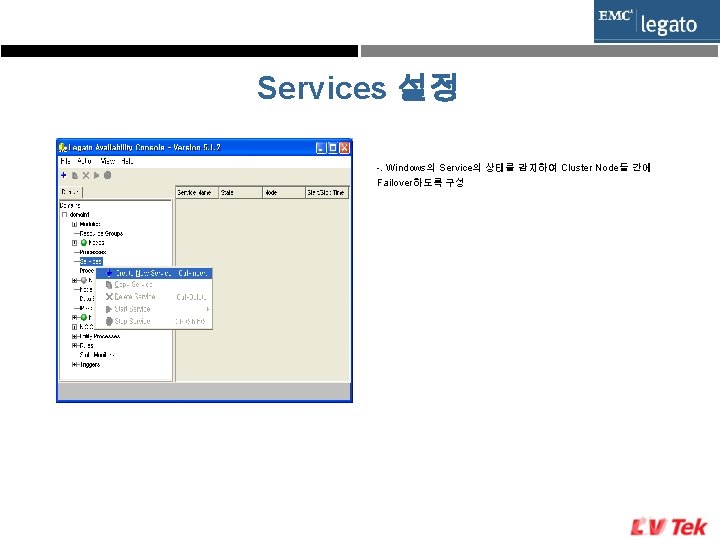
Services 설정 -. Windows의 Service의 상태를 감지하여 Cluster Node들 간에 Failover하도록 구성
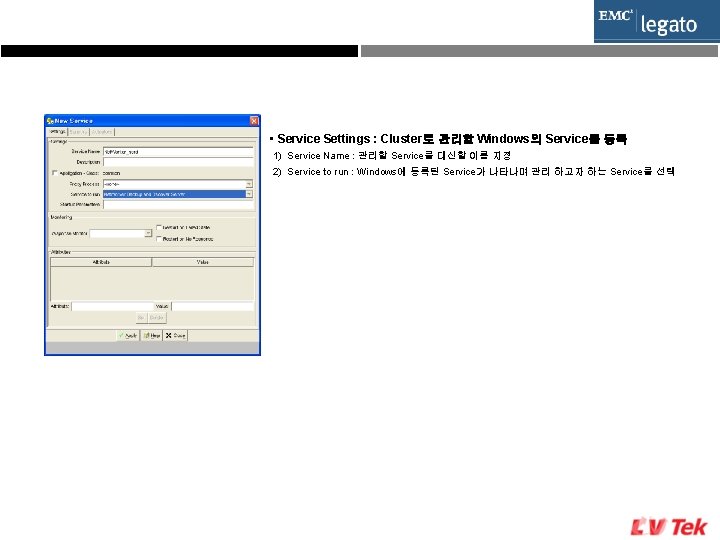
• Service Settings : Cluster로 관리할 Windows의 Service를 등록 1) Service Name : 관리할 Service를 대신할 이름 지정 2) Service to run : Windows에 등록된 Service가 나타나며 관리 하고자 하는 Service를 선택
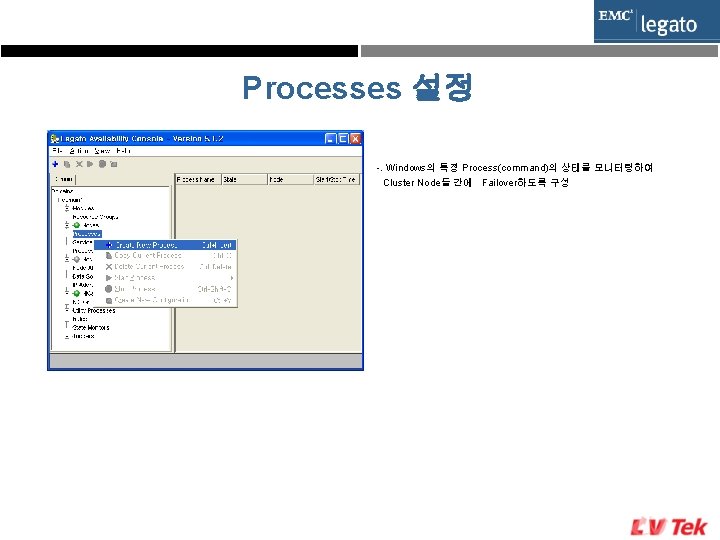
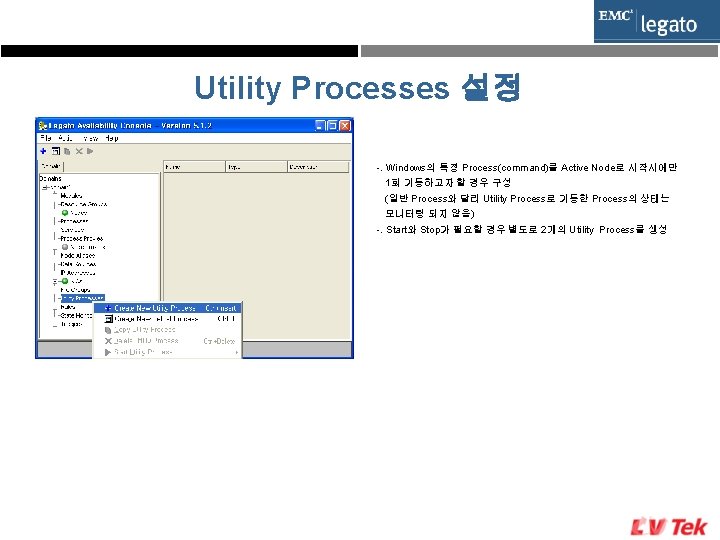
Processes 설정 -. Windows의 특정 Process(command)의 상태를 모니터링하여 Cluster Node들 간에 Failover하도록 구성
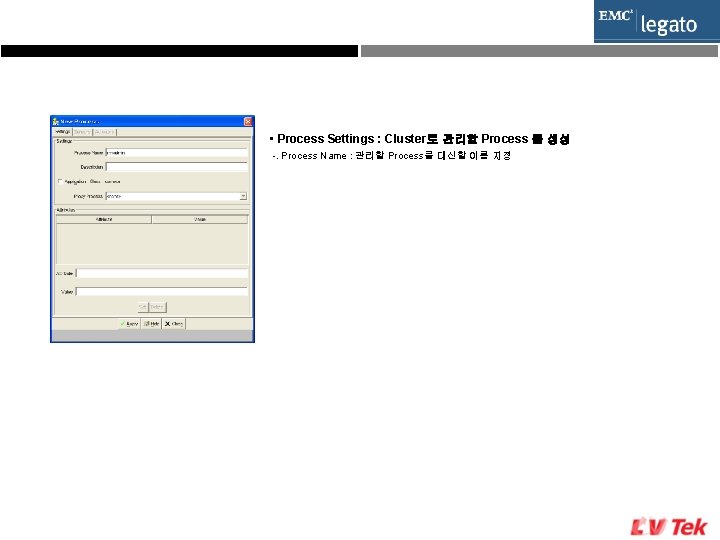
• Process Settings : Cluster로 관리할 Process 를 생성 -. Process Name : 관리할 Process를 대신할 이름 지정
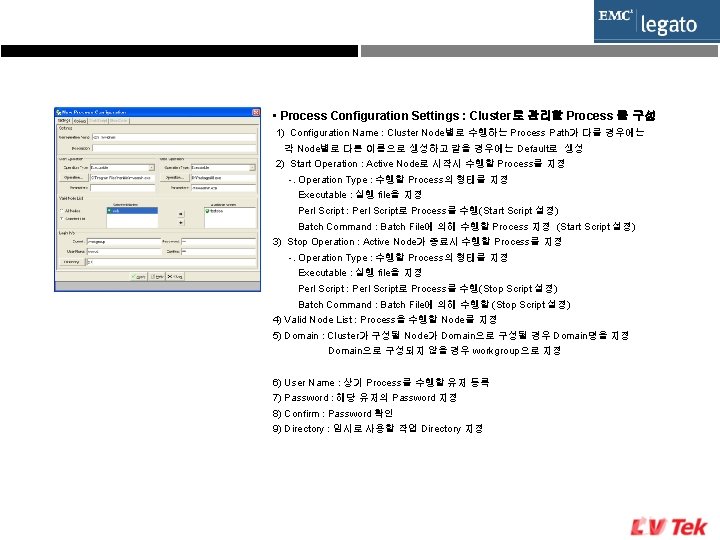
• Process Configuration Settings : Cluster로 관리할 Process 를 구성 1) Configuration Name : Cluster Node별로 수행하는 Process Path가 다를 경우에는 각 Node별로 다른 이름으로 생성하고 같을 경우에는 Default로 생성 2) Start Operation : Active Node로 시작시 수행할 Process를 지정 -. Operation Type : 수행할 Process의 형태를 지정 Executable : 실행 file을 지정 Perl Script : Perl Script로 Process를 수행(Start Script 설정) Batch Command : Batch File에 의해 수행할 Process 지정 (Start Script 설정) 3) Stop Operation : Active Node가 종료시 수행할 Process를 지정 -. Operation Type : 수행할 Process의 형태를 지정 Executable : 실행 file을 지정 Perl Script : Perl Script로 Process를 수행(Stop Script 설정) Batch Command : Batch File에 의해 수행할 (Stop Script 설정) 4) Valid Node List : Process을 수행할 Node를 지정 5) Domain : Cluster가 구성될 Node가 Domain으로 구성될 경우 Domain명을 지정 Domain으로 구성되지 않을 경우 workgroup으로 지정 6) User Name : 상기 Process를 수행할 유저 등록 7) Password : 해당 유저의 Password 지정 8) Confirm : Password 확인 9) Directory : 임시로 사용할 작업 Directory 지정
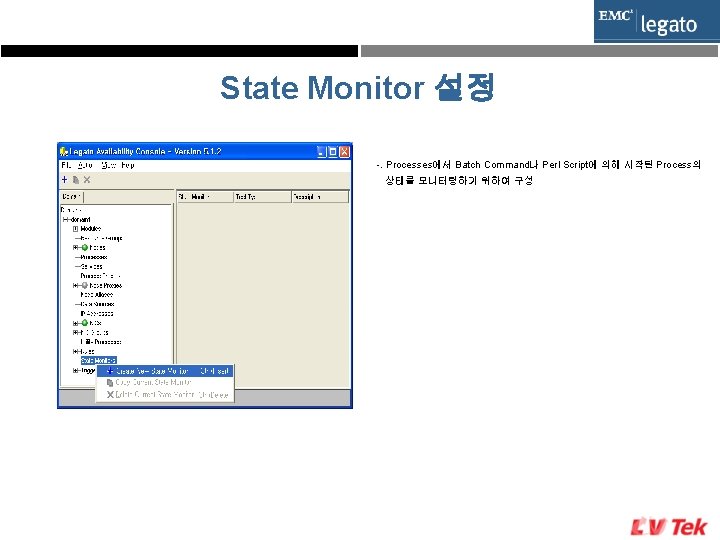
State Monitor 설정 -. Processes에서 Batch Command나 Perl Script에 의해 시작된 Process의 상태를 모니터링하기 위하여 구성
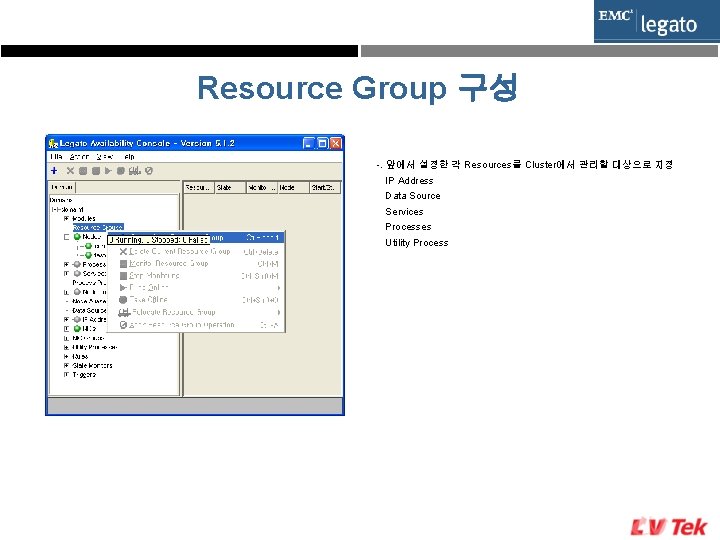
Resource Group 구성 -. 앞에서 설정한 각 Resources를 Cluster에서 관리할 대상으로 지정 IP Address Data Source Services Processes Utility Process
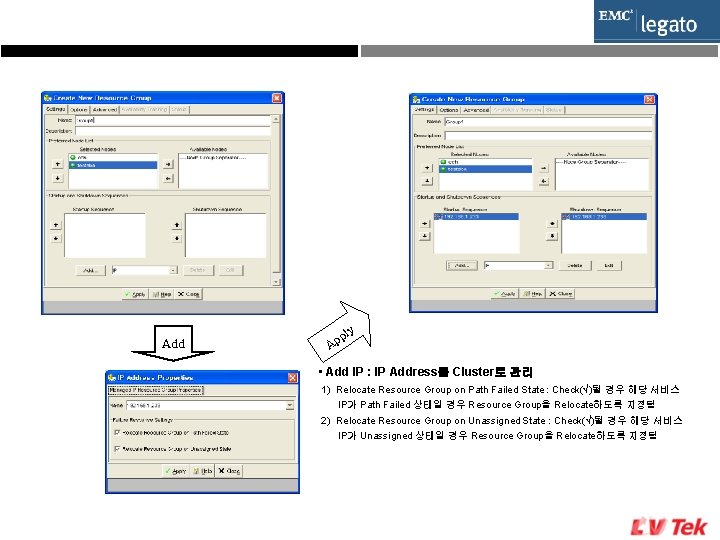
Add p Ap ly • Add IP : IP Address를 Cluster로 관리 1) Relocate Resource Group on Path Failed State : Check(√)될 경우 해당 서비스 IP가 Path Failed 상태일 경우 Resource Group을 Relocate하도록 지정됨 2) Relocate Resource Group on Unassigned State : Check(√)될 경우 해당 서비스 IP가 Unassigned 상태일 경우 Resource Group을 Relocate하도록 지정됨
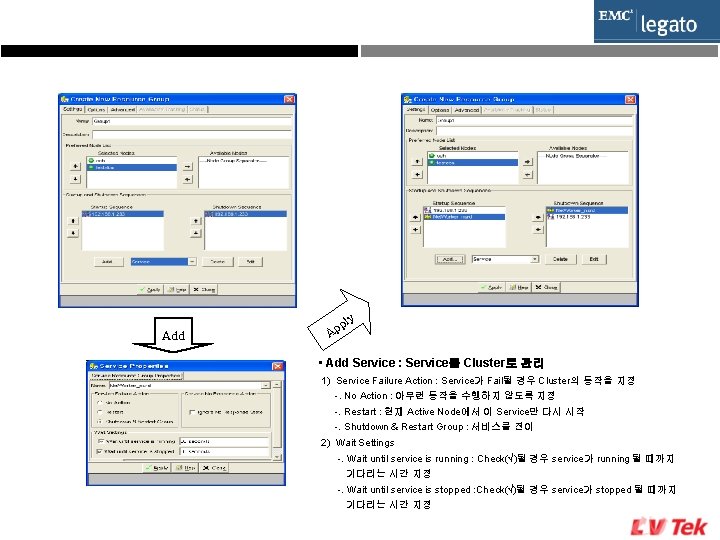
Add p Ap ly • Add Service : Service를 Cluster로 관리 1) Service Failure Action : Service가 Fail될 경우 Cluster의 동작을 지정 -. No Action : 아무런 동작을 수행하지 않도록 지정 -. Restart : 현재 Active Node에서 이 Service만 다시 시작 -. Shutdown & Restart Group : 서비스를 전이 2) Wait Settings -. Wait until service is running : Check(√)될 경우 service가 running 될 때까지 기다리는 시간 지정 -. Wait until service is stopped : Check(√)될 경우 service가 stopped 될 때까지 기다리는 시간 지정
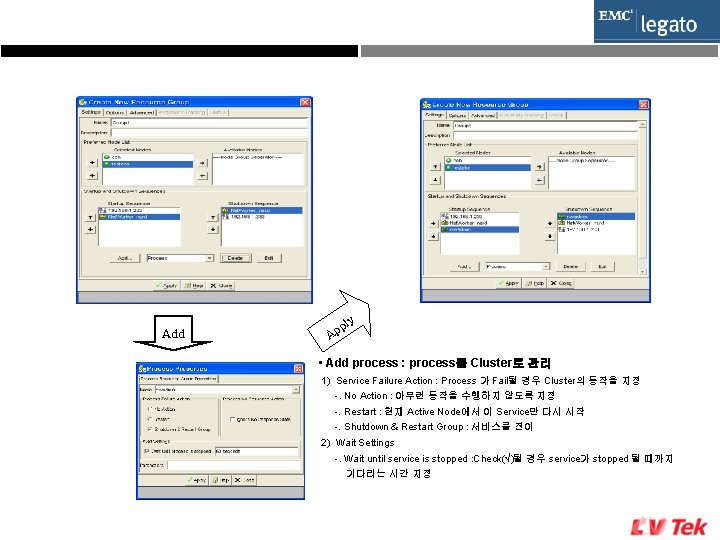
Add ply Ap • Add process : process를 Cluster로 관리 1) Service Failure Action : Process 가 Fail될 경우 Cluster의 동작을 지정 -. No Action : 아무런 동작을 수행하지 않도록 지정 -. Restart : 현재 Active Node에서 이 Service만 다시 시작 -. Shutdown & Restart Group : 서비스를 전이 2) Wait Settings -. Wait until service is stopped : Check(√)될 경우 service가 stopped 될 때까지 기다리는 시간 지정
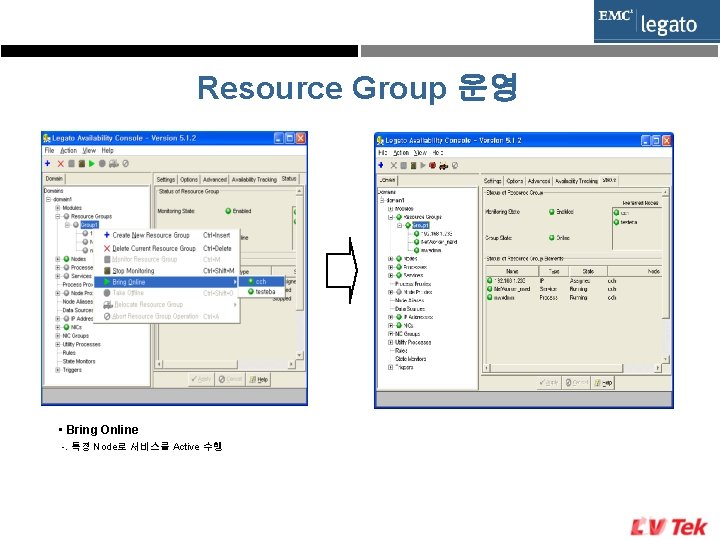
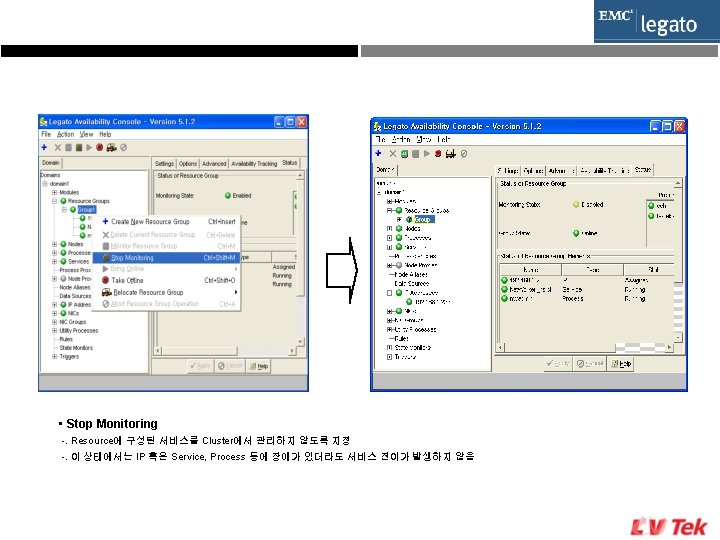
Resource Group 운영 • Bring Online -. 특정 Node로 서비스를 Active 수행
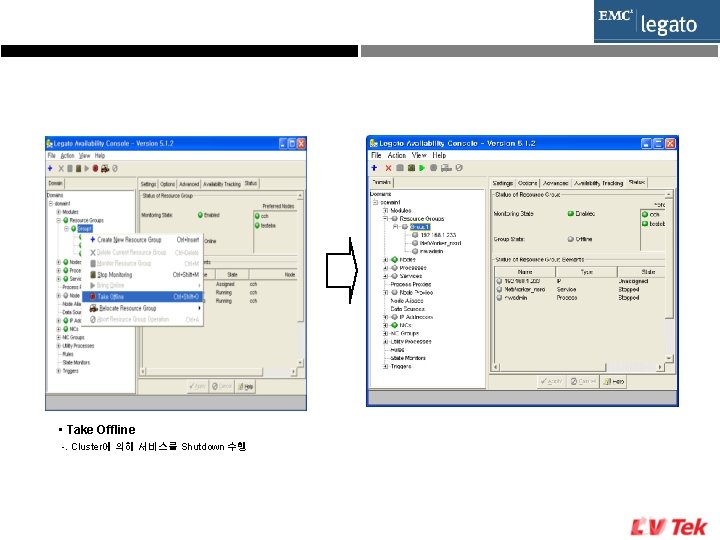
• Take Offline -. Cluster에 의해 서비스를 Shutdown 수행
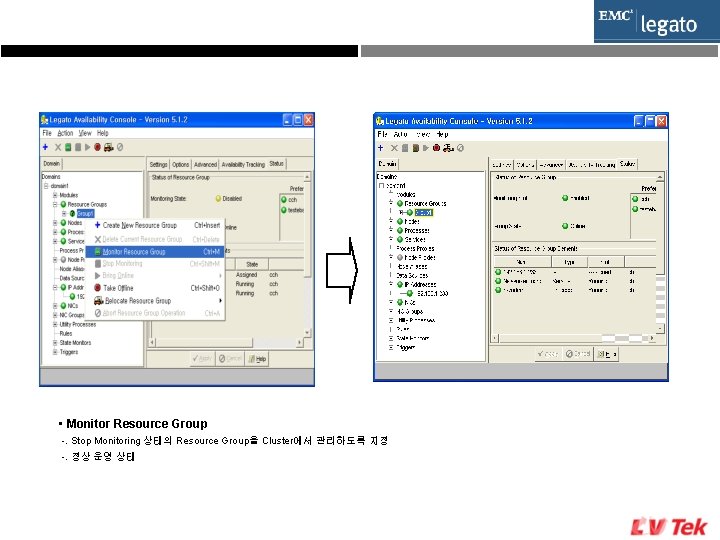
• Monitor Resource Group -. Stop Monitoring 상태의 Resource Group을 Cluster에서 관리하도록 지정 -. 정상 운영 상태