
Ekonometria WYKAD 4 Piotr Cikowicz Katedra Midzynarodowych Studiw




- Slides: 21
Ekonometria WYKŁAD 4 Piotr Ciżkowicz Katedra Międzynarodowych Studiów Porównawczych
Plan Czym się zajmiemy: 1. Prognozowanie na podstawie modelu ekonometrycznego 2. Modele liniowe i nieliniowe – przykłady
Prognozowanie – podstawowe pojęcia (1) ► Prognozowanie (albo predykcja) to określanie nieznanych wartości zmiennej objaśnianej na podstawie modelu ekonometrycznego opisującego kształtowanie się wartości tej zmiennej ► Prognozowanie na podstawie wyestymowanego modelu wymaga aby: ► model był pozytywnie zweryfikowany (w szczególności nie było podstaw do podejrzewania braku stabilności modelu) ► zasadna jest ekstrapolacja wartości zmiennych objaśniających i objaśnianej na okres poza próbą ► Przy takich założeniach prognoza jest nieobciążona tzn. wartość oczekiwana odchylenia prognozy od rzeczywistej wartości oczekiwanej zmiennej objaśnianej jest równa 0
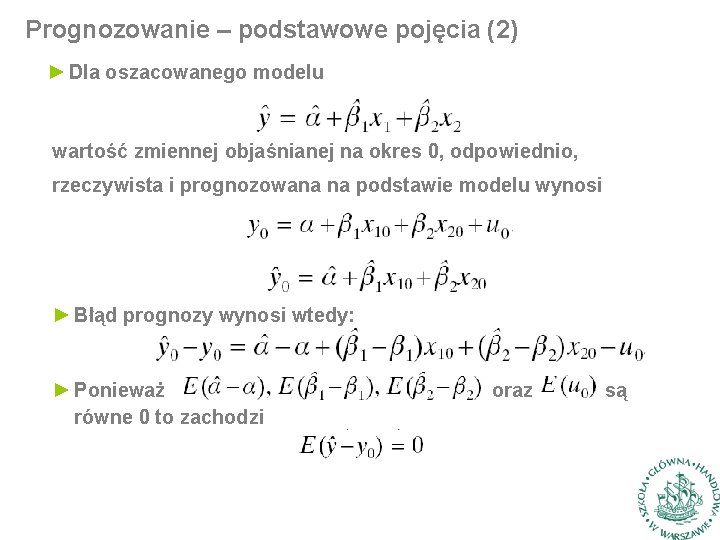
Prognozowanie – podstawowe pojęcia (2) ► Dla oszacowanego modelu wartość zmiennej objaśnianej na okres 0, odpowiednio, rzeczywista i prognozowana na podstawie modelu wynosi ► Błąd prognozy wynosi wtedy: ► Ponieważ równe 0 to zachodzi oraz są
Prognozowanie – podstawowe pojęcia (3) ► Źródła błędów prognozy: ► Błąd estymacji - oszacowane parametry różne od prawdziwych ► Błąd losowy – wartość składnika losowego w okresie prognozy różna od 0 ► Błąd struktury stochastycznej – niespełnione założenia MNK ► Błąd warunków endogenicznych – zmiana warunków kształtowania się zmiennej objaśnianej ► Błąd warunków egzogenicznych - błędne założenia odnośnie do kształtowania się zmiennych egzogenicznych ► Błąd pomiaru – zmiana danych na podstawie których oszacowany był model
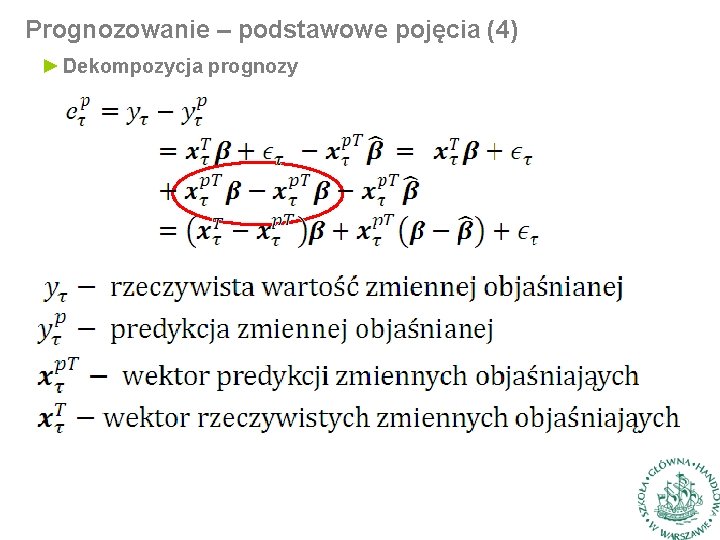
Prognozowanie – podstawowe pojęcia (4) ► Dekompozycja prognozy
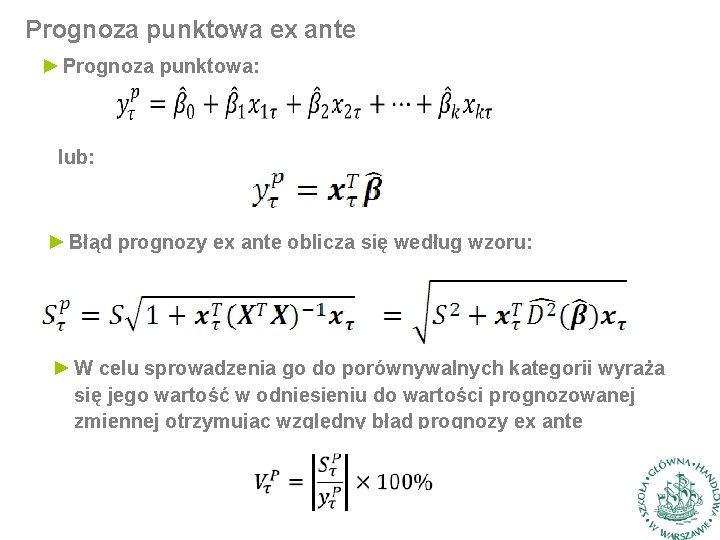
Prognoza punktowa ex ante ► Prognoza punktowa: lub: ► Błąd prognozy ex ante oblicza się według wzoru: ► W celu sprowadzenia go do porównywalnych kategorii wyraża się jego wartość w odniesieniu do wartości prognozowanej zmiennej otrzymując względny błąd prognozy ex ante
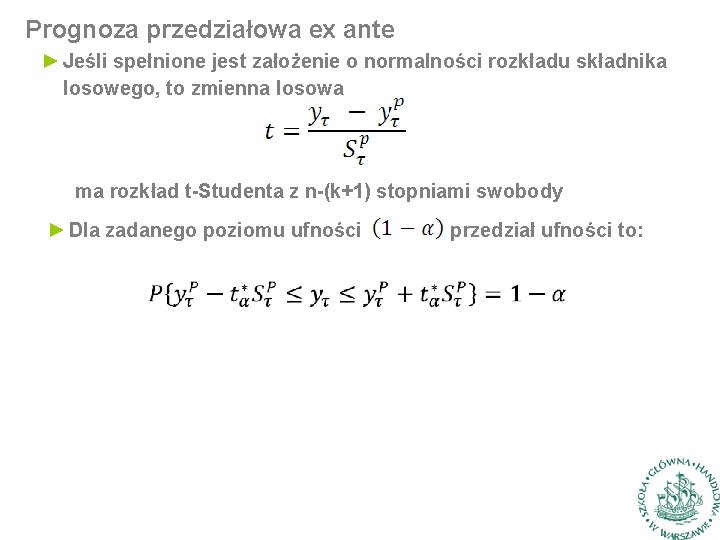
Prognoza przedziałowa ex ante ► Jeśli spełnione jest założenie o normalności rozkładu składnika losowego, to zmienna losowa ma rozkład t-Studenta z n-(k+1) stopniami swobody ► Dla zadanego poziomu ufności przedział ufności to:
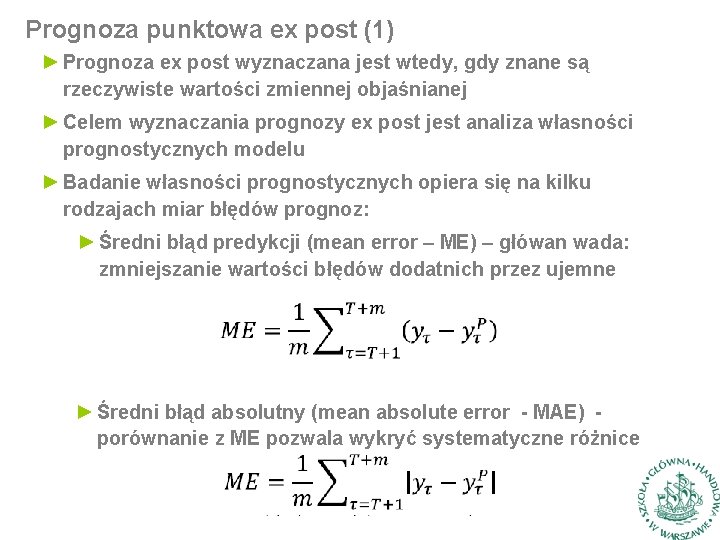
Prognoza punktowa ex post (1) ► Prognoza ex post wyznaczana jest wtedy, gdy znane są rzeczywiste wartości zmiennej objaśnianej ► Celem wyznaczania prognozy ex post jest analiza własności prognostycznych modelu ► Badanie własności prognostycznych opiera się na kilku rodzajach miar błędów prognoz: ► Średni błąd predykcji (mean error – ME) – główan wada: zmniejszanie wartości błędów dodatnich przez ujemne ► Średni błąd absolutny (mean absolute error - MAE) porównanie z ME pozwala wykryć systematyczne różnice
Prognoza punktowa ex post (2) ► Błąd średniokwadratowy (meand square error – MSE), w praktyce posługujemy się jego pierwiastkiem (RMSE); duże róznice w stosunku do MAE wskazują na pojawianie się bardzo dużych błędów prognozy ► Średni absolutny błąd procentowy (mean absolute percentage error - MAPE)
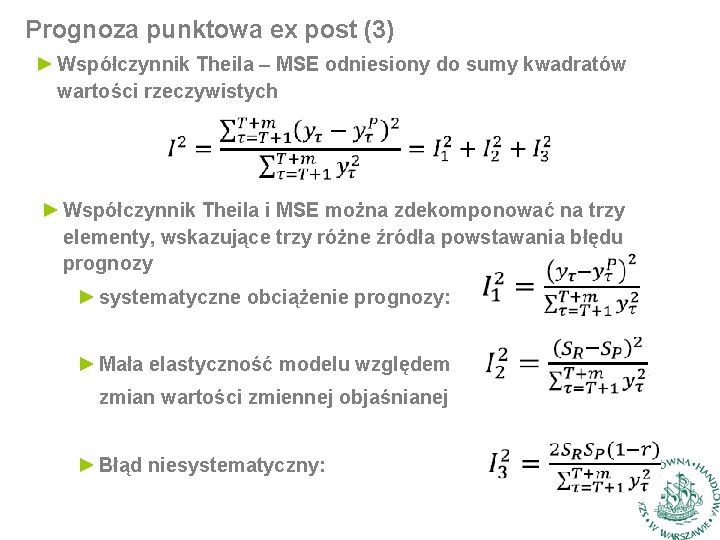
Prognoza punktowa ex post (3) ► Współczynnik Theila – MSE odniesiony do sumy kwadratów wartości rzeczywistych ► Współczynnik Theila i MSE można zdekomponować na trzy elementy, wskazujące trzy różne źródła powstawania błędu prognozy ► systematyczne obciążenie prognozy: ► Mała elastyczność modelu względem zmian wartości zmiennej objaśnianej ► Błąd niesystematyczny:
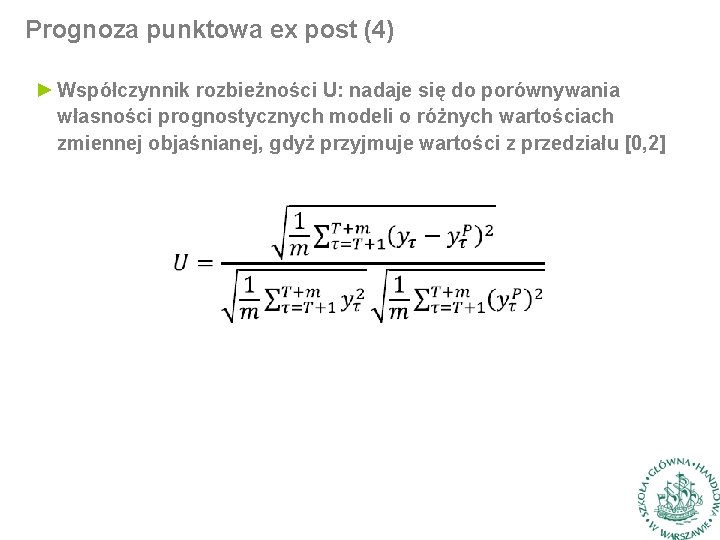
Prognoza punktowa ex post (4) ► Współczynnik rozbieżności U: nadaje się do porównywania własności prognostycznych modeli o różnych wartościach zmiennej objaśnianej, gdyż przyjmuje wartości z przedziału [0, 2]
Modele liniowe ► Modele liniowe względem parametrów i zmiennych np. : ► Modele liniowe względem parametrów, lecz nieliniowe względem zmiennych np. : lub w postaci ogólnej: ► Jeśli funkcja g (y)=y, to model jest bezpośrednio liniowy względem parametrów , w przeciwnym przypadku model jest linearyzowany np. lub po zlinearyzowaniu:
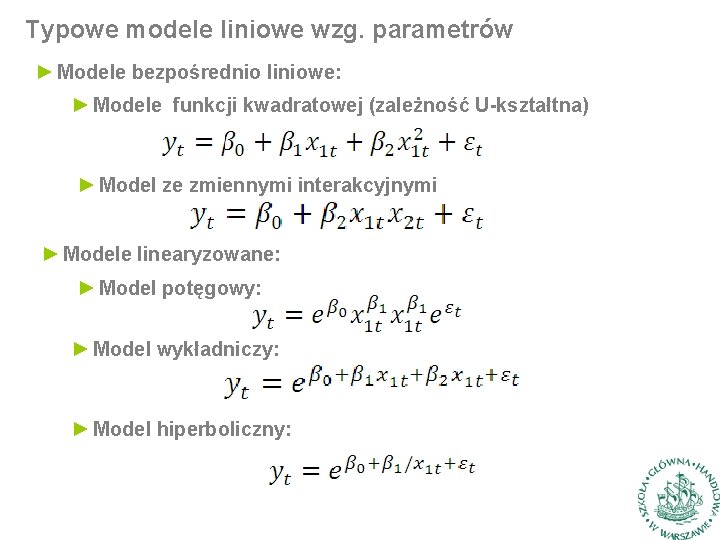
Typowe modele liniowe wzg. parametrów ► Modele bezpośrednio liniowe: ► Modele funkcji kwadratowej (zależność U-kształtna) ► Model ze zmiennymi interakcyjnymi ► Modele linearyzowane: ► Model potęgowy: ► Model wykładniczy: ► Model hiperboliczny:
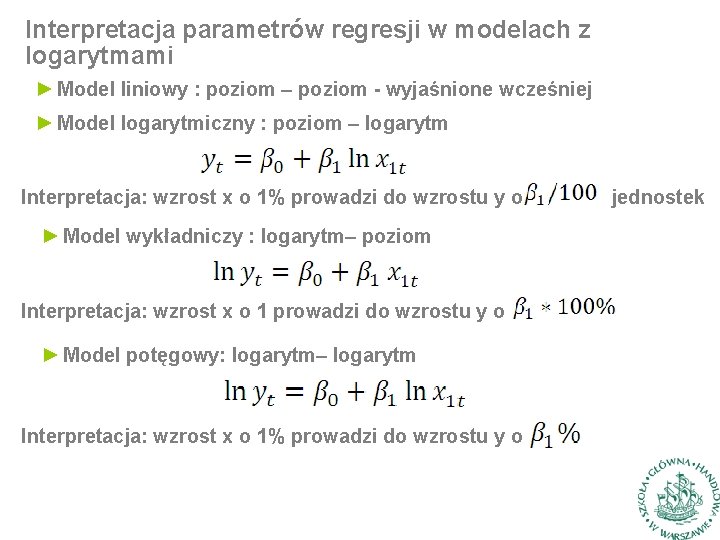
Interpretacja parametrów regresji w modelach z logarytmami ► Model liniowy : poziom – poziom - wyjaśnione wcześniej ► Model logarytmiczny : poziom – logarytm Interpretacja: wzrost x o 1% prowadzi do wzrostu y o ► Model wykładniczy : logarytm– poziom Interpretacja: wzrost x o 1 prowadzi do wzrostu y o ► Model potęgowy: logarytm– logarytm Interpretacja: wzrost x o 1% prowadzi do wzrostu y o jednostek
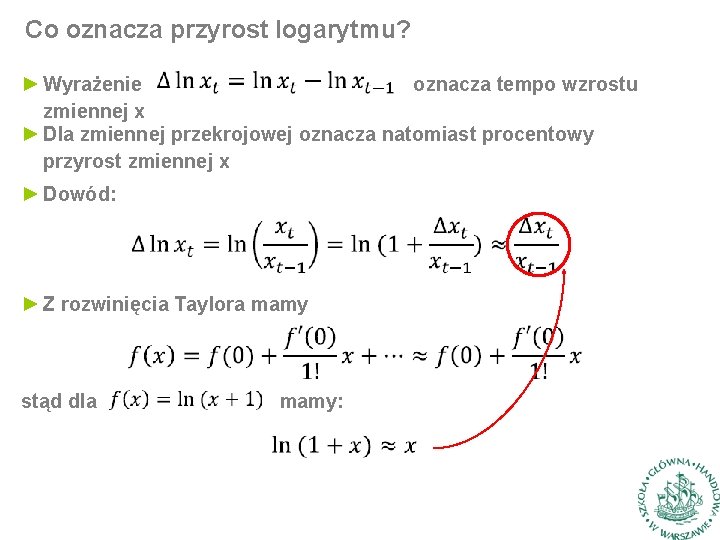
Co oznacza przyrost logarytmu? ► Wyrażenie oznacza tempo wzrostu zmiennej x ► Dla zmiennej przekrojowej oznacza natomiast procentowy przyrost zmiennej x ► Dowód: ► Z rozwinięcia Taylora mamy stąd dla mamy:
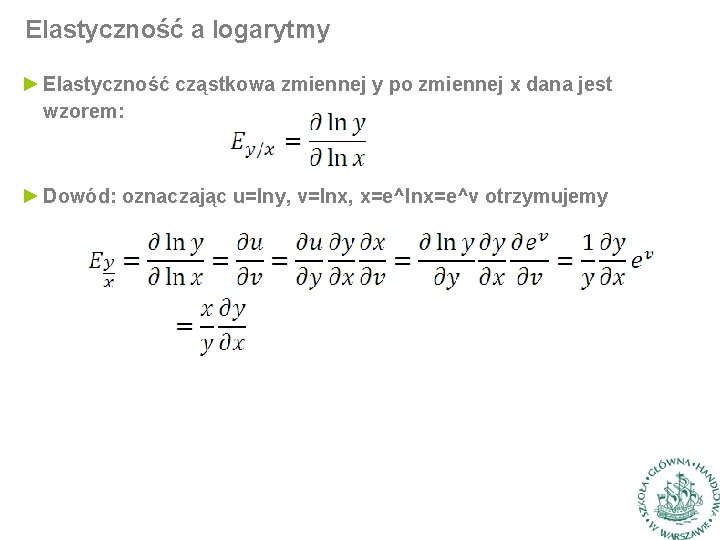
Elastyczność a logarytmy ► Elastyczność cząstkowa zmiennej y po zmiennej x dana jest wzorem: ► Dowód: oznaczając u=lny, v=lnx, x=e^lnx=e^v otrzymujemy
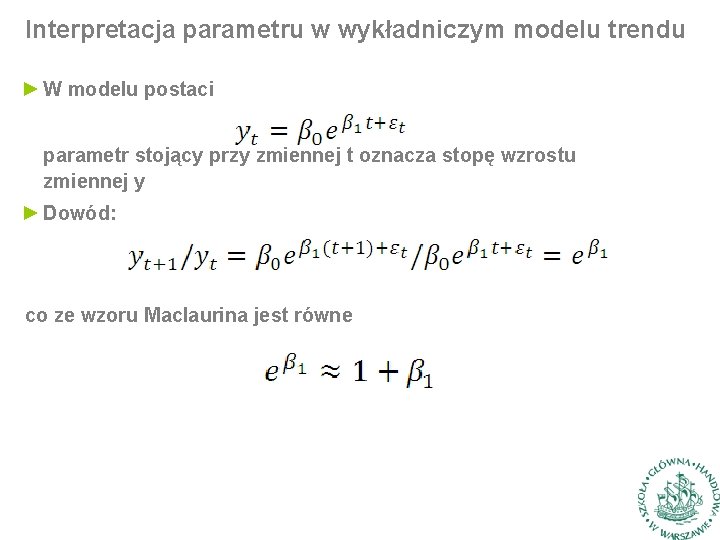
Interpretacja parametru w wykładniczym modelu trendu ► W modelu postaci parametr stojący przy zmiennej t oznacza stopę wzrostu zmiennej y ► Dowód: co ze wzoru Maclaurina jest równe
Przykład modelu ściśle nieliniowego – funkcja logistyczna ► Funkcja logistyczna to funkcja określona wzorem ► Wykres funkcji logistycznej postaci
Przykład modelu ściśle nieliniowego – funkcja logistyczna ► Własności funkcji logistycznej: ► parametr jest poziomem nasycenia zmiennej y, gdyż zachodzi : ► dla t= 0 funkcja przyjmuje ► punktem przegięcia funkcji jest ► funkcję można sformułować w innej wersji, w której przyjmuje wartość nasycenia równą 1, stąd nadaje się do modelowania prawdopodobieństwa (podstawa tzw. modelu logistycznego)
Dziękuję za uwagę