
Efterr 2003 Data Mining Henrik Bulskov Styltsvig Datalogiafdelingen
Efterår 2003 Data Mining Henrik Bulskov Styltsvig Datalogiafdelingen, hus 42. 1 Roskilde Universitetscenter Universitetsvej 1 Postboks 260 4000 Roskilde Telefon: 4674 2000 Fax: 4674 3072 www. dat. ruc. dk
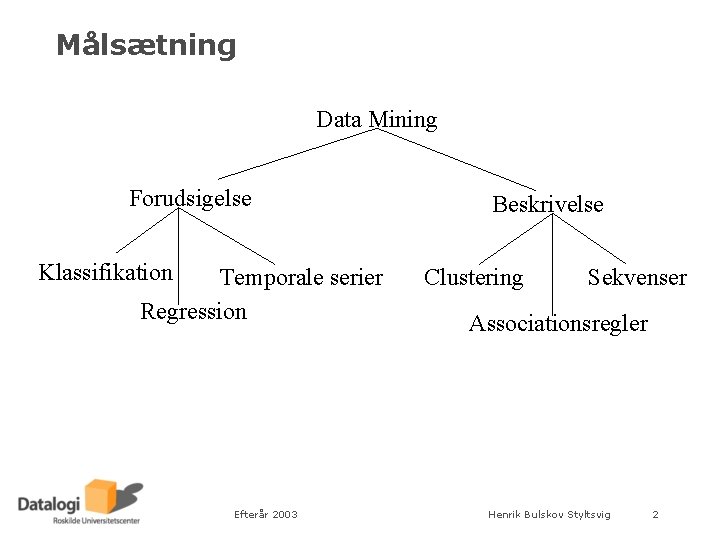
Målsætning Data Mining Forudsigelse Klassifikation Temporale serier Regression Efterår 2003 Beskrivelse Clustering Sekvenser Associationsregler Henrik Bulskov Styltsvig 2
Forudsigelse • Ved at tage udgangspunkt i kendt viden ønskes viden om fremtidige mønstre • • • Hvis man skal markedsføre et nyt produkt, hvem er så målgruppen? Hvilke varer skal placeres tæt på hinanden i et supermarked? Hvornår på året er det bedst at reklamere for et bestemt produkt? Efterår 2003 Henrik Bulskov Styltsvig 3
Forudsigelse - Nøjagtighed og dækning • Nøjagtighed (accuracy) og dækning (coverage) bruges til at beskrive sikkerheden i forudsigelsen. • Nøjagtighed beskriver hvor ofte de behandlede data opfylder forudsigelsen når betingelsen er opfyldt. • Dækning beskriver hvor stor del af en gruppering der dækkes. IF opsparing = ja & alder = 29 -39 & indkomst = 40 -59 K THEN gruppering 1 {nøjagtighed = 0. 8, dækning = 0. 5} Efterår 2003 Henrik Bulskov Styltsvig 4
Beskrivelse • Ønsket om at forstå eksisterende informationer på en ny måde • At udlede viden/mønstre fra eksisterende informationer, som ikke er allerede er kendt • Associationerne mellem emneord i afleveringsopgaven er et eksempel på dette Efterår 2003 Henrik Bulskov Styltsvig 5
Similaritet • For at kunne udføre data mining er det nødvendigt med en mulighed for at afgøre om/hvor meget to elementer ligner hinanden. • Numeriske værdier er naturligvis simple, men for booleske værdier og kategoriseringer skal der dannes mulighed for similaritet. Efterår 2003 Henrik Bulskov Styltsvig 6
Indlæring • Kontrolleret indlæring • Læring hvor indlæringsprocessen kontrolleres og • tilpasses facit Målet er at danne den model der bedst beskriver de givne informationer • Ukontrolleret indlæring • Læring hvor resultatet ikke er kendt på forhånd • Målet er en model der beskriver ny viden over de givne informationer Efterår 2003 Henrik Bulskov Styltsvig 7
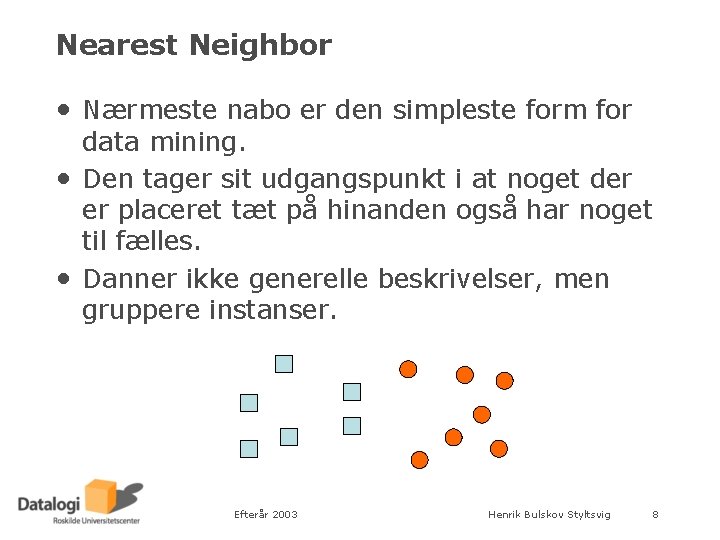
Nearest Neighbor • Nærmeste nabo er den simpleste form for data mining. • Den tager sit udgangspunkt i at noget der er placeret tæt på hinanden også har noget til fælles. • Danner ikke generelle beskrivelser, men gruppere instanser. Efterår 2003 Henrik Bulskov Styltsvig 8
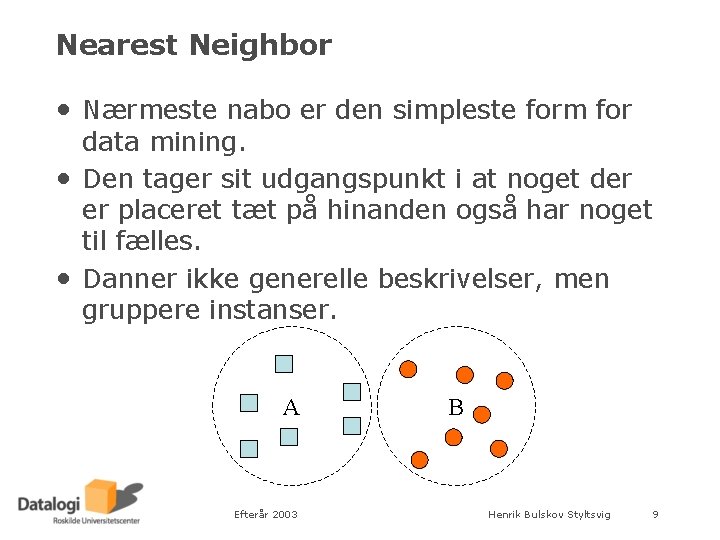
Nearest Neighbor • Nærmeste nabo er den simpleste form for data mining. • Den tager sit udgangspunkt i at noget der er placeret tæt på hinanden også har noget til fælles. • Danner ikke generelle beskrivelser, men gruppere instanser. A Efterår 2003 B Henrik Bulskov Styltsvig 9
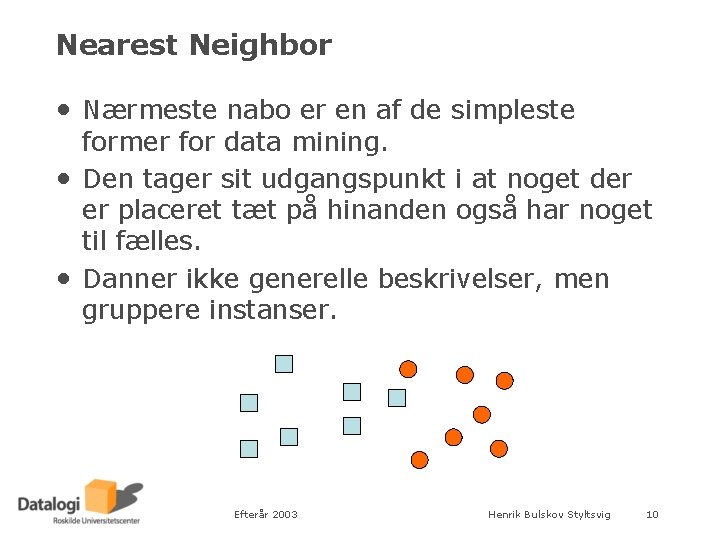
Nearest Neighbor • Nærmeste nabo er en af de simpleste former for data mining. • Den tager sit udgangspunkt i at noget der er placeret tæt på hinanden også har noget til fælles. • Danner ikke generelle beskrivelser, men gruppere instanser. Efterår 2003 Henrik Bulskov Styltsvig 10
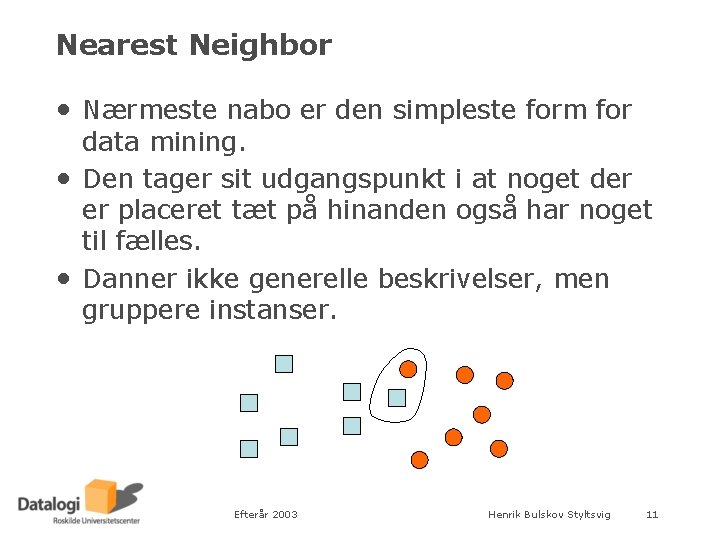
Nearest Neighbor • Nærmeste nabo er den simpleste form for data mining. • Den tager sit udgangspunkt i at noget der er placeret tæt på hinanden også har noget til fælles. • Danner ikke generelle beskrivelser, men gruppere instanser. Efterår 2003 Henrik Bulskov Styltsvig 11
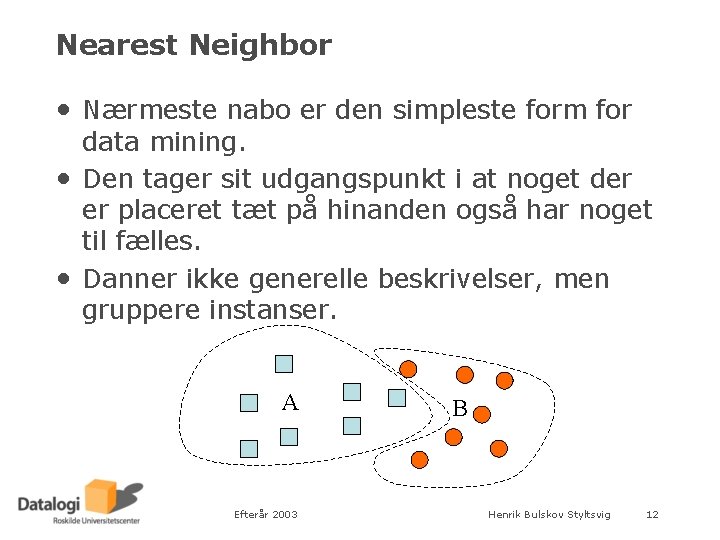
Nearest Neighbor • Nærmeste nabo er den simpleste form for data mining. • Den tager sit udgangspunkt i at noget der er placeret tæt på hinanden også har noget til fælles. • Danner ikke generelle beskrivelser, men gruppere instanser. A Efterår 2003 B Henrik Bulskov Styltsvig 12
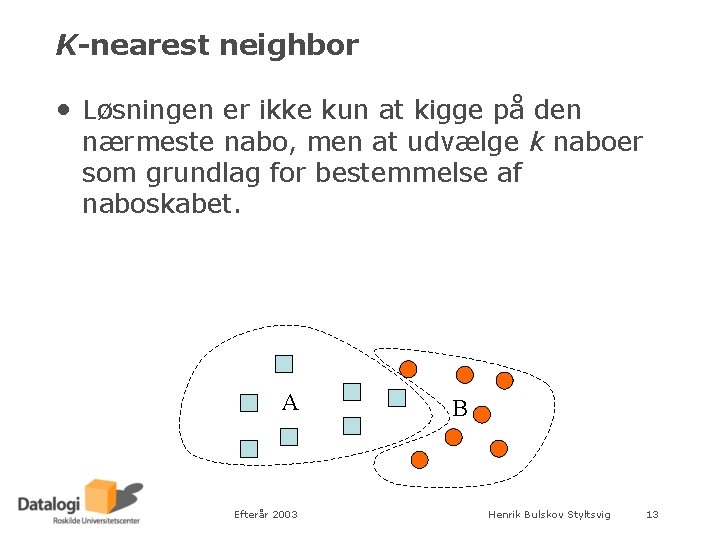
K-nearest neighbor • Løsningen er ikke kun at kigge på den nærmeste nabo, men at udvælge k naboer som grundlag for bestemmelse af naboskabet. A Efterår 2003 B Henrik Bulskov Styltsvig 13
Nearest Neighbor • Kan ikke bruges til at afgøre hvilke attributter der skal anvendes. • Er meget følsom for irrelevante attributter. • Er forholdsvis beregnings tung, hvilket dog kan optimeres ved at anvende prototypiske instanser som beskrivelse. • Giver ikke en generalisering af data, men der kan dannes generelle beskrivelser af klasserne ved at betragte en mængde af de mest typiske instanser i klasserne. Efterår 2003 Henrik Bulskov Styltsvig 14
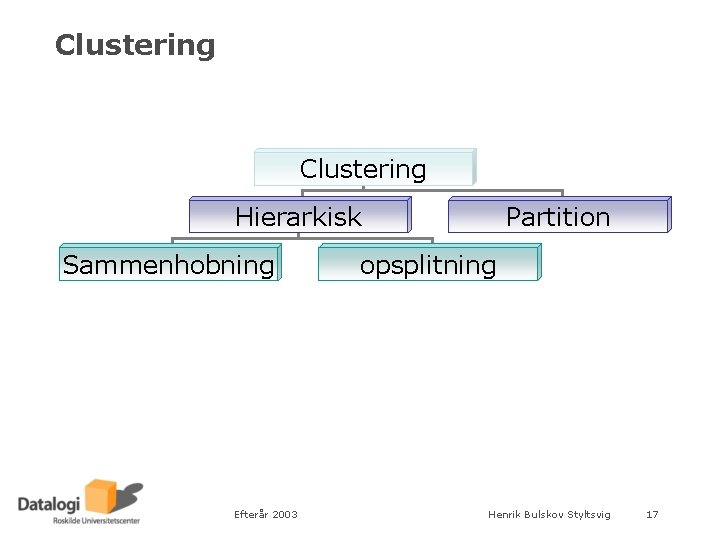
Clustering • Clustering er en metode til gruppering af data, uden på forhånd at kende noget til data. • Ofte anvendes clustering når der ønskes et overblik over en given datamængde. • Målet for en clustering kan både være at samle similar elementer i segmenter, eller at finde elementer der ikke passer ind – skiller sig ud. Efterår 2003 Henrik Bulskov Styltsvig 15
Clustering – formel definition • Database D = {t 1, t 2, …, tn} • K = antallet af clusters • ƒ : D {1, …, k} hvor hver ti er indeholdt i cluster Kj, 1 ≤ j ≥ k. • Et cluster kj indeholder netop de tupler som kan tildeles med ƒ, hvilket er ki = {ti | ƒ(ti) = kj, 1 ≤ j ≥ k og ti D}. Efterår 2003 Henrik Bulskov Styltsvig 16
Clustering Hierarkisk Sammenhobning Efterår 2003 Partition opsplitning Henrik Bulskov Styltsvig 17
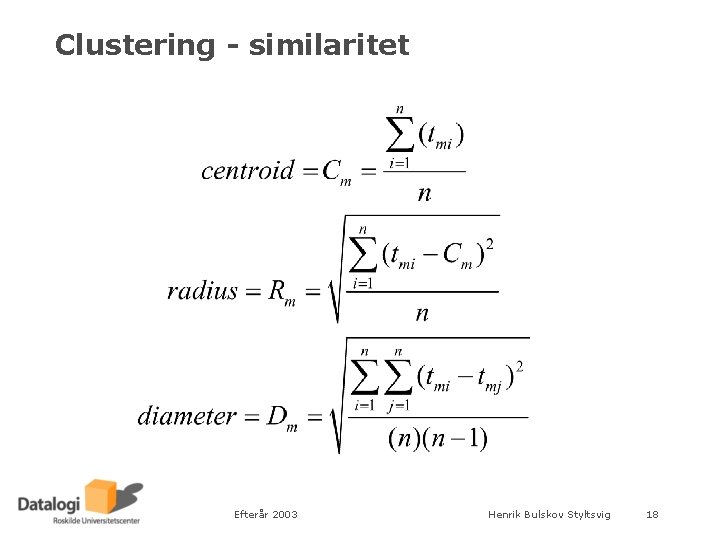
Clustering - similaritet Efterår 2003 Henrik Bulskov Styltsvig 18
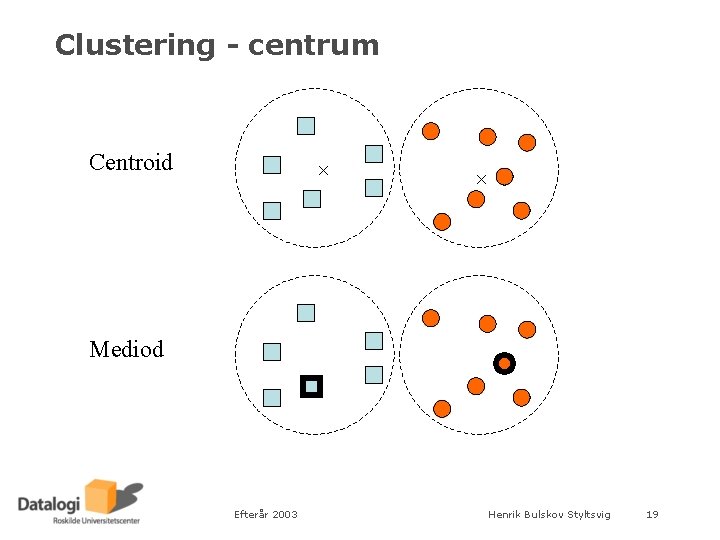
Clustering - centrum Centroid × × Mediod Efterår 2003 Henrik Bulskov Styltsvig 19
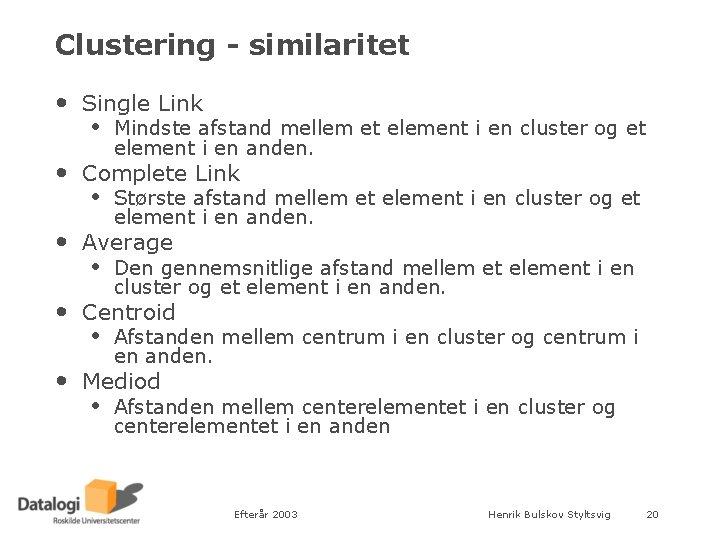
Clustering - similaritet • Single Link • Mindste afstand mellem et element i en cluster og et element i en anden. • Complete Link • Største afstand mellem et element i en cluster og et element i en anden. • Average • Den gennemsnitlige afstand mellem et element i en cluster og et element i en anden. • Centroid • Afstanden mellem centrum i en cluster og centrum i en anden. • Mediod • Afstanden mellem centerelementet i en cluster og centerelementet i en anden Efterår 2003 Henrik Bulskov Styltsvig 20
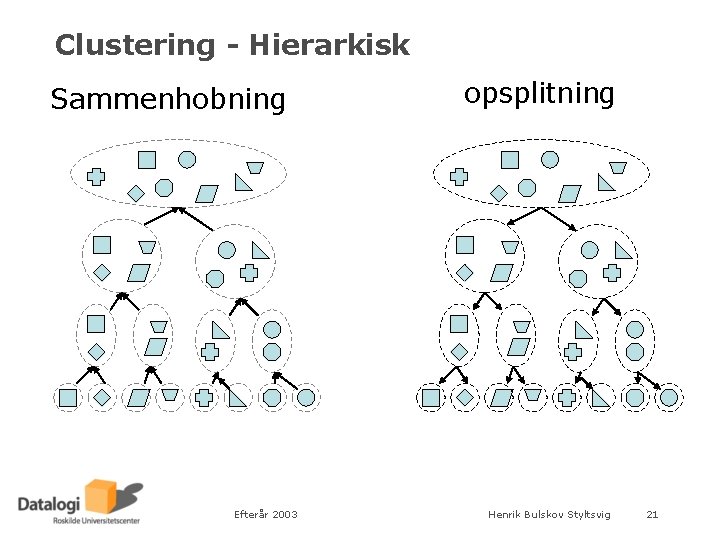
Clustering - Hierarkisk Sammenhobning Efterår 2003 opsplitning Henrik Bulskov Styltsvig 21
Clustering - partition • Giver kun en mængde af clusters. • Der gives det antal clusters der ønskes. • 19 elementer kan deles i 4 clusters på 11. 259. 666. 000 måder!!! • • Squared error K-Means Nearest neighbor PAM(partition around mediods) Efterår 2003 Henrik Bulskov Styltsvig 22
Decision Trees • DT er ofte anvendt til klassifikation. • Udgangspunktet er en database med {A 1, …, An} attributter og {K 1, …, kn} klasser. • Hver knude (ikke blade) har en attribut som etiket. • Hver kant er et prædikat der kan tildeles til forældre knudens attribut. • Hver blad-knude har en klasse som etiket. Efterår 2003 Henrik Bulskov Styltsvig 23
Decision Trees • Målet med DT er at hver knude deler søgemulighederne i to lige store dele. • Valg af splittende attributter • Valget af hvilke attributter der skal anvendes til at opdele efter kræver analyse af træningsdata og ofte inddragelse af ekspert viden. • Rækkefølgen af splittende attributter • Rækkefølgen er vigtig, idet rækkefølgen bestemmer dybden af træet. Efterår 2003 Henrik Bulskov Styltsvig 24
Decision Trees • Antallet af gang der skal opdeles • Ved simple attributter, såsom køn, er det oplagt hvor mange delinger en given attribut behøver, men ved mere komplekse domæner kan det være meget vanskeligt at afgøre. • Træ strukturen • Et balanceret træ med mindst højde er at fortrække • Stop betingelser • Optimalt skal der først stoppes når træningsdata er perfekt klassificeret, men det kan være nødvendigt at stoppe før ved store træer. Efterår 2003 Henrik Bulskov Styltsvig 25
Decision Trees • Træningsdata • Strukturen i DT bestemmes af træningsdata, er disse for små er træet måske ikke generelt nok, mens det hvis datamængden er for stort måske bliver overfittet. • Beskæring • Efter dannelse af et DT kan det være nødvendigt at modificere strukturen af optimeringshensyn. Efterår 2003 Henrik Bulskov Styltsvig 26
Neural Networks • NN bliver ofte brugt til klassifikation. • Målet er at afgøre hvilket output der kan • • forventes fra et givent input. NN skal oplæres med træningsdata. NN er robust overfor støj og manglende input NN kan fortsætte med at lære efter den egentlig træningsfase. For at benytte NN skal antallet af output knuder afgøres, og hvilke attributter der skal benyttes i input. Efterår 2003 Henrik Bulskov Styltsvig 27
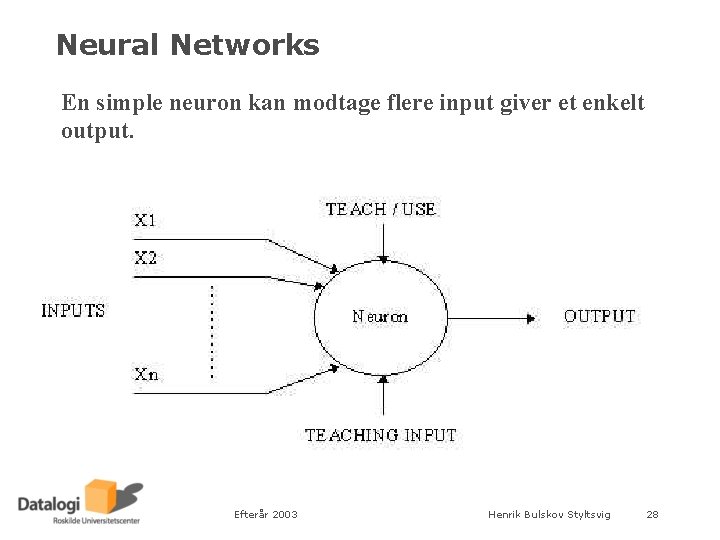
Neural Networks En simple neuron kan modtage flere input giver et enkelt output. Efterår 2003 Henrik Bulskov Styltsvig 28
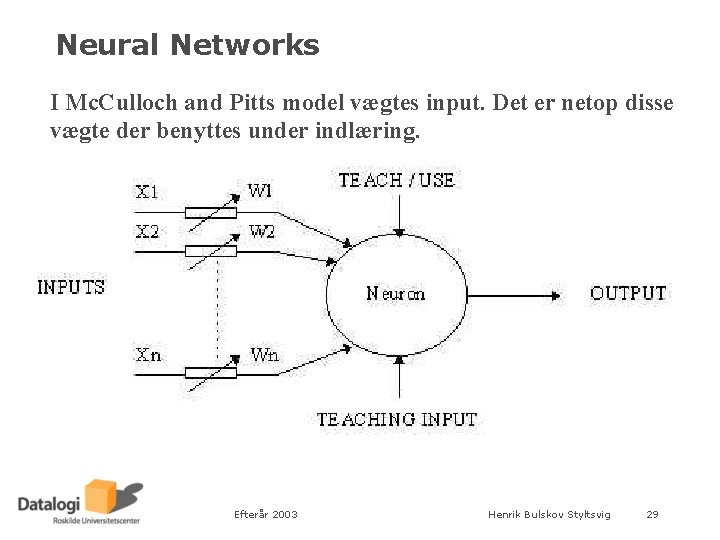
Neural Networks I Mc. Culloch and Pitts model vægtes input. Det er netop disse vægte der benyttes under indlæring. Efterår 2003 Henrik Bulskov Styltsvig 29
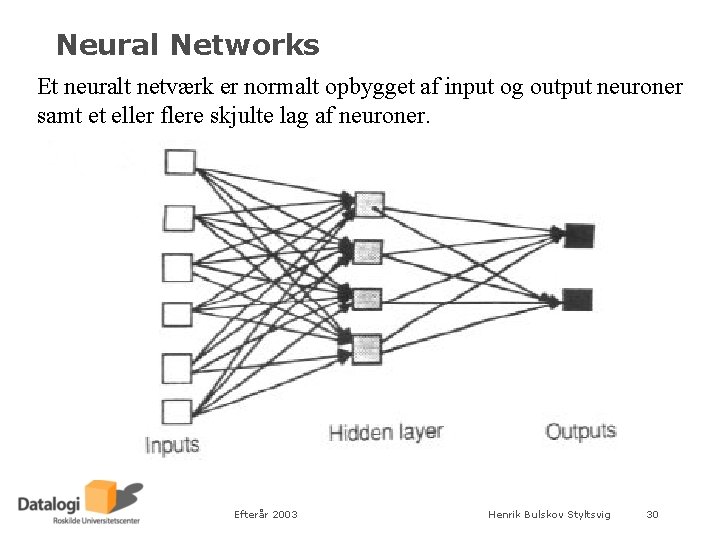
Neural Networks Et neuralt netværk er normalt opbygget af input og output neuroner samt et eller flere skjulte lag af neuroner. Efterår 2003 Henrik Bulskov Styltsvig 30
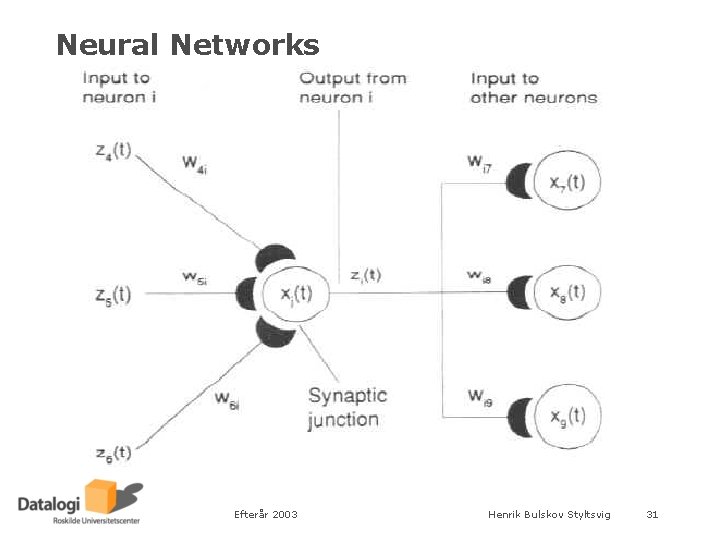
Neural Networks Efterår 2003 Henrik Bulskov Styltsvig 31
Neural Networks • Aktiveringsfunktion • Aktiveringsfunktionen bestemmer hvilke mønstre det neurale netværk kan genkende. Ofte anvendes logistiske funktioner. • Læringsrate • Læringsraten bestemmer hvor store udsving der kan være i indlæringsprocessen. Små udsving betyder en længere læringsproces og fare for at finde lokale minimum, for store udsving fare for at overse mønstret. • Antal neuroner • Antallet af neuroner bestemmer hvor mange attributter netværket kan inddrage. Problemet med for mange er overfitting, mens for få kan give et for generelt netværk. Efterår 2003 Henrik Bulskov Styltsvig 32
Neural Networks • • • NN er vanskelige at forstå og overskue. Det er vanskeligt at udlede regler fra NN. Input skal være numerisk. Testning af NN er omfattende Det er vanskeligt at verificere NN Det er måske ikke mulig at få et NN til at konvergere • Det kan være kostbart at anvende NN Efterår 2003 Henrik Bulskov Styltsvig 33
Associationsregler • Associationsregler er implikationer. • Implikationerne kan være komplekse IF A & B & C Z IF A & B X & Z & Q • Selvom associationsregler er implikationer er disse ikke kausale. Efterår 2003 Henrik Bulskov Styltsvig 34
Associationsregler • Nøjagtighed • Dækning Regel Nøjagtighed Dækning If breakfast cereal purchased then milk purchased. 85% 20% If bread purchased then Swiss cheese purchased. 15% 6% If 42 years old and purchased pretzels and purchased dry roasted peanuts then beer will be purchased. 95% 0, 01% Efterår 2003 Henrik Bulskov Styltsvig 35
Associationsregler • Beskrivelse • Makroniveau – kan beskrive sammenhænge • mellem attributter og kan opsummere. Mikroniveau – Meget detaljerede regler kan udledes og specifikke konsekvenser undersøges. • Forudsigelser • Regler kan også benyttes til forudsigelser. Hver regel kan benyttes til forudsigelse og konsekvensen og nøjagtigheden definere udfaldet og forudsigelsens nøjagtighed. Efterår 2003 Henrik Bulskov Styltsvig 36
- Slides: 36