
Dveloppement dune Machine dApprentissage Automatique Ahmed CHIKHAOUI Mars
- Slides: 16
Développement d’une Machine d’Apprentissage Automatique Ahmed CHIKHAOUI Mars 2020 Département de l’Informatique Université Ibn Khaldoune Tiaret Algérie M. L. : Donner à une machine la capacité d’apprendre sans la programmer de façon explicite. Chikhaoui Tiaret Algeria 1
Introduction Nous allons apprendre à développer notre premier modèle de Machine Learning. Ce premier modèle est un modèle de régression linéaire. Pourquoi la régression linéaire parce que le processus qu’on va mettre en place pour placer la droite au milieu d’un nuage de points est exactement le même que celui qu’on va développer pour un modèle de reconnaissance vocale, de reconnaissance de spams, … La régression linéaire est le modèle le plus simple pour débuter en M. L. : Donner à une machine la capacité d’apprendre sans la programmer de façon explicite. Chikhaoui Tiaret Algeria 2
Rappels sur le Machine Learning Le Data. Set est toujours formé d’exemples; chaque exemple est composé de deux variables X et Y. Qui sont généralement des vecteurs. Y est la variable cible (target), c’est la variable à expliquer. C’est elle qu’on voudrait que la machine apprenne à prédire. Exemples : • prédire le prix d’un appartement, • prédire si un e-mail est un spam ou pas …. ; X est la variable explicative (composée de facteurs ou features), c’est elle qui influence la valeur de Y. Y est une fonction de X. Y=f(X)=f(x 1, x 2, …, xn-1, xn). M. L. : Donner à une machine la capacité d’apprendre sans la programmer de façon explicite. Chikhaoui Tiaret Algeria 3
Rappels sur le Machine Learning Les quatre notions fondamentales du Machine Learning en apprentissage supervisé 1. le Data. Set : qui contient deux types de variables Y la target (sortie) et X les features (entrées). 2. Le modèle : qu’on donne à la machine avec les paramètres qu’elle doit apprendre. 3. La fonction coût : qui est l’ensemble des erreurs entre les prédictions de notre modèle et les vraies valeurs y du Data. Set. 1. L’algorithme d’apprentissage : c’est lui qui cherche à minimiser la fonction coût en trouvant les meilleures valeurs des paramètres a, b, c, …. M. L. : Donner à une machine la capacité d’apprendre sans la programmer de façon explicite. Chikhaoui Tiaret Algeria 4
Remarques importantes A chaque fois que vous avez à résoudre un problème d’apprentissage supervisé, écrivez sur papier ces quatre étapes : 1. Quelles sont les dimensions de votre Data. Set ? • Combien y’a de lignes (exemples) ? • Combien y’a de colonnes (facteurs) ? 2. Quel est le modèle que vous cher à développer ? 3. Quelle est la fonction coût à minimiser ? M. L. : Donner à une machine la capacité d’apprendre sans la programmer de façon explicite. Chikhaoui Tiaret Algeria 5
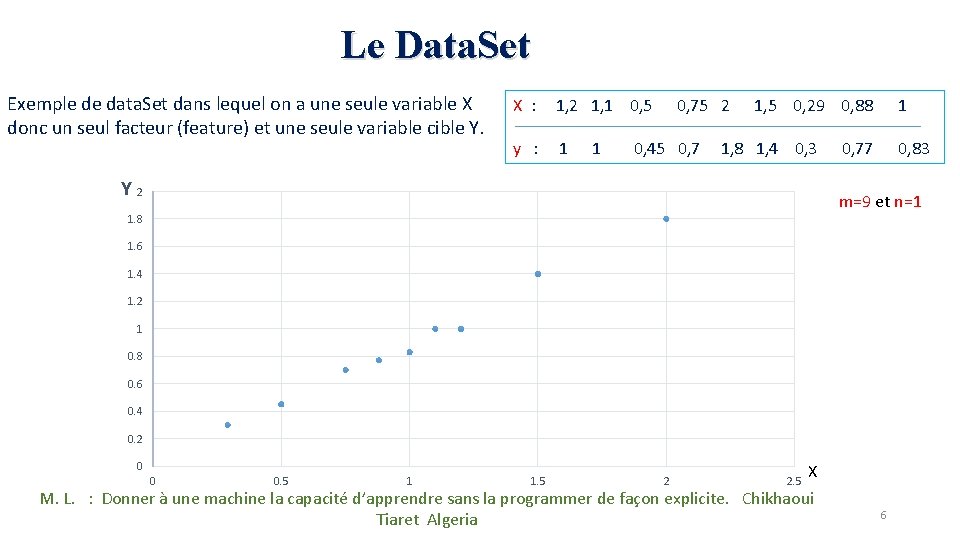
Le Data. Set Exemple de data. Set dans lequel on a une seule variable X donc un seul facteur (feature) et une seule variable cible Y. X : 1, 2 1, 1 0, 5 y : 1 1 0, 75 2 0, 45 0, 7 1, 5 0, 29 0, 88 1, 4 0, 3 Y 2 1 0, 77 0, 83 m=9 et n=1 1. 8 1. 6 1. 4 1. 2 1 0. 8 0. 6 0. 4 0. 2 0 0 0. 5 1 1. 5 2 2. 5 X M. L. : Donner à une machine la capacité d’apprendre sans la programmer de façon explicite. Chikhaoui Tiaret Algeria 6
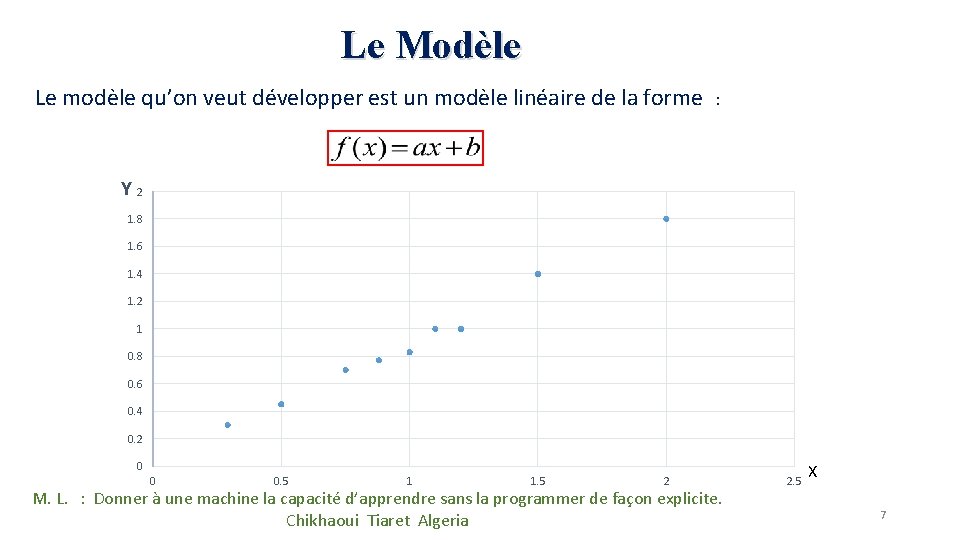
Le Modèle Le modèle qu’on veut développer est un modèle linéaire de la forme : Y 2 1. 8 1. 6 1. 4 1. 2 1 0. 8 0. 6 0. 4 0. 2 0 0 0. 5 1 1. 5 2 M. L. : Donner à une machine la capacité d’apprendre sans la programmer de façon explicite. Chikhaoui Tiaret Algeria 2. 5 X 7
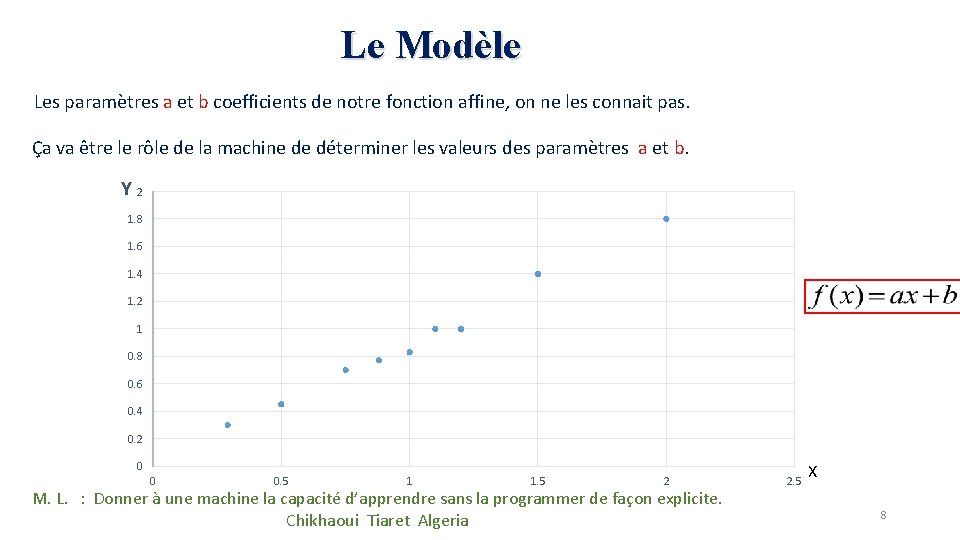
Le Modèle Les paramètres a et b coefficients de notre fonction affine, on ne les connait pas. Ça va être le rôle de la machine de déterminer les valeurs des paramètres a et b. Y 2 1. 8 1. 6 1. 4 1. 2 1 0. 8 0. 6 0. 4 0. 2 0 0 0. 5 1 1. 5 2 M. L. : Donner à une machine la capacité d’apprendre sans la programmer de façon explicite. Chikhaoui Tiaret Algeria 2. 5 X 8
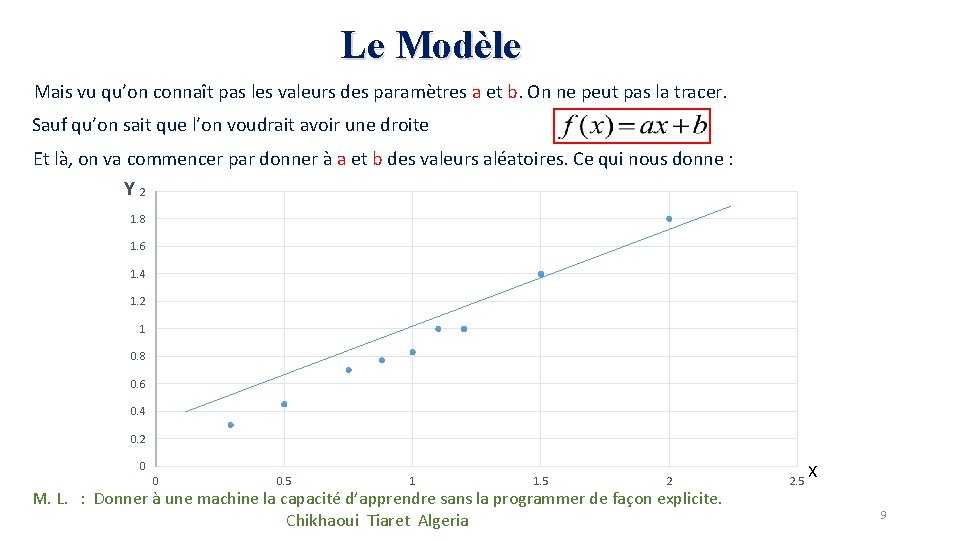
Le Modèle Mais vu qu’on connaît pas les valeurs des paramètres a et b. On ne peut pas la tracer. Sauf qu’on sait que l’on voudrait avoir une droite Et là, on va commencer par donner à a et b des valeurs aléatoires. Ce qui nous donne : Y 2 1. 8 1. 6 1. 4 1. 2 1 0. 8 0. 6 0. 4 0. 2 0 0 0. 5 1 1. 5 2 M. L. : Donner à une machine la capacité d’apprendre sans la programmer de façon explicite. Chikhaoui Tiaret Algeria 2. 5 X 9
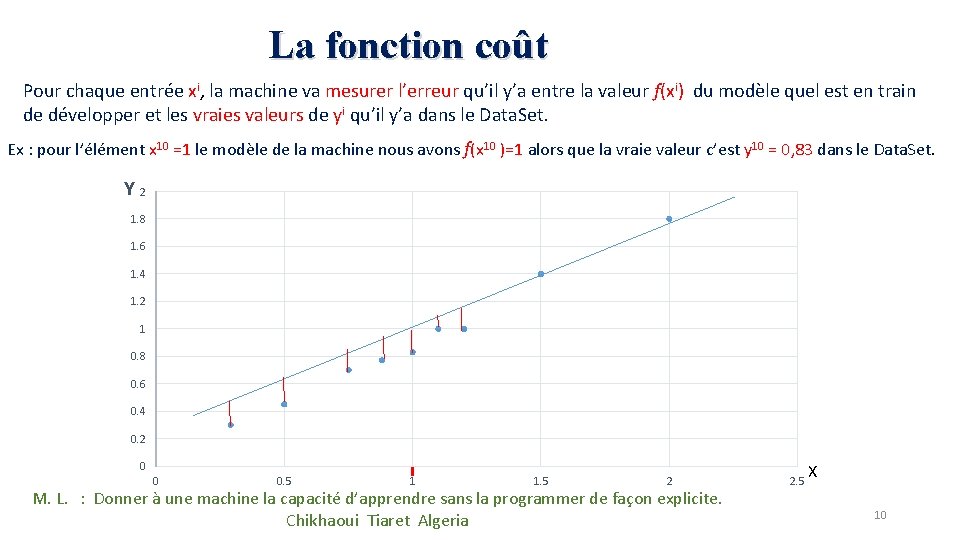
La fonction coût Pour chaque entrée xi, la machine va mesurer l’erreur qu’il y’a entre la valeur f(xi) du modèle quel est en train de développer et les vraies valeurs de yi qu’il y’a dans le Data. Set. Ex : pour l’élément x 10 =1 le modèle de la machine nous avons f(x 10 )=1 alors que la vraie valeur c’est y 10 = 0, 83 dans le Data. Set. Y 2 1. 8 1. 6 1. 4 1. 2 1 0. 8 0. 6 0. 4 0. 2 0 0 0. 5 1 1. 5 2 M. L. : Donner à une machine la capacité d’apprendre sans la programmer de façon explicite. Chikhaoui Tiaret Algeria 2. 5 X 10
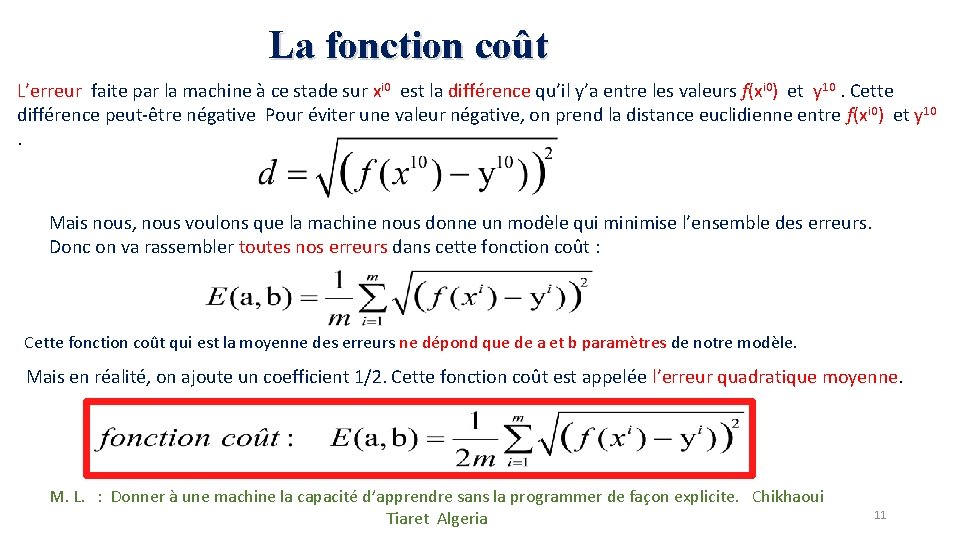
La fonction coût L’erreur faite par la machine à ce stade sur xi 0 est la différence qu’il y’a entre les valeurs f(xi 0) et y 10. Cette différence peut-être négative Pour éviter une valeur négative, on prend la distance euclidienne entre f(xi 0) et y 10. Mais nous, nous voulons que la machine nous donne un modèle qui minimise l’ensemble des erreurs. Donc on va rassembler toutes nos erreurs dans cette fonction coût : Cette fonction coût qui est la moyenne des erreurs ne dépond que de a et b paramètres de notre modèle. Mais en réalité, on ajoute un coefficient 1/2. Cette fonction coût est appelée l’erreur quadratique moyenne. M. L. : Donner à une machine la capacité d’apprendre sans la programmer de façon explicite. Chikhaoui Tiaret Algeria 11
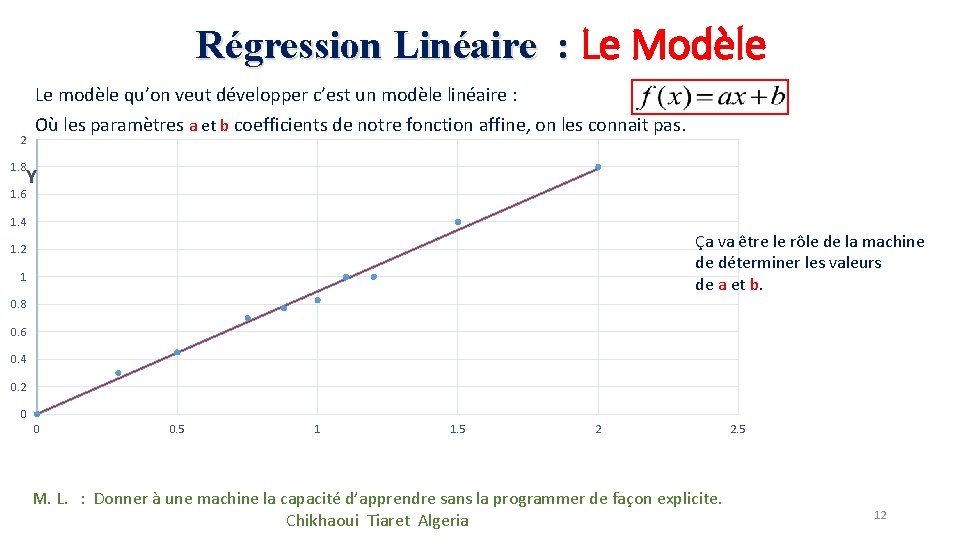
Régression Linéaire : Le Modèle M. L. : Donner à une machine la capacité d’apprendre sans la programmer de façon explicite. Chikhaoui Tiaret Algeria 12
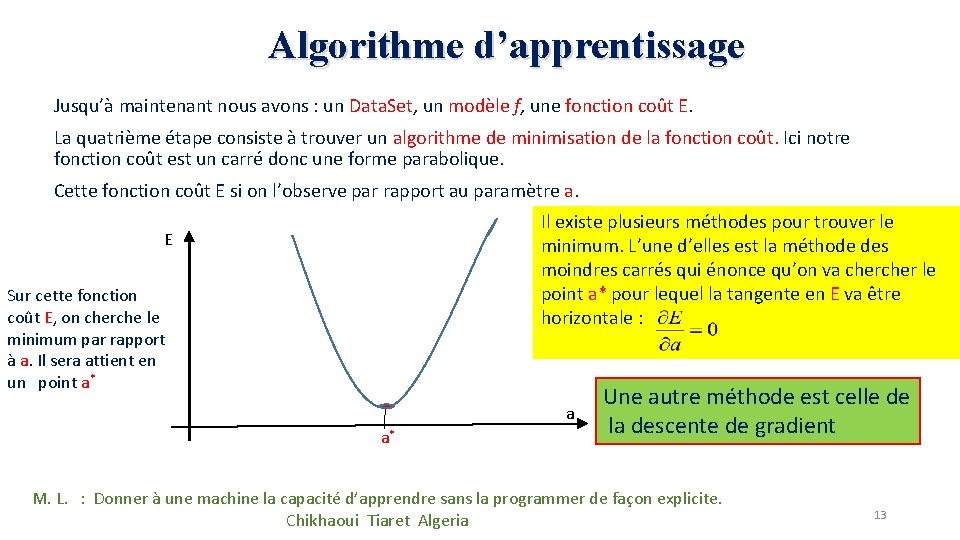
Algorithme d’apprentissage Jusqu’à maintenant nous avons : un Data. Set, un modèle f, une fonction coût E. La quatrième étape consiste à trouver un algorithme de minimisation de la fonction coût. Ici notre fonction coût est un carré donc une forme parabolique. Cette fonction coût E si on l’observe par rapport au paramètre a. Il existe plusieurs méthodes pour trouver le minimum. L’une d’elles est la méthode des moindres carrés qui énonce qu’on va cher le point a* pour lequel la tangente en E va être horizontale : E Sur cette fonction coût E, on cherche le minimum par rapport à a. Il sera attient en un point a* a a* Une autre méthode est celle de la descente de gradient M. L. : Donner à une machine la capacité d’apprendre sans la programmer de façon explicite. Chikhaoui Tiaret Algeria 13
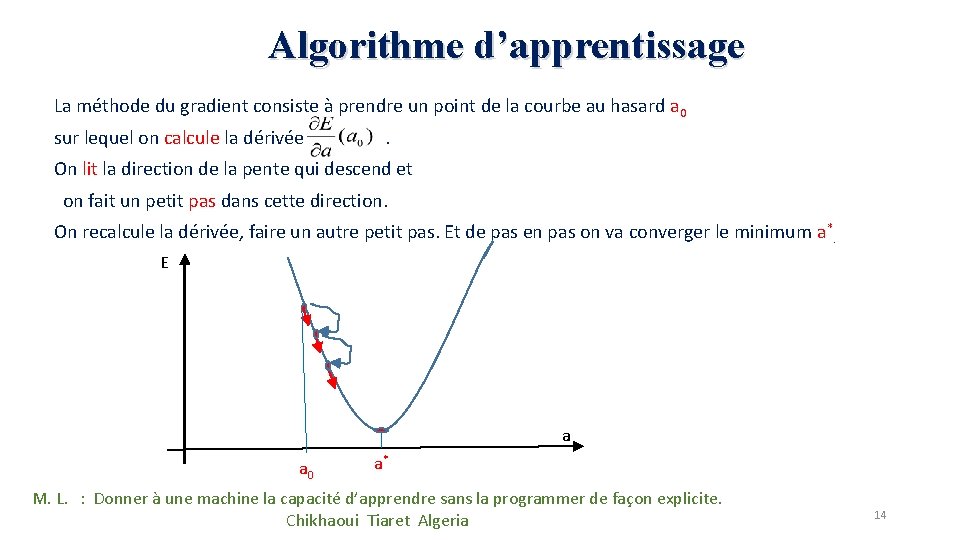
Algorithme d’apprentissage La méthode du gradient consiste à prendre un point de la courbe au hasard a 0 sur lequel on calcule la dérivée . On lit la direction de la pente qui descend et on fait un petit pas dans cette direction. On recalcule la dérivée, faire un autre petit pas. Et de pas en pas on va converger le minimum a*. E a a 0 a* M. L. : Donner à une machine la capacité d’apprendre sans la programmer de façon explicite. Chikhaoui Tiaret Algeria 14
Conclusion • Utiliser la méthode des moindres carrées implique des inversions de matrices. Chose facile quand la dimension est petite mais avec des dimensions de plusieurs centaines voir de milliers ce qui est le cas en M. L. , inverser des matrices peut prendre plusieurs années. • C’est pour cela qu’on préfère la méthode de la descente de gradient que nous étudierons dans le prochain ultérieurement. • On a vu comment développer un modèle linéaire et comment déterminer la fonction coût associée à ce modèle linéaire. M. L. : Donner à une machine la capacité d’apprendre sans la programmer de façon explicite. Chikhaoui Tiaret Algeria 15
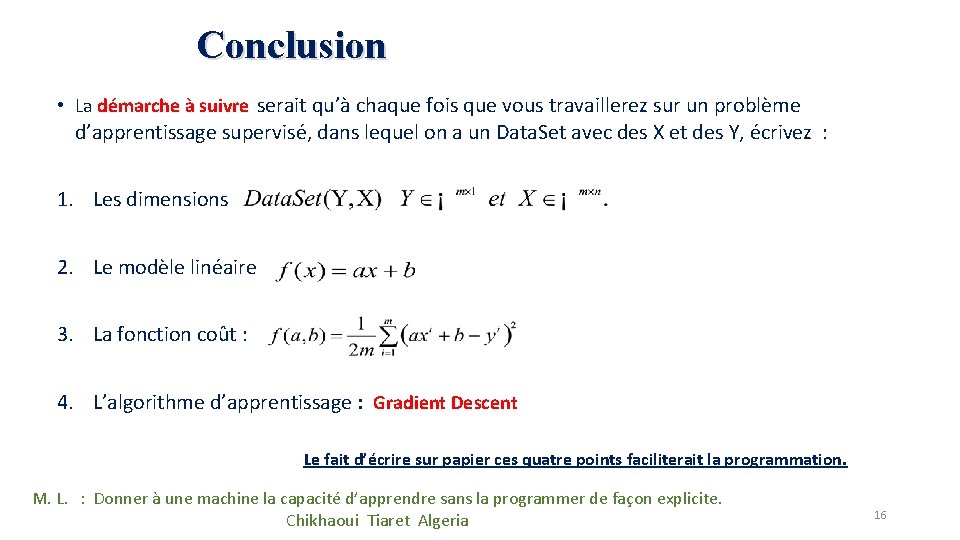
Conclusion • La démarche à suivre serait qu’à chaque fois que vous travaillerez sur un problème d’apprentissage supervisé, dans lequel on a un Data. Set avec des X et des Y, écrivez : 1. Les dimensions 2. Le modèle linéaire 3. La fonction coût : 4. L’algorithme d’apprentissage : Gradient Descent Le fait d’écrire sur papier ces quatre points faciliterait la programmation. M. L. : Donner à une machine la capacité d’apprendre sans la programmer de façon explicite. Chikhaoui Tiaret Algeria 16