
Dischi RAID M Arrigoni Neri P Borghese 130513
Dischi RAID M. Arrigoni Neri & P. Borghese 13/05/13 Ingegneria Dalmine “Impianti Informatici” RAID - 1
indice dischi RAID § caratteristiche delle tipologie (livelli) di RAID § prestazioni § affidabilità § qualche esempio di calcolo Ingegneria Dalmine “Impianti Informatici” RAID - 2
http: //www. ecs. umass. edu/ece/koren/architecture/Raid/raidhome. html a questo indirizzo trovate molte informazioni interessanti compresi: tool di calcolo dell’efficienza di storage tool per la reliability Ingegneria Dalmine “Impianti Informatici” RAID - 3
Redundant Arrays of Independent (Inexpensive) Disks § più dischi fisici indipendenti visti come un unico disco logico di grande capacità ed elevate prestazioni § i dati sono distribuiti su più dischi (striping) striping che sono acceduti in parallelo ottenendo: § elevato transfer rate per accessi che movimentano grandi quantità § § di dati (operazioni di I/O pesanti) elevato I/O rate per accessi in parallelo a piccole quantità di dati (operazioni di I/O leggere) load balancing tra i vari dischi in modo automatico § si utilizzano due tecniche antitetiche § striping dei dati: per aumentare le prestazioni § ridondanza: ridondanza per aumentare l’affidabilità Ingegneria Dalmine “Impianti Informatici” RAID - 4
Redundant Arrays of Independent (Inexpensive) Disks (cont. ) § possono essere realizzati sia con hardware dedicato sia con software che usa hardware standard (esistono anche soluzioni ibride) § soluzioni software richiedono costi aggiuntivi (cicli di CPU) § soluzioni hardware § richiedono unità di controllo specializzate che eseguono i calcoli di parità; § hanno in genere prestazioni migliori (dipendenti dalla dimensione della cache e da quanto rapidamente i dati vengono scaricati sui dischi); § supportano hot swapping (i dischi possono essere sostituiti e ricostruiti anche in modo automatico mentre il sistema è in esercizio) Ingegneria Dalmine “Impianti Informatici” RAID - 5
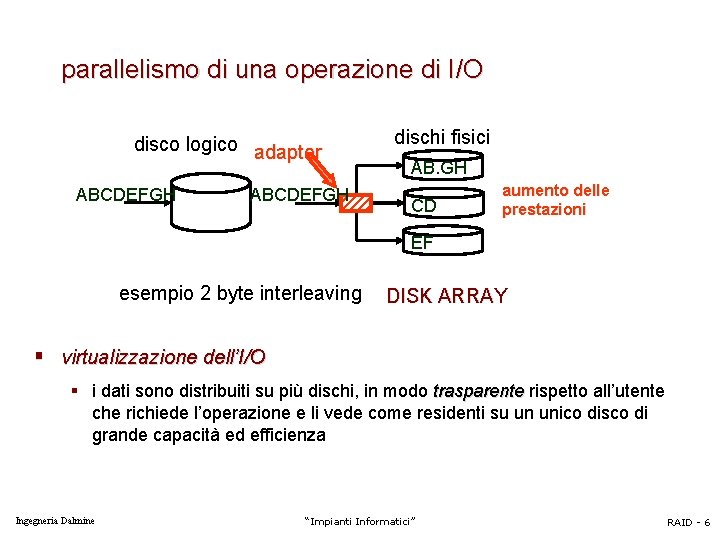
parallelismo di una operazione di I/O disco logico adapter ABCDEFGH dischi fisici AB. GH CD aumento delle prestazioni EF esempio 2 byte interleaving DISK ARRAY § virtualizzazione dell’I/O § i dati sono distribuiti su più dischi, in modo trasparente rispetto all’utente che richiede l’operazione e li vede come residenti su un unico disco di grande capacità ed efficienza Ingegneria Dalmine “Impianti Informatici” RAID - 6
data striping § striping: striping tecnica di suddivisione dei dati che logicamente appaiono come scritti sequenzialmente (un vettore, un file, . . . ) in segmenti (unità di stripe: bit, byte, blocchi) che vengono scritti su più dischi fisici con un algoritmo ciclico (round robin) robin § unità di stripe: stripe il più piccolo segmento di dati contigui che può essere letto (scritto) da (su) un disco in ogni accesso § stripe width: width numero di dischi usati dall’algoritmo di striping (non coincide necessariamente col numero di dischi fisici nell’array) § più richieste indipendenti vengono eseguite in parallelo su dischi diversi § si riduce il tempo di accodamento delle richieste di I/O ai dischi § una singola richiesta di I/O per blocchi multipli può essere servita da più dischi che operano in modo coordinato § il parallelismo aumenta il transfer rate (numero di byte trasferiti al secondo) per richiesta e, se i dispositivi sono sincronizzati, si riduce la latenza effettiva Ingegneria Dalmine “Impianti Informatici” RAID - 7
data striping (cont. ) § la dimensione dell’unità di stripe è una caratteristica importante per le prestazioni: § una unità piccola può dare luogo a singole richieste che si distribuiscono su più dischi con un aumento del numero di operazioni di I/O e di dischi occupati, il prefetching è meno efficace dal momento che dati che sarebbero contigui su un disco si trovano fisicamente dispersi e mescolati con quelli di altri dischi; § d’altronde così diminuisce la probabilità di avere un sottoinsieme di dischi con utilizzo asimmetrico (access skew) skew § si riduce l’estensione dei seek queste osservazioni spiegano qualitativamente la forma della curva del tempo di risposta dell’operazione di I/O in funzione della unità di stripe l’unità fisica di I/O è la stripe unit non l’intera stripe Ingegneria Dalmine “Impianti Informatici” RAID - 8
parallelismo e affidabilità (reliability) più elevato è il numero di dischi dell’array, maggiori sono i benefici prestazionali ma minore è l’affidabilità dell’intero disk array (cioè maggiore è la probabilità di un guasto) per questo motivo viene introdotta la ridondanza se un blocco (o un intero disco fisico) è corrotto (o si è guastato) può essere ricostruito dalle informazioni ridondanti presenti sugli altri dischi un array di 100 dischi ha probabilità di guastarsi uguale a 100 volte quella di un singolo disco Ingegneria Dalmine “Impianti Informatici” RAID - 9
parallelismo e affidabilità (reliability) (cont. ) § se un disco ha un MTTF (Mean Time To Failure) di 200. 000 ore (~23 anni) un array di 100 dischi avrà un MTTF di 2. 000 ore (~ 3 mesi) § ridondanza dei dati scritti: permette la correzione/ricostruzione di eventuali errori/perdite di dati con tecniche di codici a correzione di errore che utilizzano informazioni ridondanti scritte su dischi diversi da quelli sui quali vengono scritti i dati originari § le operazioni di scrittura devono aggiornare anche le informazioni ridondanti, quindi sono generalmente più lente delle tipiche operazioni di write Ingegneria Dalmine “Impianti Informatici” RAID - 10
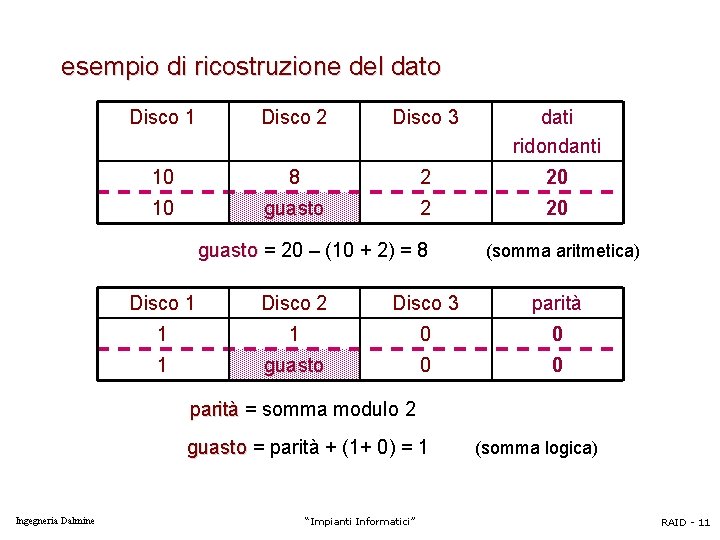
esempio di ricostruzione del dato Disco 1 Disco 2 Disco 3 dati ridondanti 10 8 2 20 10 guasto 2 20 guasto = 20 – (10 + 2) = 8 (somma aritmetica) Disco 1 Disco 2 Disco 3 parità 1 1 0 0 1 guasto 0 0 parità = somma modulo 2 guasto = parità + (1+ 0) = 1 Ingegneria Dalmine “Impianti Informatici” (somma logica) RAID - 11
tipi di RAID la maggior parte dei RAID può essere classificata secondo le seguenti caratteristiche: § la granularità di interleaving dei dati (unità di stripe) § il metodo per il calcolo delle informazioni ridondanti § scelta del metodo per distribuire le informazioni ridondanti tra i dischi dell’array § § Ingegneria Dalmine distribuzione delle informazioni ridondanti su un numero limitato di dischi utilizzo di tutti i dischi disponibili in modo uniforme per allocare le informazioni ridondanti (più difficile da realizzare ma ottimizza il bilanciamento del carico) “Impianti Informatici” RAID - 12
data interleaving: fine grained § i dati sono interleaved in piccole unità in modo tale che tutte le richieste di I/O (indipendentemente dalle loro dimensioni) possono utilizzare tutti i dischi dell’array § più elevato transfer rate per tutte le richieste di I/O § una sola richiesta logica di I/O può essere servita ad ogni istante di tempo (perché vengono utilizzati molti dischi) § tutti i dischi possono perdere parecchio tempo per motivi di posizionamento ad ogni richiesta Ingegneria Dalmine “Impianti Informatici” RAID - 13
data interleaving: coarse grained § i dati sono interleaved in (relativamente) grandi unità in modo tale che tutte le richieste di I/O di piccole dimensioni necessitano soltanto di pochi dischi mentre grandi richieste di I/O possono utilizzare tutti i dischi dell’array § richieste di I/O piccole possono essere eseguite in modo concorrente § richieste di I/O grandi possono avere elevato transfer rate in quanto usano molti dischi in parallelo Ingegneria Dalmine “Impianti Informatici” RAID - 14
tipologie di RAID Ingegneria Dalmine “Impianti Informatici” RAID - 15
i livelli di RAID § RAID 0 striping (manca ridondanza) § RAID 1 mirroring (completa duplicazione) § RAID 0+1 § RAID 1+0 (ibrido livelli annidati) § § RAID 2 bit interleaving (non usato) RAID 3 byte interleaving - ridondanza (disco di parità) RAID 4 block interleaving - ridondanza (dischi di parità) RAID 5 block interleaving - ridondanza (blocchi di parità distribuiti) - il più usato § RAID 5+0 (ibrido livelli annidati) § RAID 6 maggiore ridondanza (tollera 2 dischi guasti) § RAID 7 (soluzioni proprietarie) Ingegneria Dalmine “Impianti Informatici” RAID - 16
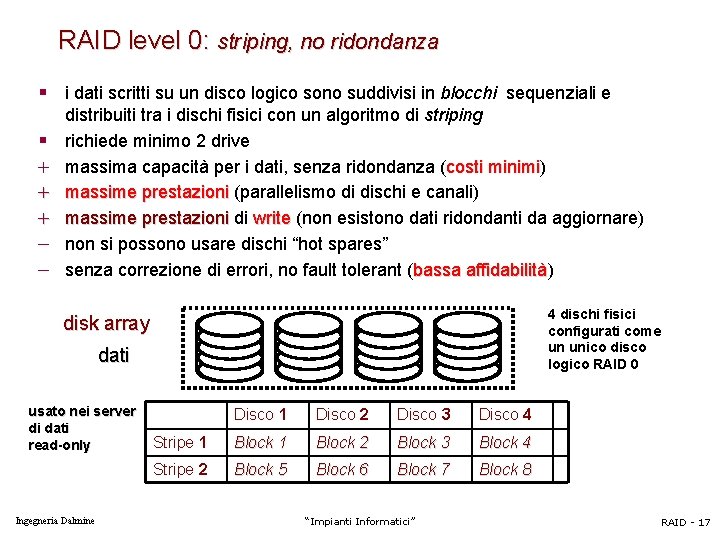
RAID level 0: striping, no ridondanza § i dati scritti su un disco logico sono suddivisi in blocchi sequenziali e distribuiti tra i dischi fisici con un algoritmo di striping § richiede minimo 2 drive + massima capacità per i dati, senza ridondanza (costi minimi) minimi + massime prestazioni (parallelismo di dischi e canali) + massime prestazioni di write (non esistono dati ridondanti da aggiornare) - non si possono usare dischi “hot spares” - senza correzione di errori, no fault tolerant (bassa affidabilità) affidabilità 4 dischi fisici configurati come un unico disco logico RAID 0 disk array dati usato nei server di dati read-only Ingegneria Dalmine Disco 1 Disco 2 Disco 3 Disco 4 Stripe 1 Block 2 Block 3 Block 4 Stripe 2 Block 5 Block 6 Block 7 Block 8 “Impianti Informatici” RAID - 17
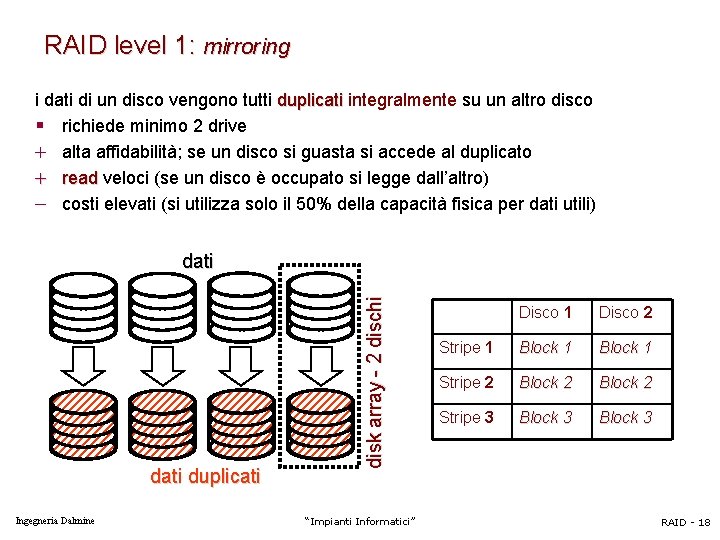
RAID level 1: mirroring i dati di un disco vengono tutti duplicati integralmente su un altro disco § richiede minimo 2 drive + alta affidabilità; se un disco si guasta si accede al duplicato + read veloci (se un disco è occupato si legge dall’altro) - costi elevati (si utilizza solo il 50% della capacità fisica per dati utili) dati duplicati Ingegneria Dalmine disk array - 2 dischi dati “Impianti Informatici” Disco 1 Disco 2 Stripe 1 Block 1 Stripe 2 Block 2 Stripe 3 Block 3 RAID - 18
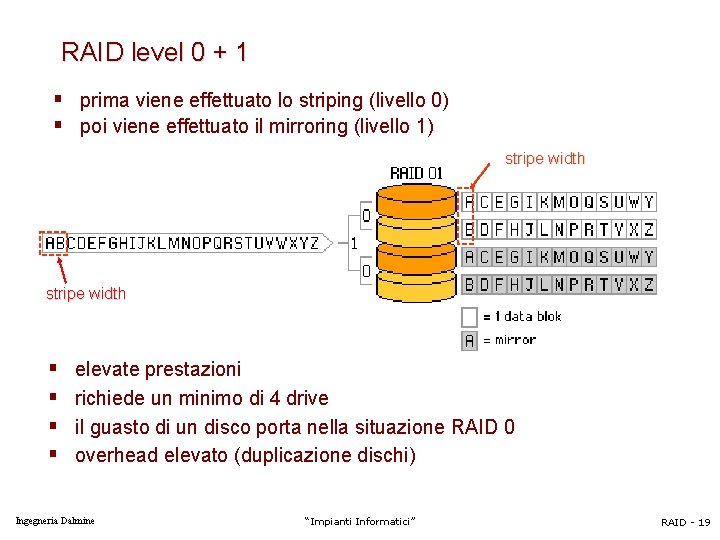
RAID level 0 + 1 § prima viene effettuato lo striping (livello 0) § poi viene effettuato il mirroring (livello 1) stripe width § § elevate prestazioni richiede un minimo di 4 drive il guasto di un disco porta nella situazione RAID 0 overhead elevato (duplicazione dischi) Ingegneria Dalmine “Impianti Informatici” RAID - 19
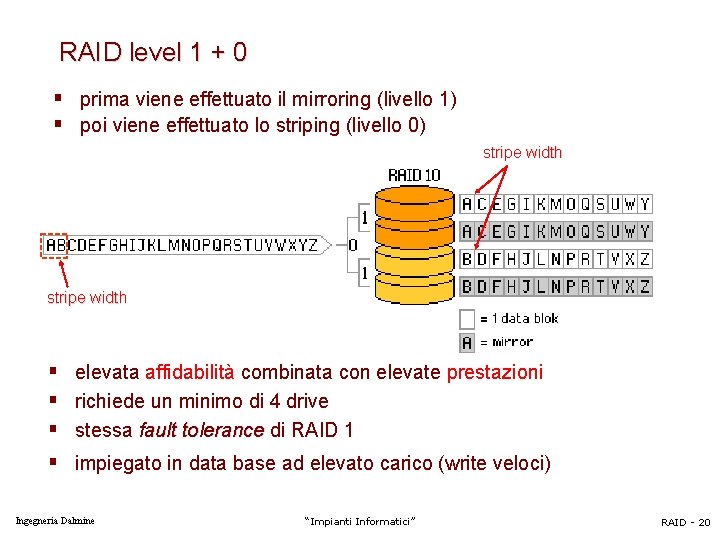
RAID level 1 + 0 § prima viene effettuato il mirroring (livello 1) § poi viene effettuato lo striping (livello 0) stripe width § § elevata affidabilità combinata con elevate prestazioni richiede un minimo di 4 drive stessa fault tolerance di RAID 1 impiegato in data base ad elevato carico (write veloci) Ingegneria Dalmine “Impianti Informatici” RAID - 20
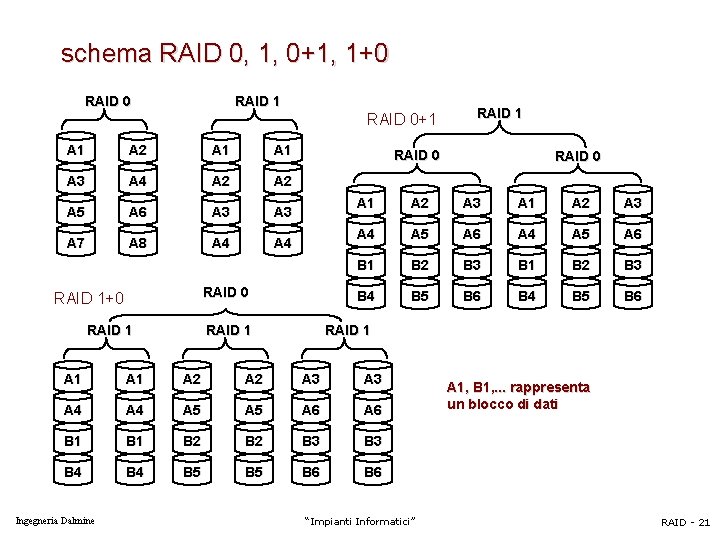
schema RAID 0, 1, 0+1, 1+0 RAID 1 RAID 0+1 A 2 A 1 A 3 A 4 A 2 A 5 A 6 A 3 A 7 A 8 A 4 RAID 1+0 RAID 1 RAID 0 A 1 A 2 A 3 A 4 A 5 A 6 B 1 B 2 B 3 RAID 0 B 4 B 5 B 6 RAID 1 A 1 A 2 A 3 A 4 A 5 A 6 B 1 B 2 B 3 B 4 B 5 B 6 Ingegneria Dalmine RAID 1 “Impianti Informatici” A 1, B 1, . . . rappresenta un blocco di dati RAID - 21
confronto livelli 0+1, 1+0 § la disposizione dei blocchi è identica se non per i dischi che sono in un diverso ordine § alcuni controller 0+1 combinano in un’unica operazione striping e mirroring § 0+1 § non tollera due guasti simultanei (eccetto nel caso in cui interessino la stessa stripe) § nel caso di guasto a un singolo disco, il dato mancante è recuperato dall’altro gruppo RAID 1, ogni meccanismo dell’altra stripe è un single point of failure § il ripristino di un disco richiede la partecipazione di tutti i dischi dell’array § 1+0 § un disco per ogni gruppo RAID 1 può guastarsi ma se non riparato, il suo mirror diviene single point of failure dell’intero array Ingegneria Dalmine “Impianti Informatici” RAID - 22
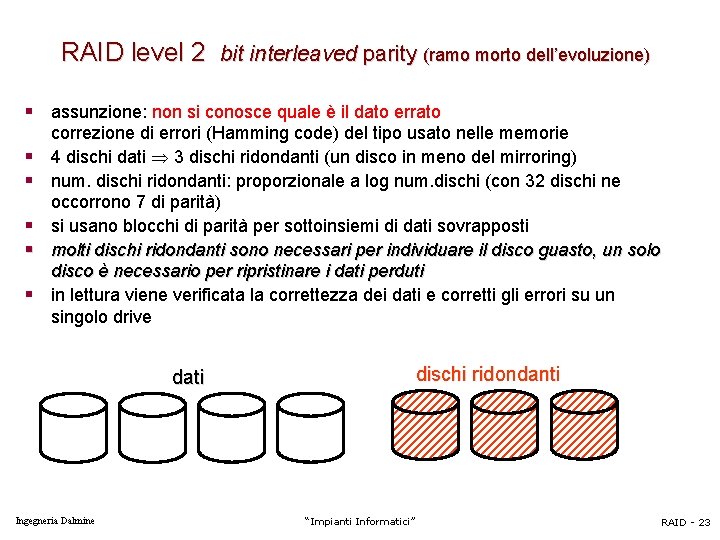
RAID level 2 bit interleaved parity (ramo morto dell’evoluzione) § assunzione: non si conosce quale è il dato errato § § § correzione di errori (Hamming code) del tipo usato nelle memorie 4 dischi dati 3 dischi ridondanti (un disco in meno del mirroring) num. dischi ridondanti: proporzionale a log num. dischi (con 32 dischi ne occorrono 7 di parità) si usano blocchi di parità per sottoinsiemi di dati sovrapposti molti dischi ridondanti sono necessari per individuare il disco guasto, un solo disco è necessario per ripristinare i dati perduti in lettura viene verificata la correttezza dei dati e corretti gli errori su un singolo drive dischi ridondanti dati Ingegneria Dalmine “Impianti Informatici” RAID - 23
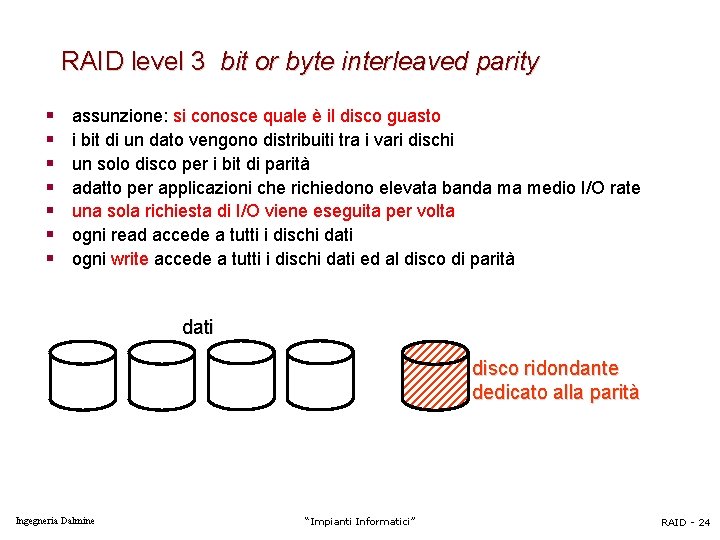
RAID level 3 bit or byte interleaved parity § § § § assunzione: si conosce quale è il disco guasto i bit di un dato vengono distribuiti tra i vari dischi un solo disco per i bit di parità adatto per applicazioni che richiedono elevata banda ma medio I/O rate una sola richiesta di I/O viene eseguita per volta ogni read accede a tutti i dischi dati ogni write accede a tutti i dischi dati ed al disco di parità dati disco ridondante dedicato alla parità Ingegneria Dalmine “Impianti Informatici” RAID - 24
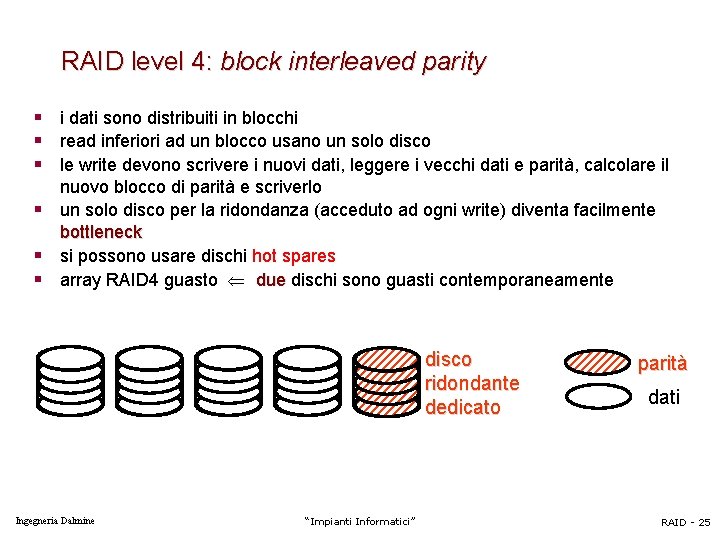
RAID level 4: block interleaved parity § i dati sono distribuiti in blocchi § read inferiori ad un blocco usano un solo disco § le write devono scrivere i nuovi dati, leggere i vecchi dati e parità, calcolare il nuovo blocco di parità e scriverlo § un solo disco per la ridondanza (acceduto ad ogni write) diventa facilmente bottleneck § si possono usare dischi hot spares § array RAID 4 guasto due dischi sono guasti contemporaneamente disco ridondante dedicato Ingegneria Dalmine “Impianti Informatici” parità dati RAID - 25
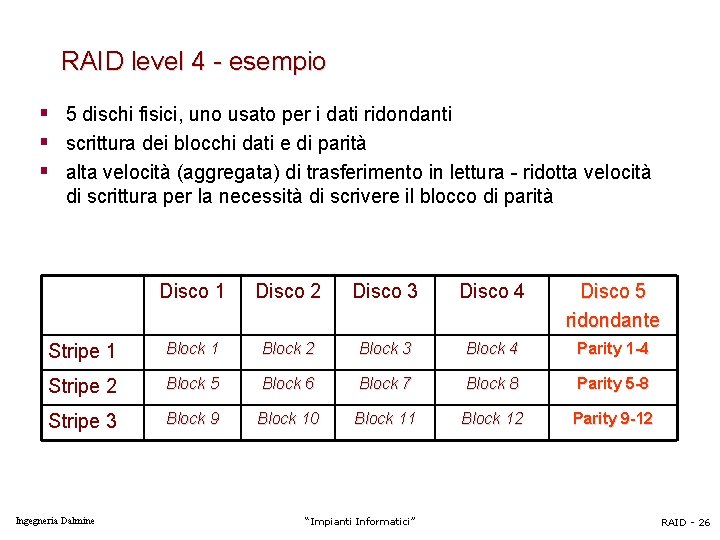
RAID level 4 - esempio § 5 dischi fisici, uno usato per i dati ridondanti § scrittura dei blocchi dati e di parità § alta velocità (aggregata) di trasferimento in lettura - ridotta velocità di scrittura per la necessità di scrivere il blocco di parità Disco 1 Disco 2 Disco 3 Disco 4 Disco 5 ridondante Stripe 1 Block 2 Block 3 Block 4 Parity 1 -4 Stripe 2 Block 5 Block 6 Block 7 Block 8 Parity 5 -8 Stripe 3 Block 9 Block 10 Block 11 Block 12 Parity 9 -12 Ingegneria Dalmine “Impianti Informatici” RAID - 26
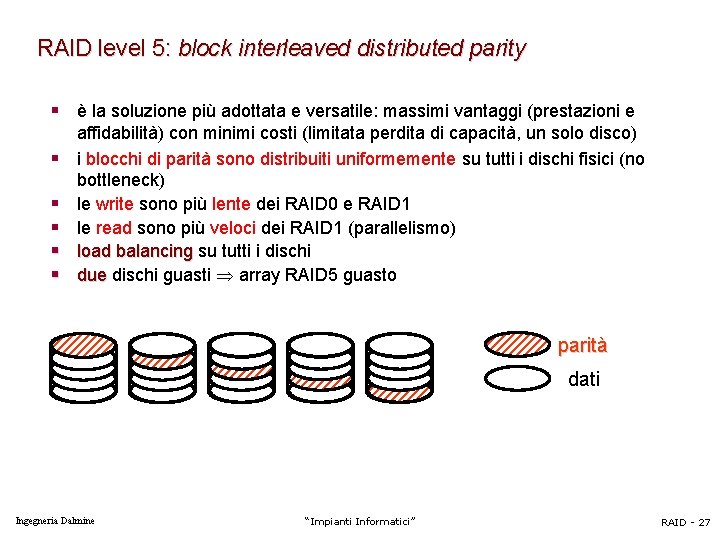
RAID level 5: block interleaved distributed parity § è la soluzione più adottata e versatile: massimi vantaggi (prestazioni e § § § affidabilità) con minimi costi (limitata perdita di capacità, un solo disco) i blocchi di parità sono distribuiti uniformemente su tutti i dischi fisici (no bottleneck) le write sono più lente dei RAID 0 e RAID 1 le read sono più veloci dei RAID 1 (parallelismo) load balancing su tutti i dischi due dischi guasti array RAID 5 guasto parità dati Ingegneria Dalmine “Impianti Informatici” RAID - 27
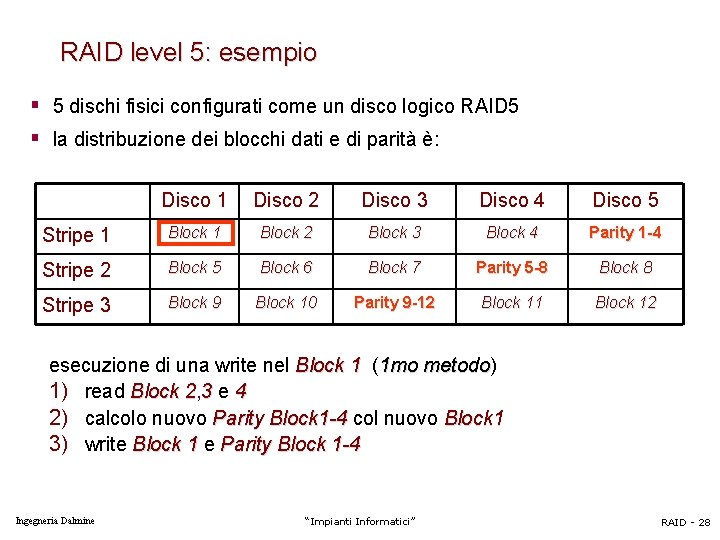
RAID level 5: esempio § 5 dischi fisici configurati come un disco logico RAID 5 § la distribuzione dei blocchi dati e di parità è: Disco 1 Disco 2 Disco 3 Disco 4 Disco 5 Stripe 1 Block 2 Block 3 Block 4 Parity 1 -4 Stripe 2 Block 5 Block 6 Block 7 Parity 5 -8 Block 8 Stripe 3 Block 9 Block 10 Parity 9 -12 Block 11 Block 12 esecuzione di una write nel Block 1 (1 mo metodo) metodo 1) read Block 2, 23 e 4 2) calcolo nuovo Parity Block 1 -4 col nuovo Block 1 3) write Block 1 e Parity Block 1 -4 Ingegneria Dalmine “Impianti Informatici” RAID - 28
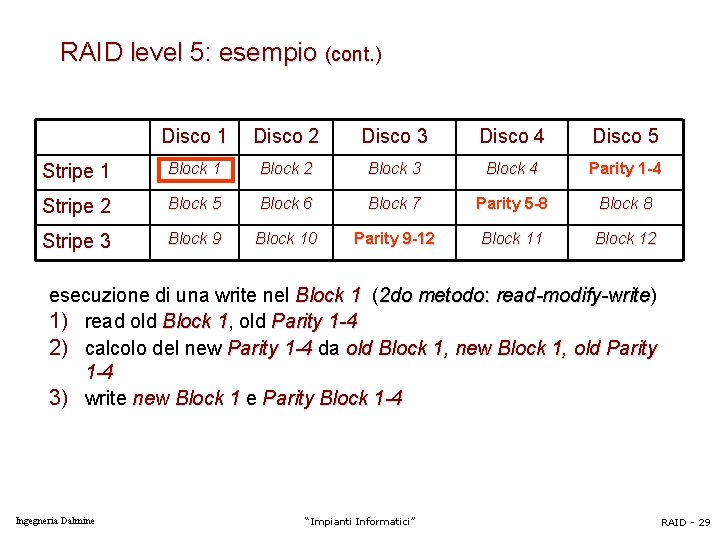
RAID level 5: esempio (cont. ) Disco 1 Disco 2 Disco 3 Disco 4 Disco 5 Stripe 1 Block 2 Block 3 Block 4 Parity 1 -4 Stripe 2 Block 5 Block 6 Block 7 Parity 5 -8 Block 8 Stripe 3 Block 9 Block 10 Parity 9 -12 Block 11 Block 12 esecuzione di una write nel Block 1 (2 do metodo: read-modify-write) read-modify-write 1) read old Block 1, 1 old Parity 1 -4 2) calcolo del new Parity 1 -4 da old Block 1, new Block 1, old Parity 1 -4 3) write new Block 1 e Parity Block 1 -4 Ingegneria Dalmine “Impianti Informatici” RAID - 29
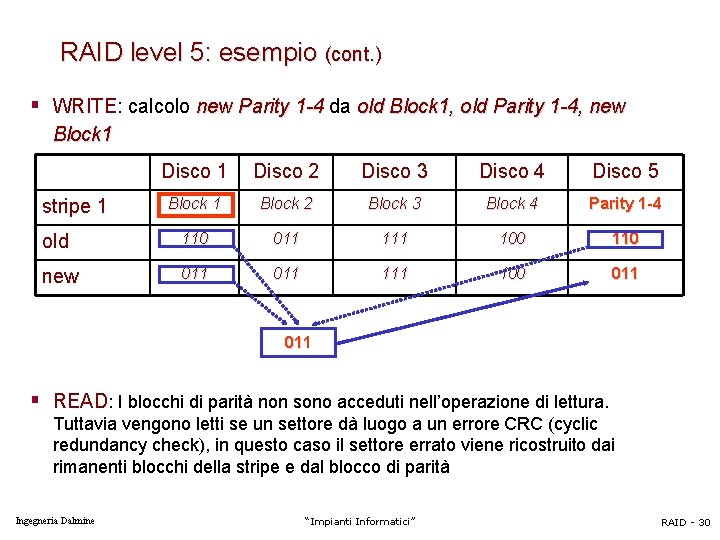
RAID level 5: esempio (cont. ) § WRITE: calcolo new Parity 1 -4 da old Block 1, old Parity 1 -4, new Block 1 Disco 2 Disco 3 Disco 4 Disco 5 Block 1 Block 2 Block 3 Block 4 Parity 1 -4 old 110 011 100 110 new 011 111 100 011 stripe 1 011 § READ: I blocchi di parità non sono acceduti nell’operazione di lettura. Tuttavia vengono letti se un settore dà luogo a un errore CRC (cyclic redundancy check), in questo caso il settore errato viene ricostruito dai rimanenti blocchi della stripe e dal blocco di parità Ingegneria Dalmine “Impianti Informatici” RAID - 30
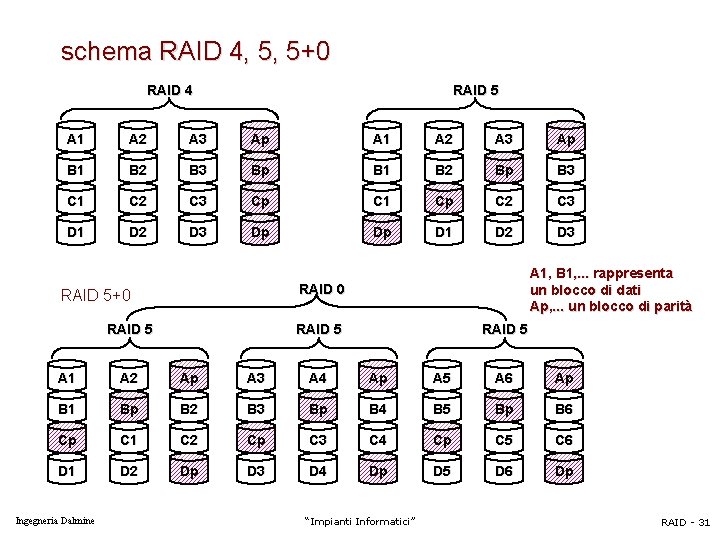
schema RAID 4, 5, 5+0 RAID 4 RAID 5 A 1 A 2 A 3 Ap B 1 B 2 B 3 Bp B 1 B 2 Bp B 3 C 1 C 2 C 3 Cp C 1 Cp C 2 C 3 D 1 D 2 D 3 Dp Dp D 1 D 2 D 3 A 1, B 1, . . . rappresenta un blocco di dati Ap, . . . un blocco di parità RAID 0 RAID 5+0 RAID 5 A 1 A 2 Ap A 3 A 4 Ap A 5 A 6 Ap B 1 Bp B 2 B 3 Bp B 4 B 5 Bp B 6 Cp C 1 C 2 Cp C 3 C 4 Cp C 5 C 6 D 1 D 2 Dp D 3 D 4 Dp D 5 D 6 Dp Ingegneria Dalmine “Impianti Informatici” RAID - 31
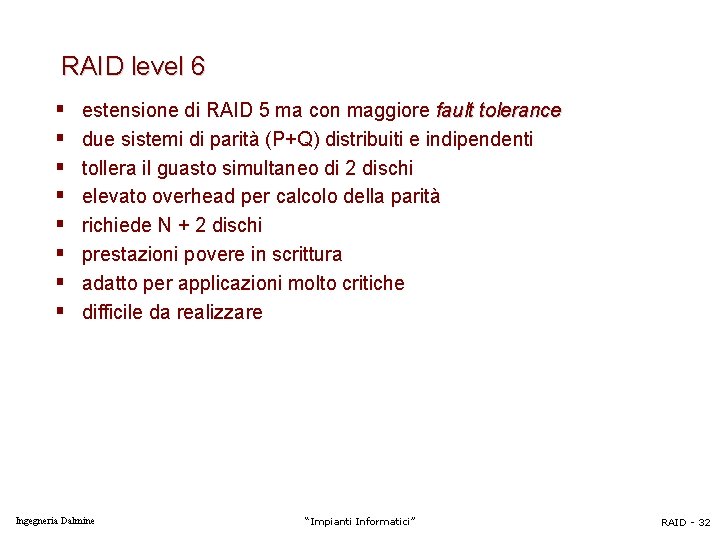
RAID level 6 § § § § estensione di RAID 5 ma con maggiore fault tolerance due sistemi di parità (P+Q) distribuiti e indipendenti tollera il guasto simultaneo di 2 dischi elevato overhead per calcolo della parità richiede N + 2 dischi prestazioni povere in scrittura adatto per applicazioni molto critiche difficile da realizzare Ingegneria Dalmine “Impianti Informatici” RAID - 32
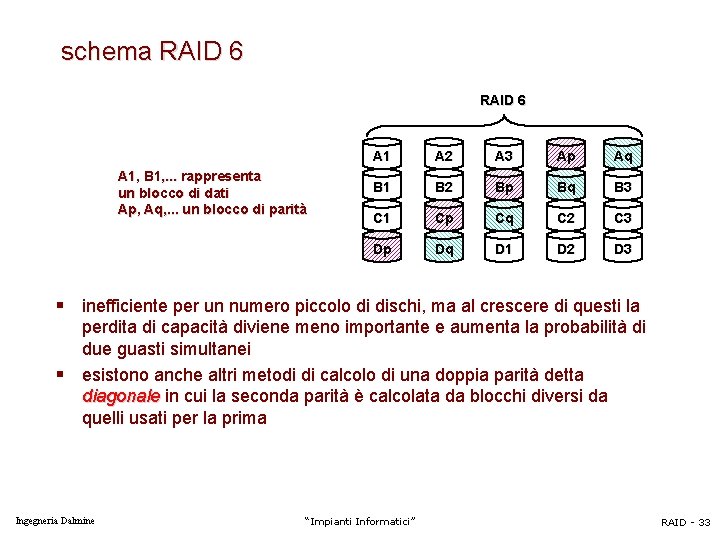
schema RAID 6 A 1, B 1, . . . rappresenta un blocco di dati Ap, Aq, . . . un blocco di parità A 1 A 2 A 3 Ap Aq B 1 B 2 Bp Bq B 3 C 1 Cp Cq C 2 C 3 Dp Dq D 1 D 2 D 3 § inefficiente per un numero piccolo di dischi, ma al crescere di questi la perdita di capacità diviene meno importante e aumenta la probabilità di due guasti simultanei § esistono anche altri metodi di calcolo di una doppia parità detta diagonale in cui la seconda parità è calcolata da blocchi diversi da quelli usati per la prima Ingegneria Dalmine “Impianti Informatici” RAID - 33
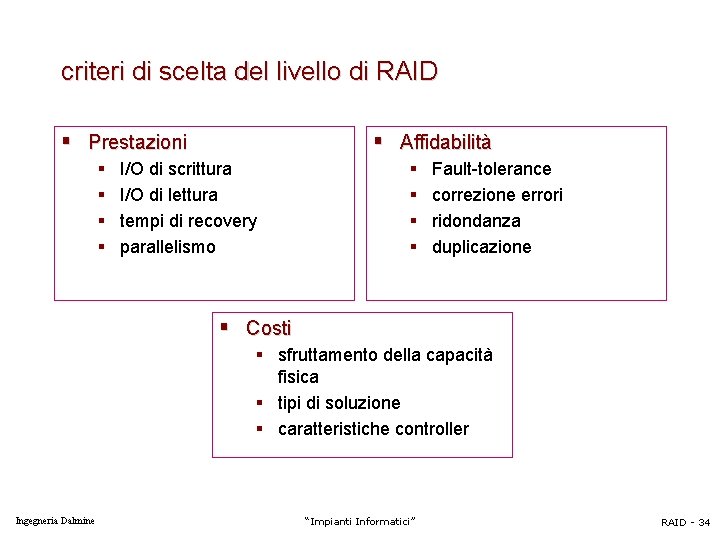
criteri di scelta del livello di RAID § Prestazioni § § § Affidabilità I/O di scrittura I/O di lettura tempi di recovery parallelismo § § Fault-tolerance correzione errori ridondanza duplicazione § Costi § sfruttamento della capacità fisica § tipi di soluzione § caratteristiche controller Ingegneria Dalmine “Impianti Informatici” RAID - 34
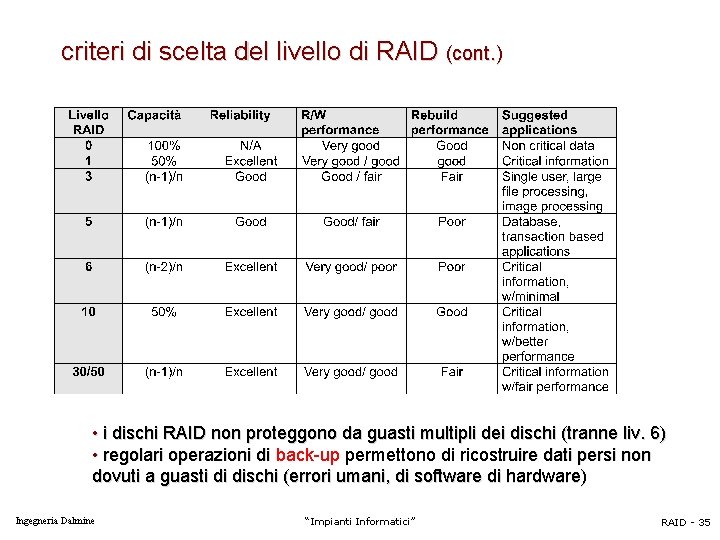
criteri di scelta del livello di RAID (cont. ) • i dischi RAID non proteggono da guasti multipli dei dischi (tranne liv. 6) • regolari operazioni di back-up permettono di ricostruire dati persi non dovuti a guasti di dischi (errori umani, di software di hardware) Ingegneria Dalmine “Impianti Informatici” RAID - 35
prestazioni RAID Ingegneria Dalmine “Impianti Informatici” RAID - 36
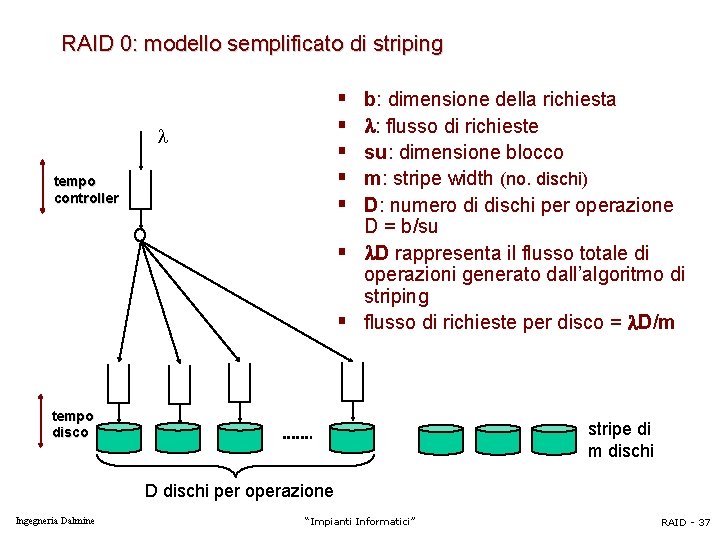
RAID 0: modello semplificato di striping § § § b: dimensione della richiesta : flusso di richieste su: dimensione blocco m: stripe width (no. dischi) D: numero di dischi per operazione D = b/su § D rappresenta il flusso totale di operazioni generato dall’algoritmo di striping § flusso di richieste per disco = D/m tempo controller tempo disco stripe di m dischi D dischi per operazione Ingegneria Dalmine “Impianti Informatici” RAID - 37
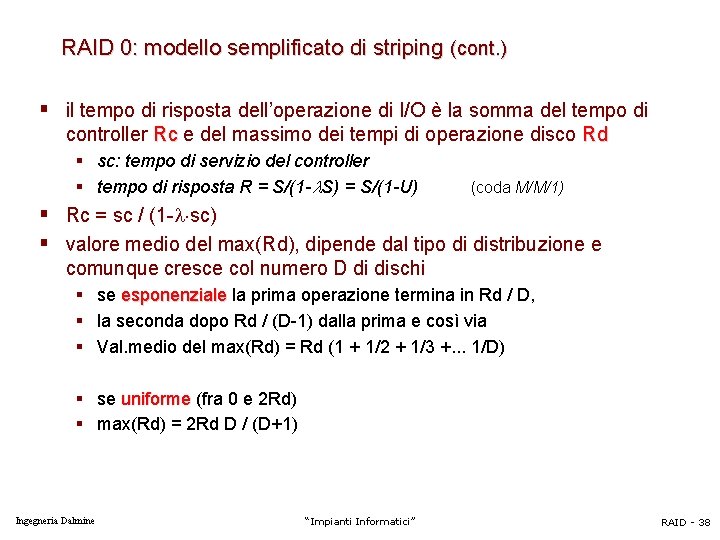
RAID 0: modello semplificato di striping (cont. ) § il tempo di risposta dell’operazione di I/O è la somma del tempo di controller Rc e del massimo dei tempi di operazione disco Rd § sc: tempo di servizio del controller § tempo di risposta R = S/(1 - S) = S/(1 -U) (coda M/M/1) § Rc = sc / (1 - sc) § valore medio del max(Rd), dipende dal tipo di distribuzione e comunque cresce col numero D di dischi § se esponenziale la prima operazione termina in Rd / D, § la seconda dopo Rd / (D-1) dalla prima e così via § Val. medio del max(Rd) = Rd (1 + 1/2 + 1/3 +. . . 1/D) § se uniforme (fra 0 e 2 Rd) § max(Rd) = 2 Rd D / (D+1) Ingegneria Dalmine “Impianti Informatici” RAID - 38
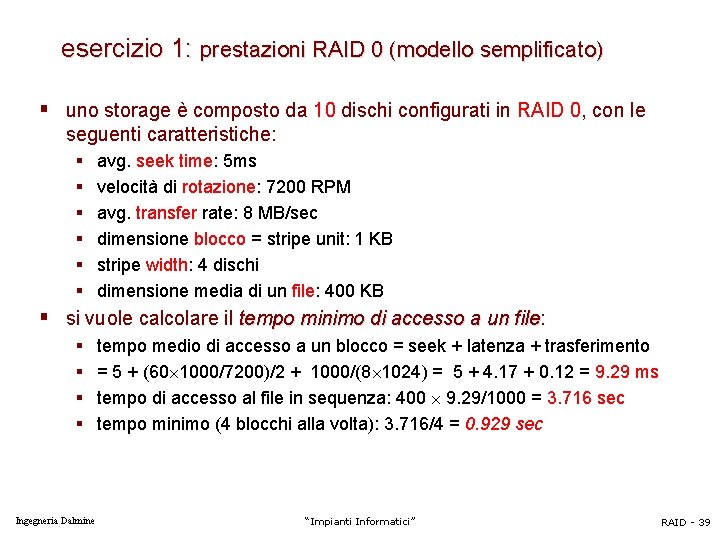
esercizio 1: prestazioni RAID 0 (modello semplificato) § uno storage è composto da 10 dischi configurati in RAID 0, con le seguenti caratteristiche: § § § avg. seek time: 5 ms velocità di rotazione: 7200 RPM avg. transfer rate: 8 MB/sec dimensione blocco = stripe unit: 1 KB stripe width: 4 dischi dimensione media di un file: 400 KB § si vuole calcolare il tempo minimo di accesso a un file: file § § Ingegneria Dalmine tempo medio di accesso a un blocco = seek + latenza + trasferimento = 5 + (60 1000/7200)/2 + 1000/(8 1024) = 5 + 4. 17 + 0. 12 = 9. 29 ms tempo di accesso al file in sequenza: 400 9. 29/1000 = 3. 716 sec tempo minimo (4 blocchi alla volta): 3. 716/4 = 0. 929 sec “Impianti Informatici” RAID - 39
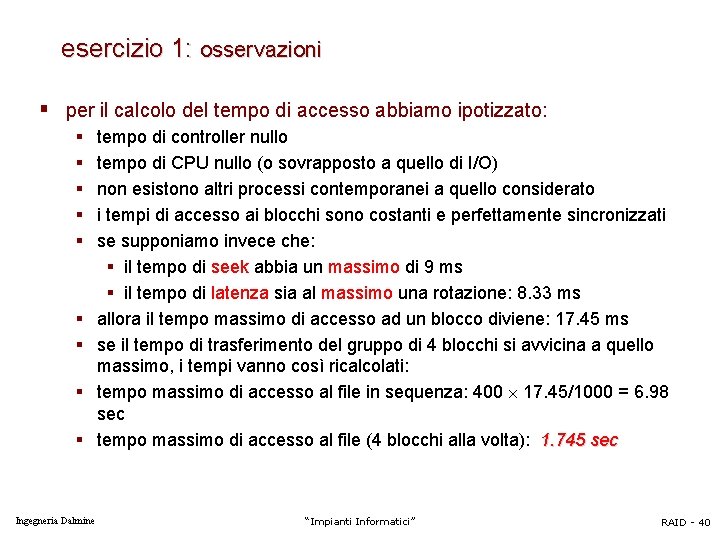
esercizio 1: osservazioni § per il calcolo del tempo di accesso abbiamo ipotizzato: § § § § § Ingegneria Dalmine tempo di controller nullo tempo di CPU nullo (o sovrapposto a quello di I/O) non esistono altri processi contemporanei a quello considerato i tempi di accesso ai blocchi sono costanti e perfettamente sincronizzati se supponiamo invece che: § il tempo di seek abbia un massimo di 9 ms § il tempo di latenza sia al massimo una rotazione: 8. 33 ms allora il tempo massimo di accesso ad un blocco diviene: 17. 45 ms se il tempo di trasferimento del gruppo di 4 blocchi si avvicina a quello massimo, i tempi vanno così ricalcolati: tempo massimo di accesso al file in sequenza: 400 17. 45/1000 = 6. 98 sec tempo massimo di accesso al file (4 blocchi alla volta): 1. 745 sec “Impianti Informatici” RAID - 40
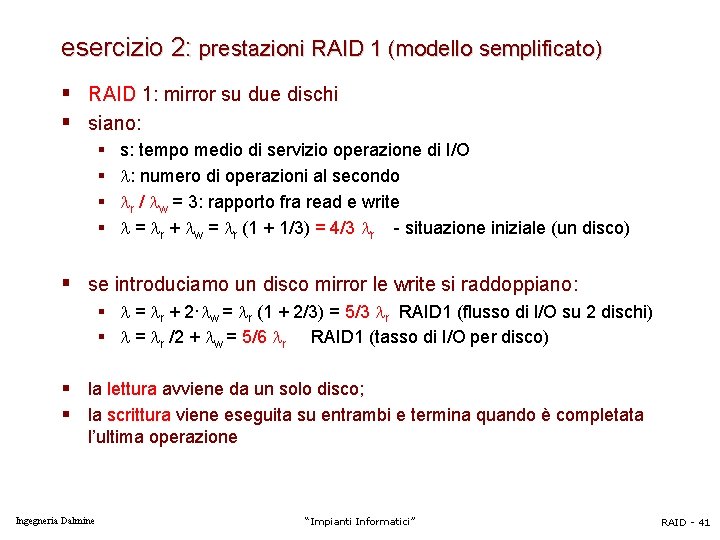
esercizio 2: prestazioni RAID 1 (modello semplificato) § RAID 1: mirror su due dischi § siano: § § s: tempo medio di servizio operazione di I/O : numero di operazioni al secondo r / w = 3: rapporto fra read e write = r + w = r (1 + 1/3) = 4/3 r - situazione iniziale (un disco) § se introduciamo un disco mirror le write si raddoppiano: § = r + 2· w = r (1 + 2/3) = 5/3 r RAID 1 (flusso di I/O su 2 dischi) § = r /2 + w = 5/6 r RAID 1 (tasso di I/O per disco) § la lettura avviene da un solo disco; § la scrittura viene eseguita su entrambi e termina quando è completata l’ultima operazione Ingegneria Dalmine “Impianti Informatici” RAID - 41
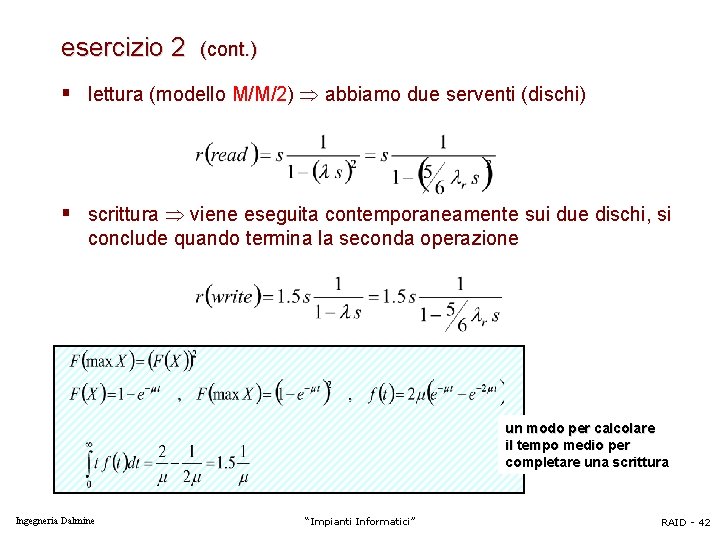
esercizio 2 (cont. ) § lettura (modello M/M/2) abbiamo due serventi (dischi) § scrittura viene eseguita contemporaneamente sui due dischi, si conclude quando termina la seconda operazione un modo per calcolare il tempo medio per completare una scrittura Ingegneria Dalmine “Impianti Informatici” RAID - 42
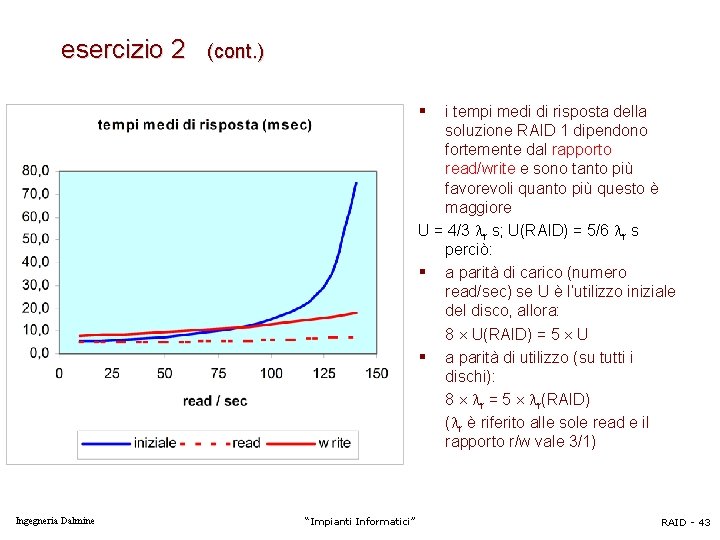
esercizio 2 (cont. ) § i tempi medi di risposta della soluzione RAID 1 dipendono fortemente dal rapporto read/write e sono tanto più favorevoli quanto più questo è maggiore U = 4/3 r s; U(RAID) = 5/6 r s perciò: § a parità di carico (numero read/sec) se U è l’utilizzo iniziale del disco, allora: 8 U(RAID) = 5 U § a parità di utilizzo (su tutti i dischi): 8 r = 5 r(RAID) ( r è riferito alle sole read e il rapporto r/w vale 3/1) Ingegneria Dalmine “Impianti Informatici” RAID - 43
affidabilità RAID Ingegneria Dalmine “Impianti Informatici” RAID - 44
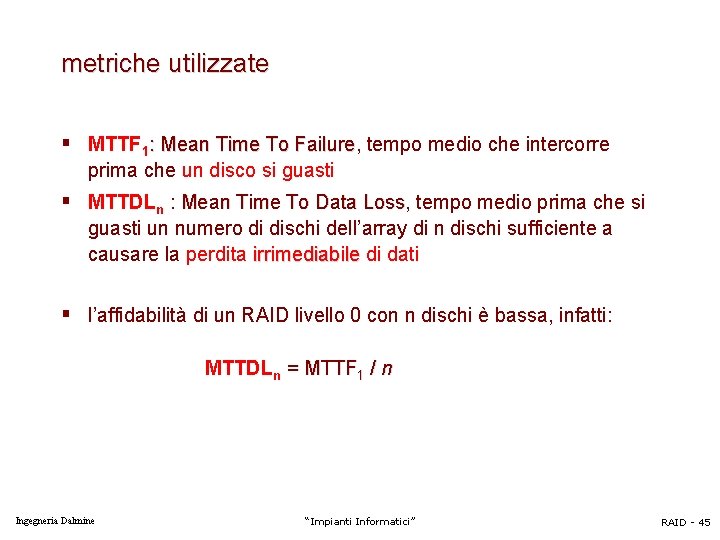
metriche utilizzate § MTTF 1: Mean Time To Failure, Failure tempo medio che intercorre prima che un disco si guasti § MTTDLn : Mean Time To Data Loss, Loss tempo medio prima che si guasti un numero di dischi dell’array di n dischi sufficiente a causare la perdita irrimediabile di dati § l’affidabilità di un RAID livello 0 con n dischi è bassa, infatti: MTTDLn = MTTF 1 / n Ingegneria Dalmine “Impianti Informatici” RAID - 45
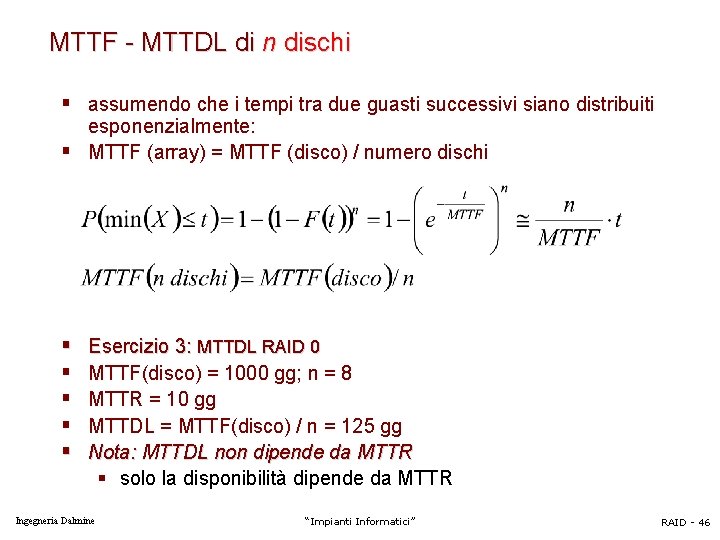
MTTF - MTTDL di n dischi § assumendo che i tempi tra due guasti successivi siano distribuiti esponenzialmente: § MTTF (array) = MTTF (disco) / numero dischi § § § Esercizio 3: MTTDL RAID 0 MTTF(disco) = 1000 gg; n = 8 MTTR = 10 gg MTTDL = MTTF(disco) / n = 125 gg Nota: MTTDL non dipende da MTTR § solo la disponibilità dipende da MTTR Ingegneria Dalmine “Impianti Informatici” RAID - 46
MTTF - MTTDL di n dischi (cont. ) § P(array RAID 1 guasto) = 1/MTTDL § = P(1° guasto) P(2° guasto < MTTR) § § § § Esercizio 4: MTTDL RAID 1 MTTF(disco) = 1. 000 gg; numero totale di dischi = 16 (= 2 8) MTTR = 10 gg P(1° guasto) = n / MTTF(disco) = 16 / 1000 P(2° guasto: si guasta il disco mirror del 1°) = MTTR / MTTF MTTDL = 1/(16/1000 10/1000) = 6250 gg Nota: si considera MTTDL il tempo medio alla perdita di un dato su un qualunque disco dell’array (anche se gli altri sono raggiungibili) lo stesso calcolo vale anche per RAID 1 + 0 Ingegneria Dalmine “Impianti Informatici” RAID - 47
MTTF - MTTDL di n dischi (cont. ) § P(array RAID 1 guasto) = 1/MTTDL § = P(1° guasto) P(2° guasto < MTTR) § § § Esercizio 5: MTTDL RAID 0 + 1 MTTF(disco) = 1000 gg; numero totale di dischi = 16 (= 2 8) MTTR = 10 gg P(1° guasto) = n / MTTF(disco) = 16 / 1000 P(2° guasto: si guasta un disco nell’altro gruppo mirror) = MTTR / (MTTF 2/n) § MTTDL = 1/(16/1000 10 8/1000) = 781 gg Ingegneria Dalmine “Impianti Informatici” RAID - 48
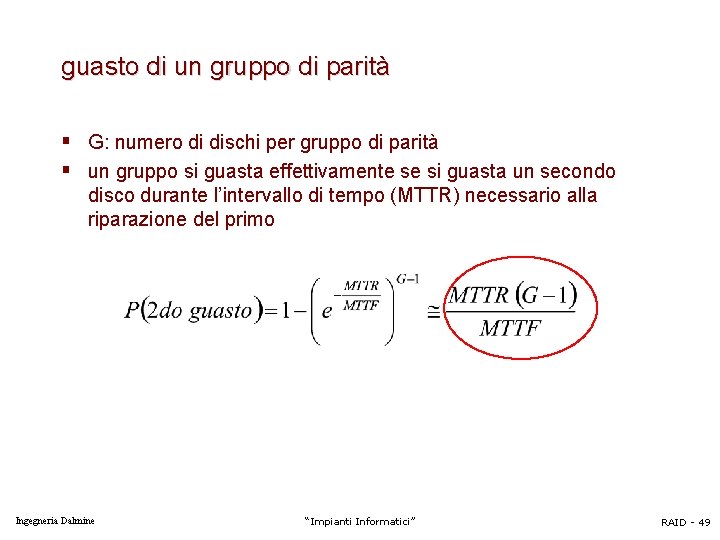
guasto di un gruppo di parità § G: numero di dischi per gruppo di parità § un gruppo si guasta effettivamente se si guasta un secondo disco durante l’intervallo di tempo (MTTR) necessario alla riparazione del primo Ingegneria Dalmine “Impianti Informatici” RAID - 49
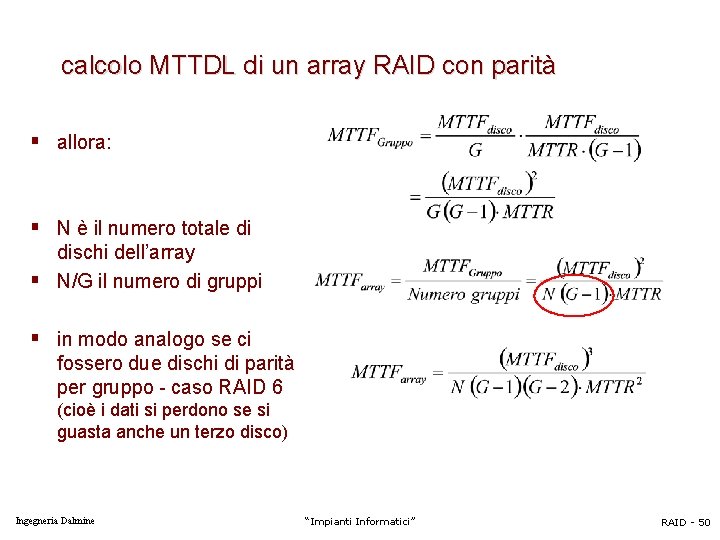
calcolo MTTDL di un array RAID con parità § allora: § N è il numero totale di dischi dell’array § N/G il numero di gruppi § in modo analogo se ci fossero due dischi di parità per gruppo - caso RAID 6 (cioè i dati si perdono se si guasta anche un terzo disco) Ingegneria Dalmine “Impianti Informatici” RAID - 50
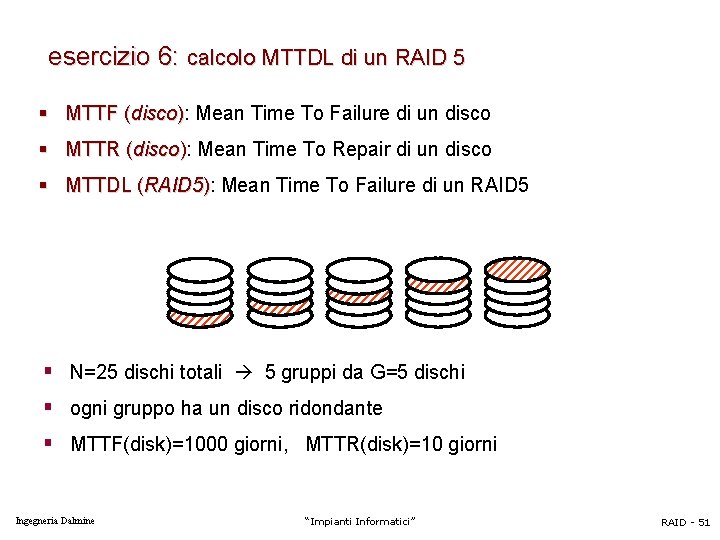
esercizio 6: calcolo MTTDL di un RAID 5 § MTTF (disco): Mean Time To Failure di un disco § MTTR (disco): Mean Time To Repair di un disco § MTTDL (RAID 5): Mean Time To Failure di un RAID 5 § N=25 dischi totali 5 gruppi da G=5 dischi § ogni gruppo ha un disco ridondante § MTTF(disk)=1000 giorni, MTTR(disk)=10 giorni Ingegneria Dalmine “Impianti Informatici” RAID - 51
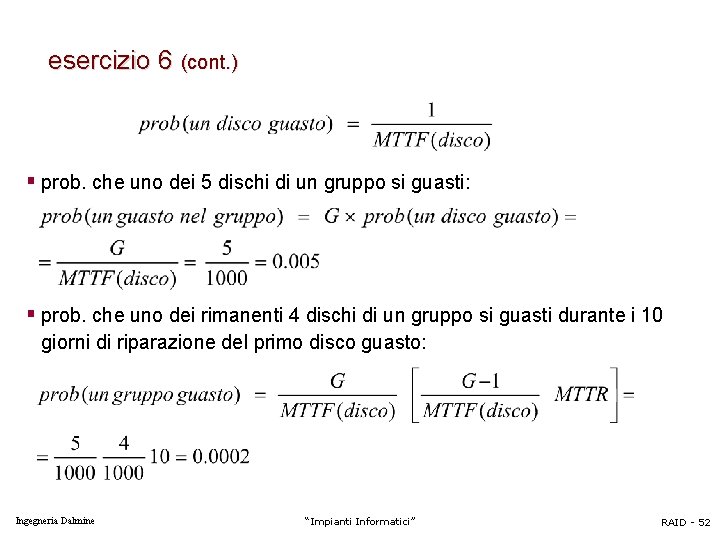
esercizio 6 (cont. ) § prob. che uno dei 5 dischi di un gruppo si guasti: § prob. che uno dei rimanenti 4 dischi di un gruppo si guasti durante i 10 giorni di riparazione del primo disco guasto: Ingegneria Dalmine “Impianti Informatici” RAID - 52
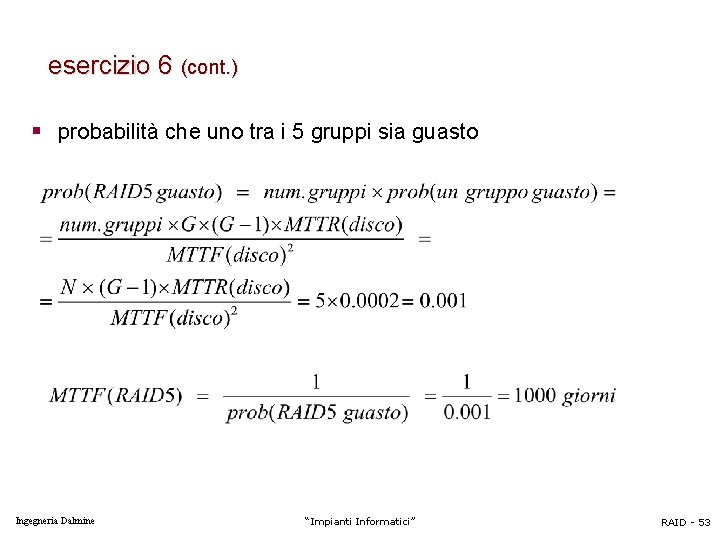
esercizio 6 (cont. ) § probabilità che uno tra i 5 gruppi sia guasto Ingegneria Dalmine “Impianti Informatici” RAID - 53
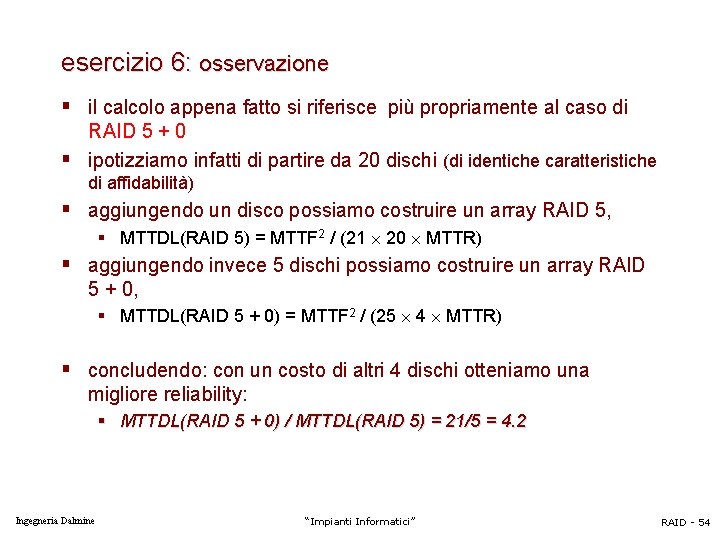
esercizio 6: osservazione § il calcolo appena fatto si riferisce più propriamente al caso di RAID 5 + 0 § ipotizziamo infatti di partire da 20 dischi (di identiche caratteristiche di affidabilità) § aggiungendo un disco possiamo costruire un array RAID 5, § MTTDL(RAID 5) = MTTF 2 / (21 20 MTTR) § aggiungendo invece 5 dischi possiamo costruire un array RAID 5 + 0, § MTTDL(RAID 5 + 0) = MTTF 2 / (25 4 MTTR) § concludendo: con un costo di altri 4 dischi otteniamo una migliore reliability: § MTTDL(RAID 5 + 0) / MTTDL(RAID 5) = 21/5 = 4. 2 Ingegneria Dalmine “Impianti Informatici” RAID - 54
- Slides: 54