
Datastrukturer och algoritmer Frelsning 14 Anders Broberg Ulrika
Datastrukturer och algoritmer Föreläsning 14 © Anders Broberg, Ulrika Hägglund, Lena Kallin Westin, 2003
Innehåll u u u Prioritetskö Ø Heap/Hög Mer om sortering Ø Heapsort O(N*log(N)) Ø Facksortering/Bucketsort O(N+M) Ø Radixsort O(b*N) Sökning i strängar/mönstermatching Ø Naiv sökning (Brute force) Ø Knuth Morris Pratt Ø Booyer moore’s Datastrukturer och algoritmer VT 2005 2 © Anders Broberg, Ulrika Hägglund, Lena Kallin Westin, 2003

Prioritetskö u Modell: Patienterna på en akutmottagning, man kommer in i en viss tidsordning men behandlas utifrån en annan ordning. u Organisation: En mängd vars grundmängd är linjärt ordnad av en prioritetsordning. ØAvläsningar och borttagningar görs endast på de element som har högst prioritet. ØAndra mängdoperationer är inte Datastrukturer och algoritmer aktuella VT 2005 3 © Anders Broberg, Ulrika Hägglund, Lena Kallin Westin, 2003
Specifikation av prioritetskö u Gränsytan Pqueue(val, R): Empty Insert Isempty Inspect-first Delete-first u u u () Pqueue(val, R) (v: val, p: Pqueue(val, R)) Pqueue(val, R) (p: Pqueue(val, R)) Bool (p: Pqueue(val, R)) val (p: Pqueue(val, R)) Pqueue(val, R) R är relationen för prioritetsordningen. Ibland slås de två sista metoderna ihop. Ytan ovan förutsätter statisk prioritet. Vill man ha dynamisk prioritet måste en updatemetod finnas. Datastrukturer och algoritmer VT 2005 4 © Anders Broberg, Ulrika Hägglund, Lena Kallin Westin, 2003
Specifikation av prioritetskö u Man kan också tänka sig att prioritetskön tar element (val) som består av ett värde och en prioritet. ØFörra fallet antog man att värde = prioritet u Gränsytan kan varieras på flera sätt Øupdate har vi redan nämnt ØVi kan också vilja finna det högsta/minsta prioritetsvärdet i kön Datastrukturer och algoritmer VT 2005 5 © Anders Broberg, Ulrika Hägglund, Lena Kallin Westin, 2003
Stack och kö är specialfall av prioritetskön! en om 4! i ax 29 Se å s p u Om R är den totala relationen, dvs gäller för alla par av värden blir prioritetskön en stack. u Om R är den tomma relationen, dvs inte gäller för några par av värden, blir det en kö. u Dessutom: ØOm R är en strikt partiell ordning, som ”>”, kommer lika element behandlas som en kö. ØOm R är icke-strikt, som ”≥” behandlas lika element som en stack. Datastrukturer och algoritmer VT 2005 6 © Anders Broberg, Ulrika Hägglund, Lena Kallin Westin, 2003
Konstruktioner av Prioritetskö u Man utgår ofta från konstruktioner av Mängd eller Lexikon u Lista, ej sorterad ØInsert O(1), Delete-first O(n) u Lista, sorterad ØInsert O(n), Delete-first O(1) Datastrukturer och algoritmer VT 2005 7 © Anders Broberg, Ulrika Hägglund, Lena Kallin Westin, 2003
Konstruktioner av Prioritetskö u Heap/Hög – ett partiellt sorterat binärt träd ØEtiketterna är sorterade efter en relation R så att a är förälder till b endast om a är före b i ordningen som ges av R. ØInsättningar och borttagningar görs så att trädet hålls komplett. Datastrukturer och algoritmer VT 2005 8 © Anders Broberg, Ulrika Hägglund, Lena Kallin Westin, 2003
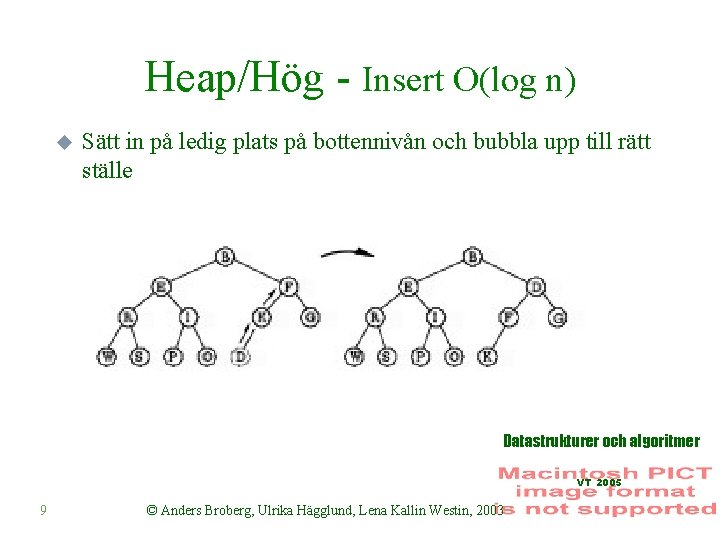
Heap/Hög - Insert O(log n) u Sätt in på ledig plats på bottennivån och bubbla upp till rätt ställe Datastrukturer och algoritmer VT 2005 9 © Anders Broberg, Ulrika Hägglund, Lena Kallin Westin, 2003
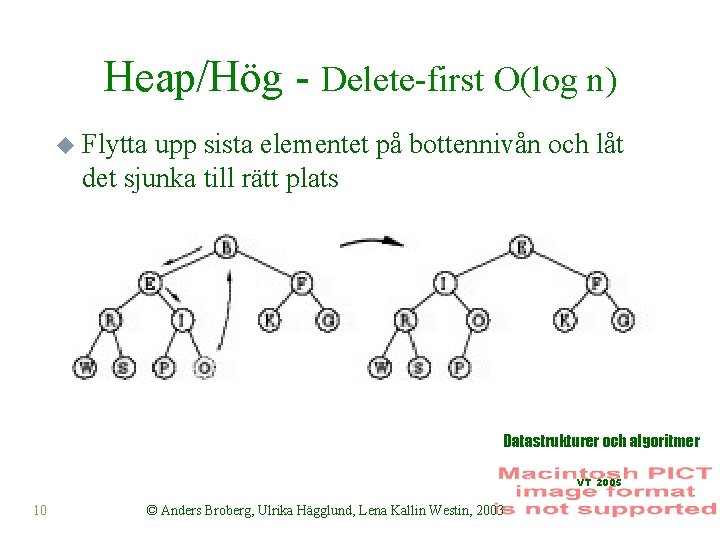
Heap/Hög - Delete-first O(log n) u Flytta upp sista elementet på bottennivån och låt det sjunka till rätt plats Datastrukturer och algoritmer VT 2005 10 © Anders Broberg, Ulrika Hägglund, Lena Kallin Westin, 2003
Tillämpningar u Operativsystem som fördelar jobb mellan olika processer u Enkelt sätt att sortera något. ØStoppa in allt i en prioritetskö och plocka ut det igen. u Hjälpmedel vid traversering av graf ØJmfr att stack och kö används vid traversering av träd. Datastrukturer och algoritmer VT 2005 11 © Anders Broberg, Ulrika Hägglund, Lena Kallin Westin, 2003
Det går att sortera snabbare än O(nlog(n)) u För att göra det måste vi veta mer om objekten vi vill sortera ØGå att avbilda på heltalen ØStörsta värdet & minsta värdet o [Vmin…Vmax] ØO(N+M) där N är antalet element och M är Vmax-Vmin Datastrukturer och algoritmer VT 2005 12 © Anders Broberg, Ulrika Hägglund, Lena Kallin Westin, 2003
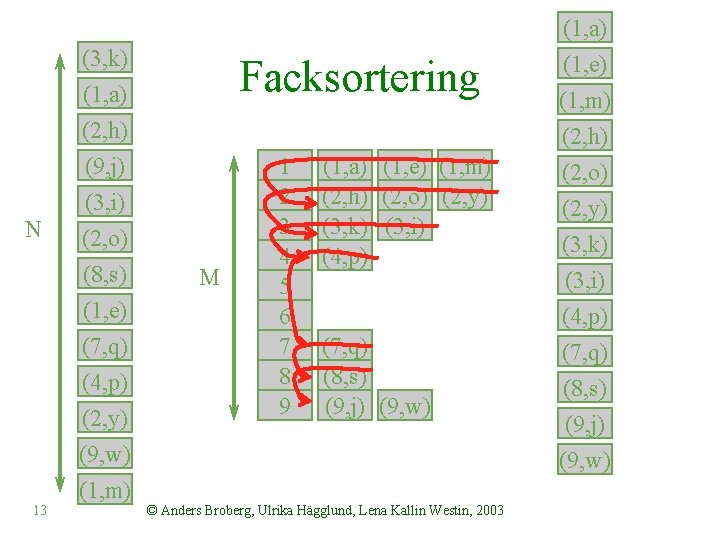
(1, a) (3, k) (1, a) (2, h) N 13 Facksortering (9, j) (3, i) (2, o) (8, s) (1, e) (7, q) (4, p) (2, y) (9, w) (1, m) M 1 2 3 4 5 6 7 8 9 (1, a) (1, e) (1, m) (2, h) (2, o) (2, y) (3, k) (3, i) (4, p) (7, q) (8, s) (9, j) (9, w) © Anders Broberg, Ulrika Hägglund, Lena Kallin Westin, 2003
Radix Sort u Radix ≈ bas ØTittar på strukturen hos nycklarna u Antag att talen är representerade i basen M, tex. ØM=2 binära talsystemet 9 = 1 0 0 1 ØM=10 decimala talsystemet ØSorterar genom att jämföra siffror/bitar i Datastrukturer och algoritmer samma position VT 2005 14 © Anders Broberg, Ulrika Hägglund, Lena Kallin Westin, 2003
”Straight” Radix Sort O(b. N) for i 0 to b-1 do sortera fältet på ett stabilt sätt, med avseende på i: e biten u Jämföra från höger till vänster… u Antag att vi kan sortera fältet stabilt på O(N) => O(b. N) u Hur gör vi det? Datastrukturer och algoritmer ØFacksortering…. VT 2005 15 © Anders Broberg, Ulrika Hägglund, Lena Kallin Westin, 2003
”Straight” Radix Sort 0 10 01 01 01 10 10 01 10 10 01 01 Datastrukturer och algoritmer VT 2005 16 © Anders Broberg, Ulrika Hägglund, Lena Kallin Westin, 2003
”Straight” Radix Sort u Funkar den? ØPå grund av stabilitet, så förändras inte den relativa ordningen mellan två nycklar med samma värde Datastrukturer och algoritmer VT 2005 17 © Anders Broberg, Ulrika Hägglund, Lena Kallin Westin, 2003
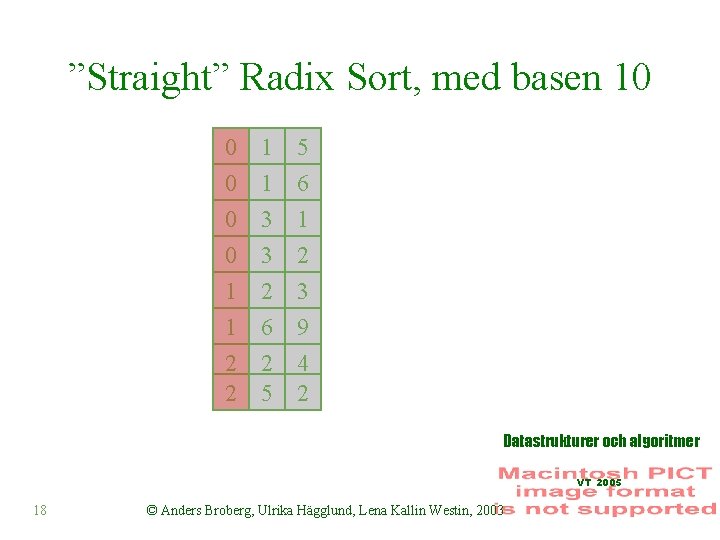
”Straight” Radix Sort, med basen 10 0 02 210 120 201 01 021 12 13 213 1325 132 32 631 251 56 251 462 6321 5432 143 925 3264 29 Datastrukturer och algoritmer VT 2005 18 © Anders Broberg, Ulrika Hägglund, Lena Kallin Westin, 2003
Radix Exchange sort u 1. 2. 3. Titta på bitarna från vänster till höger Sortera fältet på den vänstraste biten Dela fältet i två delar toppen & botten Rekursion § Sortera toppen rekursivt, ignorera vänstraste biten § Sortera botten rekursivt, ignorera vänstraste biten O(b. N) där b är antalet bitar och Datastrukturer och algoritmer N antalet tal VT 2005 19 © Anders Broberg, Ulrika Hägglund, Lena Kallin Westin, 2003
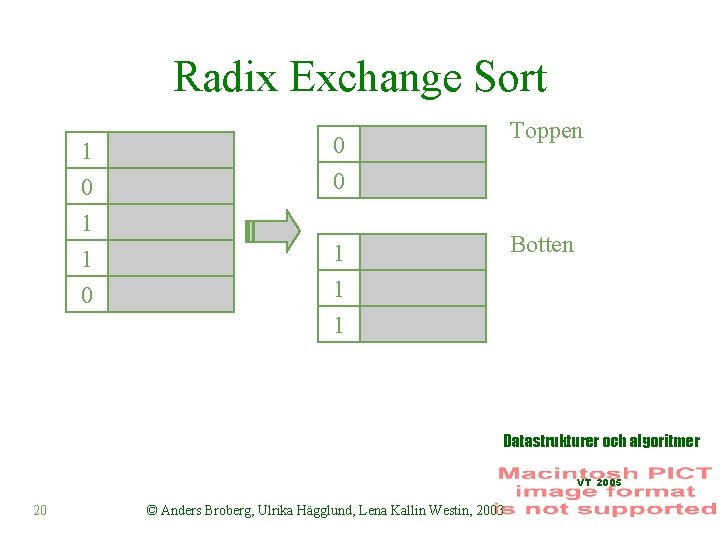
Radix Exchange Sort 1 0 1 1 0 0 0 1 1 Toppen Botten 1 Datastrukturer och algoritmer VT 2005 20 © Anders Broberg, Ulrika Hägglund, Lena Kallin Westin, 2003
Radix Exchange Sort u Bygger på samma idé som inplace quicksort, för att dela upp i två delar (toppen och botten) repeat scan top-down to find a key starting with 1; scan bottom-up to find a key starting with 0; exchange keys; until scan indices cross Datastrukturer och algoritmer VT 2005 21 © Anders Broberg, Ulrika Hägglund, Lena Kallin Westin, 2003
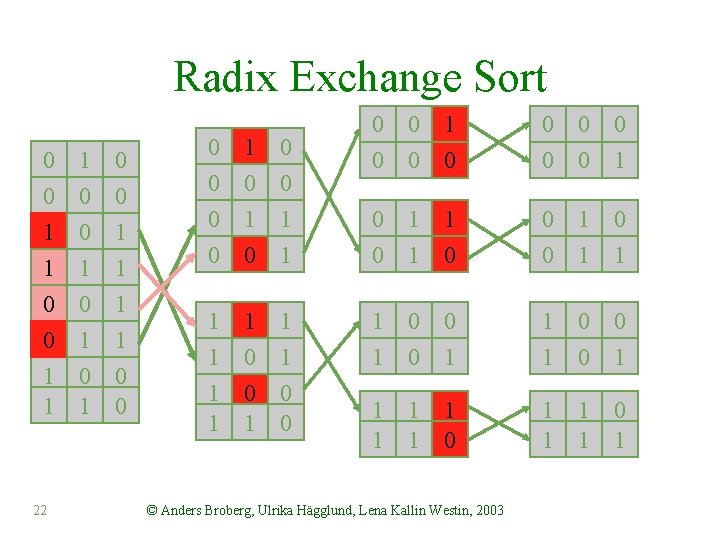
Radix Exchange Sort 0 0 1 1 22 1 0 0 1 0 1 0 0 1 1 0 0 0 1 1 1 1 0 0 0 0 0 0 1 1 1 0 0 0 1 1 0 1 0 0 1 1 1 1 0 1 1 1 © Anders Broberg, Ulrika Hägglund, Lena Kallin Westin, 2003 1 1
Strängsökning… u Att hitta en delsträng i en sträng u Ett antal algoritmer ØNaiv ØKnuth Morris Pratt ØBooyer Moore ØRabin-Karp Datastrukturer och algoritmer VT 2005 23 © Anders Broberg, Ulrika Hägglund, Lena Kallin Westin, 2003
Naiv Strängsökning u Brute force ØJämför ett tecken i taget tills två olika eller hittad delsträng ØVid två olika flytta fram ett tecken i huvudsträngen och börja om från början i mönstret u Kan hitta första delsträngen eller alla Datastrukturer och algoritmer VT 2005 24 © Anders Broberg, Ulrika Hägglund, Lena Kallin Westin, 2003
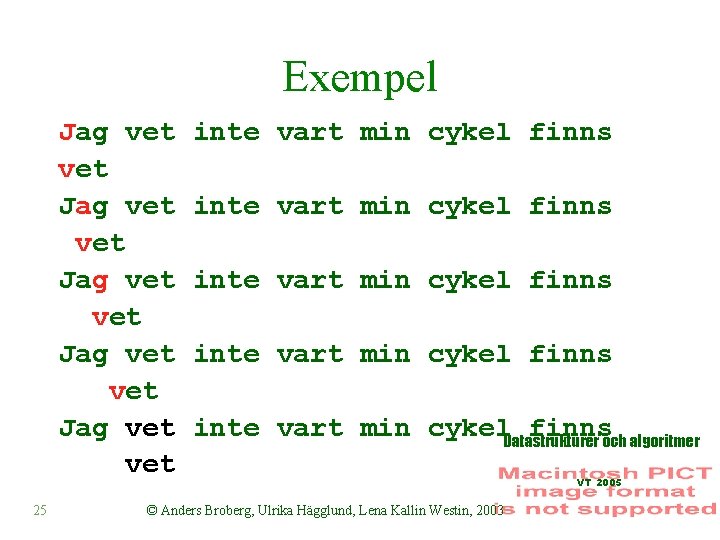
Exempel Jag vet vet Jag vet 25 inte vart min cykel finns inte vart min cykel. Datastrukturer finnsoch algoritmer © Anders Broberg, Ulrika Hägglund, Lena Kallin Westin, 2003 VT 2005
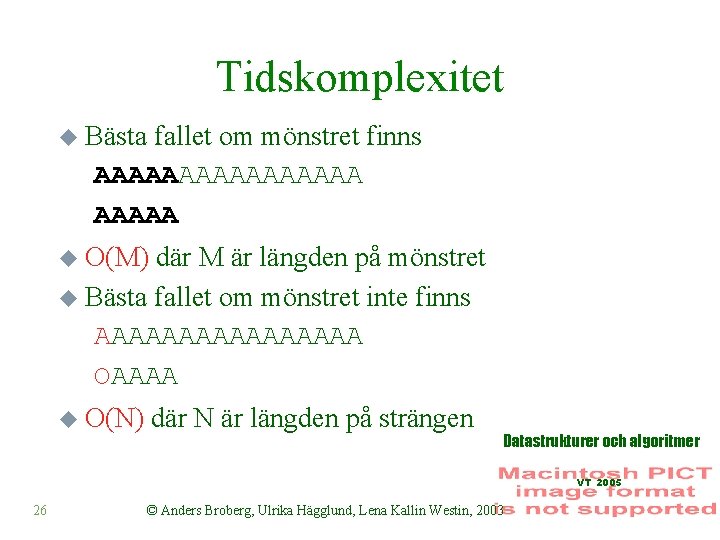
Tidskomplexitet u Bästa fallet om mönstret finns AAAAAAAA u O(M) där M är längden på mönstret u Bästa fallet om mönstret inte finns AAAAAAAA OAAAA u O(N) där N är längden på strängen Datastrukturer och algoritmer VT 2005 26 © Anders Broberg, Ulrika Hägglund, Lena Kallin Westin, 2003
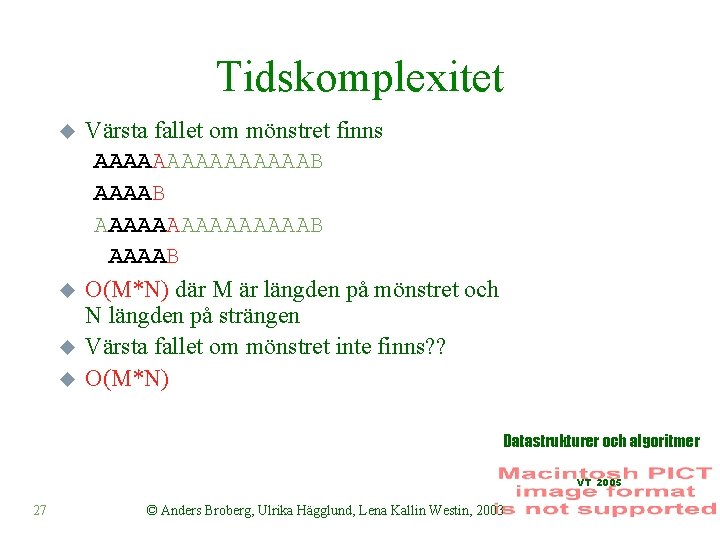
Tidskomplexitet u u Värsta fallet om mönstret finns AAAAAAAAAAAAAAAB O(M*N) där M är längden på mönstret och N längden på strängen Värsta fallet om mönstret inte finns? ? O(M*N) Datastrukturer och algoritmer VT 2005 27 © Anders Broberg, Ulrika Hägglund, Lena Kallin Westin, 2003
Vad kan vi göra bättre? u Utnyttja kunskap om sökmönstret för att: ØUnvika att behöva börja om från början ØHoppa längre steg Ø Ø Datastrukturer och algoritmer VT 2005 28 © Anders Broberg, Ulrika Hägglund, Lena Kallin Westin, 2003
Knuth Morris Pratt u Utnyttjar en felfunktion f Øsom berättar hur mycket av den senaste jämförelsen man kan återanvända om man felar Øär definierat som det längsta prefixet i P[0, . . . , j] som också är suffix av P[1, . . . , j] där P är vårt mönster. Øvisar hur mycket av början av strängen matchar upp till omedelbart före felet Datastrukturer och algoritmer VT 2005 29 © Anders Broberg, Ulrika Hägglund, Lena Kallin Westin, 2003
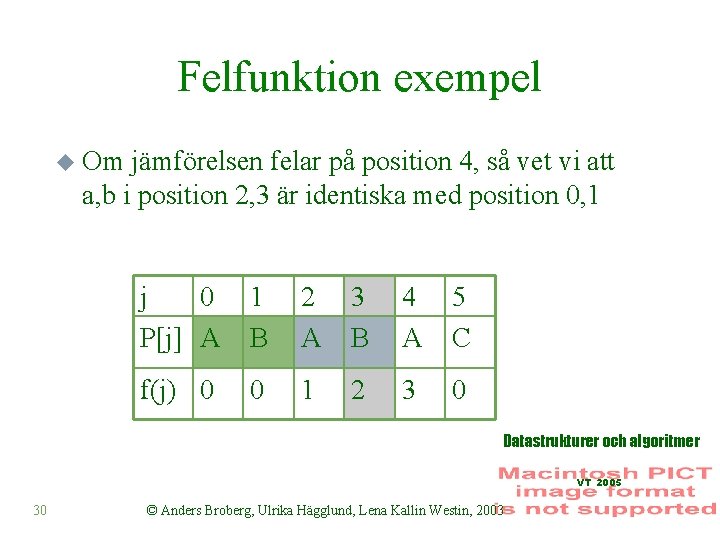
Felfunktion exempel u Om jämförelsen felar på position 4, så vet vi att a, b i position 2, 3 är identiska med position 0, 1 j 0 P[j] A 1 B 2 A 3 B 4 A 5 C f(j) 0 0 1 2 3 0 Datastrukturer och algoritmer VT 2005 30 © Anders Broberg, Ulrika Hägglund, Lena Kallin Westin, 2003
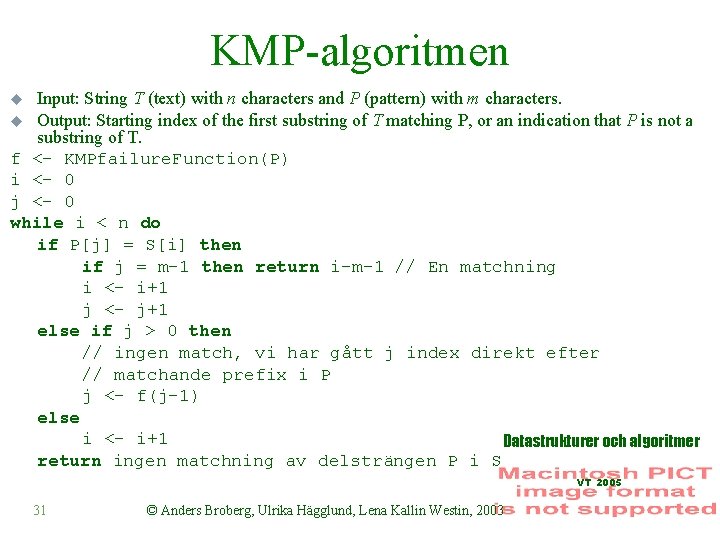
KMP-algoritmen Input: String T (text) with n characters and P (pattern) with m characters. u Output: Starting index of the first substring of T matching P, or an indication that P is not a substring of T. f <- KMPfailure. Function(P) i <- 0 j <- 0 while i < n do if P[j] = S[i] then if j = m-1 then return i-m-1 // En matchning i <- i+1 j <- j+1 else if j > 0 then // ingen match, vi har gått j index direkt efter // matchande prefix i P j <- f(j-1) else i <- i+1 Datastrukturer och algoritmer return ingen matchning av delsträngen P i S u VT 2005 31 © Anders Broberg, Ulrika Hägglund, Lena Kallin Westin, 2003
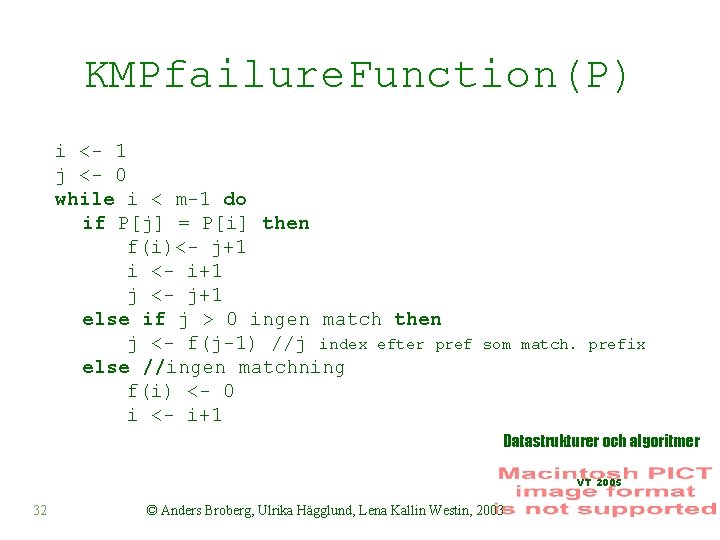
KMPfailure. Function(P) i <- 1 j <- 0 while i < m-1 do if P[j] = P[i] then f(i)<- j+1 i <- i+1 j <- j+1 else if j > 0 ingen match then j <- f(j-1) //j index efter pref else //ingen matchning f(i) <- 0 i <- i+1 som match. prefix Datastrukturer och algoritmer VT 2005 32 © Anders Broberg, Ulrika Hägglund, Lena Kallin Westin, 2003
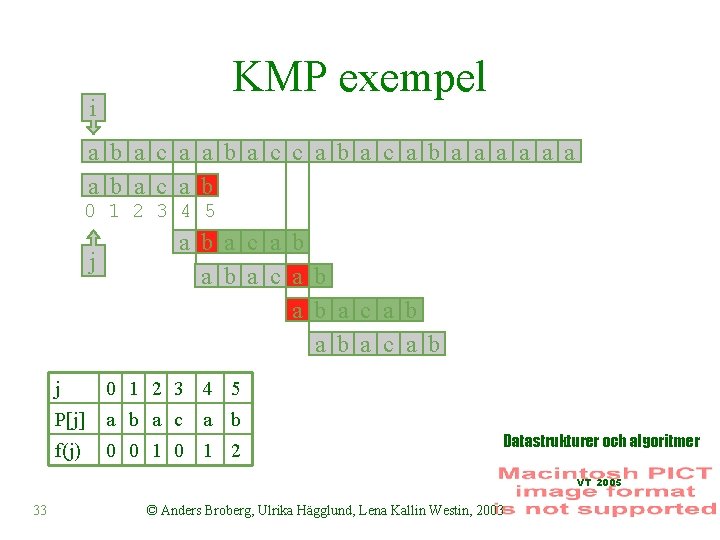
KMP exempel i a b a c a a b a c c a b a a a a b a c a b 0 1 2 3 4 5 j a b a c a b j 0 1 2 3 4 5 P[j] a b a c a b f(j) 0 0 1 2 Datastrukturer och algoritmer VT 2005 33 © Anders Broberg, Ulrika Hägglund, Lena Kallin Westin, 2003
KMP-Algoritmen u u u Låt k = i - j För varje varv i while-loopen händer ett av följande: Ø S[i] = P[j], öka i och j med 1, k oförändrad. Ø S[i] < > P[j] och j > 0, i är oförändrad men k ökar med minst 1 eftersom den ändras från i - j to i - f(j-1) Ø S[i] < > P[j] och j = 0, öka i med 1 och minska k med 1 (ty j oförändrad). Alltså för varje varv i loopen ökar antingen i eller k med minst 1. Max antal varv blir 2 n Detta antar att f redan är beräknad (som är O(m)). Datastrukturer och algoritmer Total komplexitet: O(n + m) VT 2005 34 © Anders Broberg, Ulrika Hägglund, Lena Kallin Westin, 2003
Rabin-Karp u Beräkna ett hashvärde för mönstret och för varje delsträng av texten som man ska jämföra med u Om hashvärdena är skilda, beräkna hashvärdet för det nästa M tecknen i texten u Om hashvärdena är lika, utför en brute-force jämförelse mellan P och delsträngen u Med andra ord: ØEndast en jämförelse per deltext Datastrukturer och algoritmer ØBrute-force endast när hashvärderna matchar. VT 2005 35 © Anders Broberg, Ulrika Hägglund, Lena Kallin Westin, 2003
Rabin-Karp exempel Hashvärdet för AAAAA = 37 Hashvärdet för AAAAH = 100 AAAAAAAAAAAAAAAAH 100 <> 37 AAAAAAAHA AAAAH 100 = 100 Datastrukturer och algoritmer VT 2005 36 © Anders Broberg, Ulrika Hägglund, Lena Kallin Westin, 2003
Rabin-Karp hashfunktionen u Vilken? Den får inte kosta för mycket. . u Betrakta M som ett M-siffrigt tal i basen b, där b är antalet bokstäver i alfabetet u Textsekvensen t[i. . i+M-1] avbildas på talet x(i) = t[i]b. M-1+ t[i+1]b. M-2+. . . + t[i+M-1] Datastrukturer och algoritmer VT 2005 37 © Anders Broberg, Ulrika Hägglund, Lena Kallin Westin, 2003
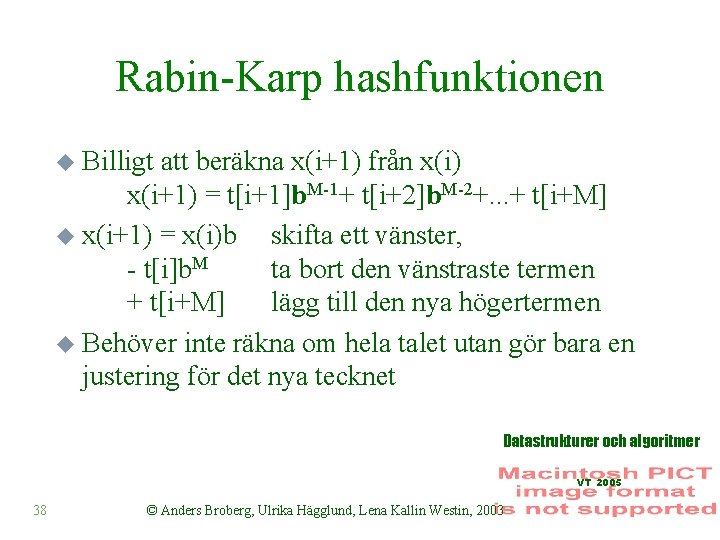
Rabin-Karp hashfunktionen u Billigt att beräkna x(i+1) från x(i) x(i+1) = t[i+1]b. M-1+ t[i+2]b. M-2+. . . + t[i+M] u x(i+1) = x(i)b skifta ett vänster, - t[i]b. M ta bort den vänstraste termen + t[i+M] lägg till den nya högertermen u Behöver inte räkna om hela talet utan gör bara en justering för det nya tecknet Datastrukturer och algoritmer VT 2005 38 © Anders Broberg, Ulrika Hägglund, Lena Kallin Westin, 2003
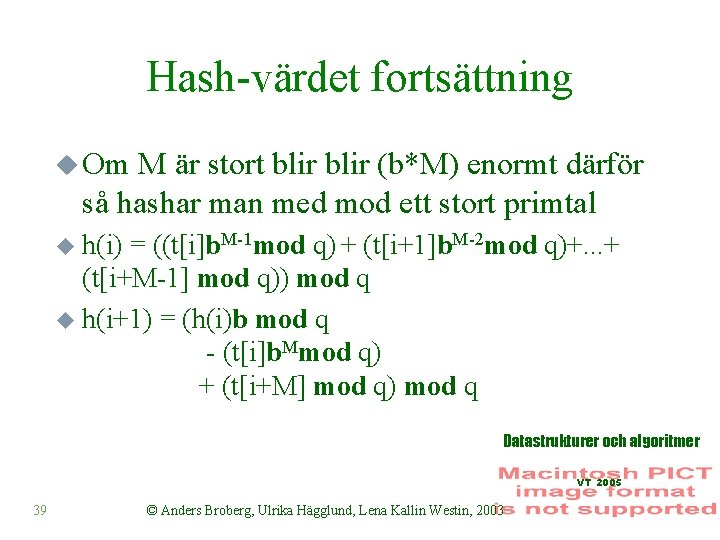
Hash-värdet fortsättning u Om M är stort blir (b*M) enormt därför så hashar man med mod ett stort primtal u h(i) = ((t[i]b. M-1 mod q) + (t[i+1]b. M-2 mod q)+. . . + (t[i+M-1] mod q)) mod q u h(i+1) = (h(i)b mod q - (t[i]b. Mmod q) + (t[i+M] mod q) mod q Datastrukturer och algoritmer VT 2005 39 © Anders Broberg, Ulrika Hägglund, Lena Kallin Westin, 2003
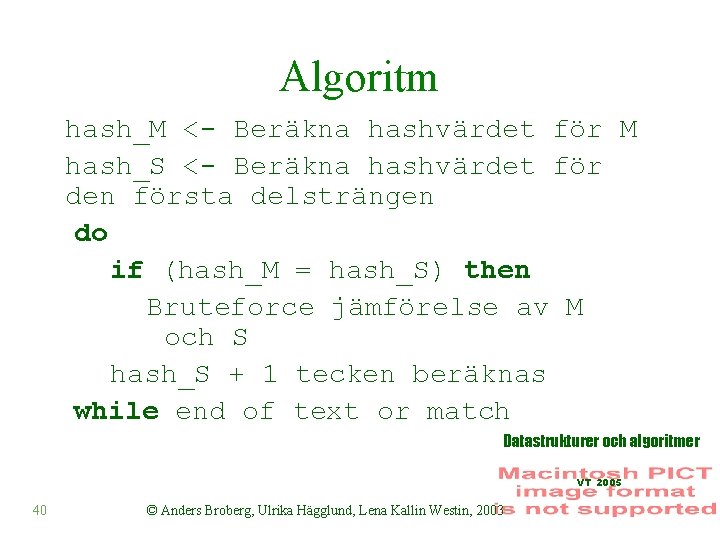
Algoritm hash_M <- Beräkna hashvärdet för M hash_S <- Beräkna hashvärdet för den första delsträngen do if (hash_M = hash_S) then Bruteforce jämförelse av M och S hash_S + 1 tecken beräknas while end of text or match Datastrukturer och algoritmer VT 2005 40 © Anders Broberg, Ulrika Hägglund, Lena Kallin Westin, 2003
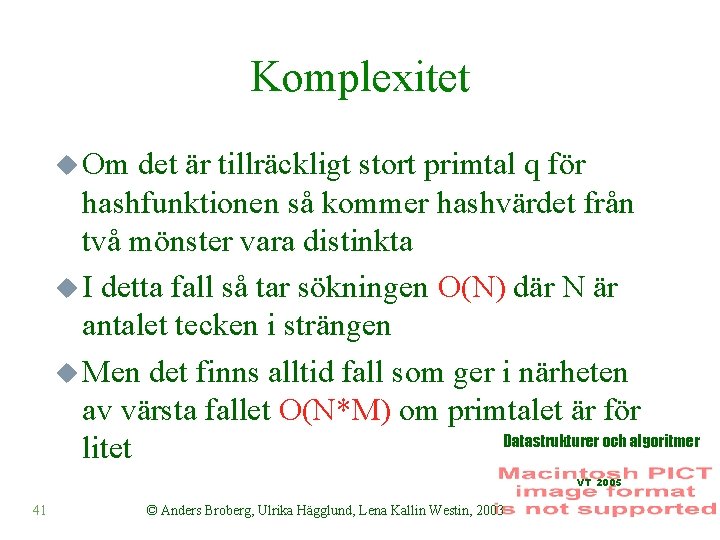
Komplexitet u Om det är tillräckligt stort primtal q för hashfunktionen så kommer hashvärdet från två mönster vara distinkta u I detta fall så tar sökningen O(N) där N är antalet tecken i strängen u Men det finns alltid fall som ger i närheten av värsta fallet O(N*M) om primtalet är för Datastrukturer och algoritmer litet VT 2005 41 © Anders Broberg, Ulrika Hägglund, Lena Kallin Westin, 2003
Boyer-Moores algoritm u u Liknar KMP Två idéer: Ø Gör matchningen baklänges, med start i mönstrets sista element. Ø Utnyttja kunskap om mönstrets uppbyggnad och informationen om värdet på den första felmatchande elementet i S för att flytta fram mönstret så långt som möjligt varje gång. o Om det finns upprepningar av element i mönstret så får man bara flytta fram till den högraste förekomsten. o Förskjutningstabell talar Datastrukturer och algoritmer om hur långt man får flytta. VT 2005 42 © Anders Broberg, Ulrika Hägglund, Lena Kallin Westin, 2003
- Slides: 42