
CS 4803 7643 Deep Learning Topics Variational AutoEncoders
- Slides: 61
CS 4803 / 7643: Deep Learning Topics: – Variational Auto-Encoders (VAEs) – Reparameterization trick Dhruv Batra Georgia Tech
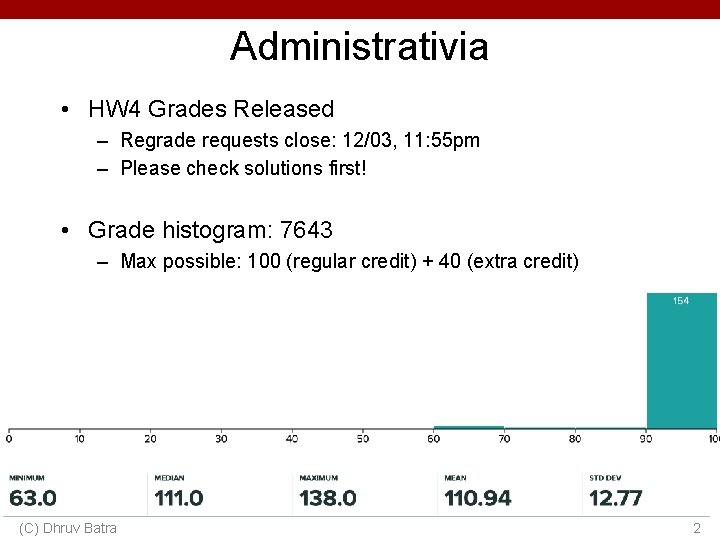
Administrativia • HW 4 Grades Released – Regrade requests close: 12/03, 11: 55 pm – Please check solutions first! • Grade histogram: 7643 – Max possible: 100 (regular credit) + 40 (extra credit) (C) Dhruv Batra 2
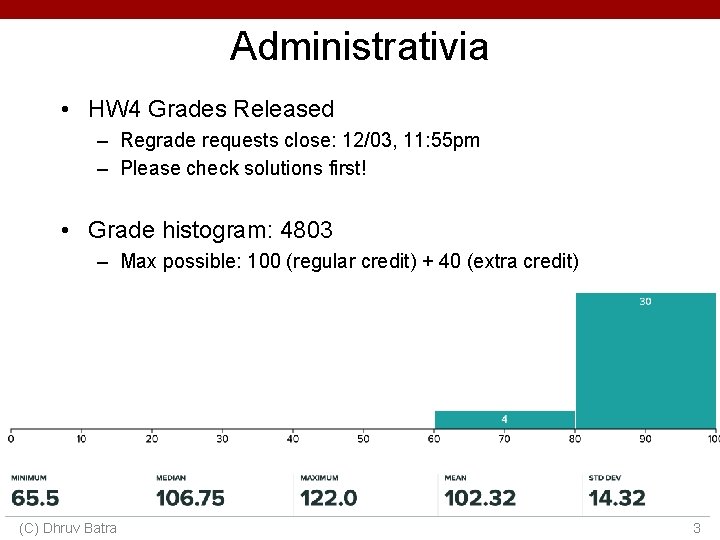
Administrativia • HW 4 Grades Released – Regrade requests close: 12/03, 11: 55 pm – Please check solutions first! • Grade histogram: 4803 – Max possible: 100 (regular credit) + 40 (extra credit) (C) Dhruv Batra 3
Recap from last time (C) Dhruv Batra 4
Variational Autoencoders (VAE)
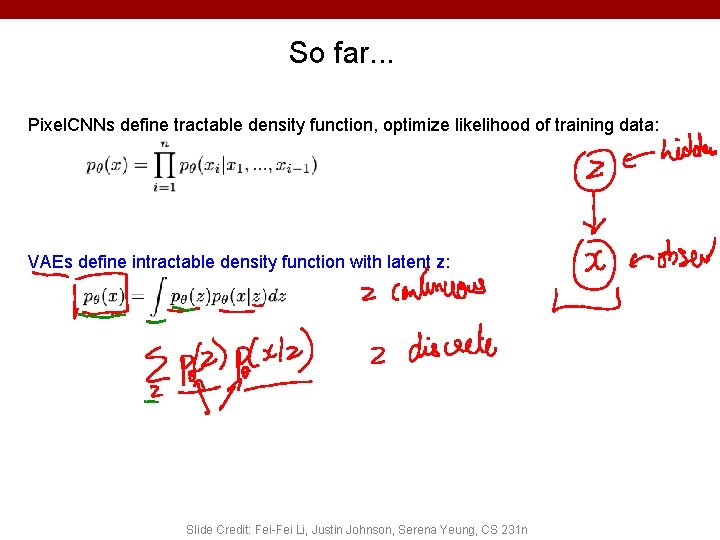
So far. . . Pixel. CNNs define tractable density function, optimize likelihood of training data: VAEs define intractable density function with latent z: Slide Credit: Fei-Fei Li, Justin Johnson, Serena Yeung, CS 231 n
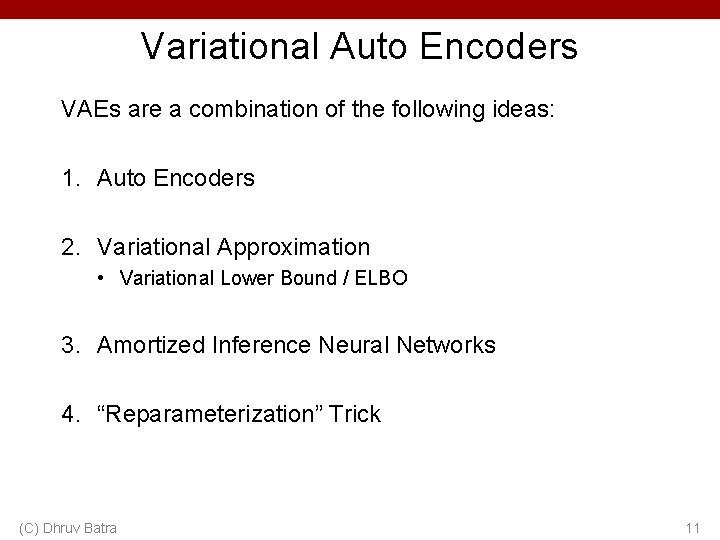
Variational Auto Encoders VAEs are a combination of the following ideas: 1. Auto Encoders 2. Variational Approximation • Variational Lower Bound / ELBO 3. Amortized Inference Neural Networks 4. “Reparameterization” Trick (C) Dhruv Batra 7
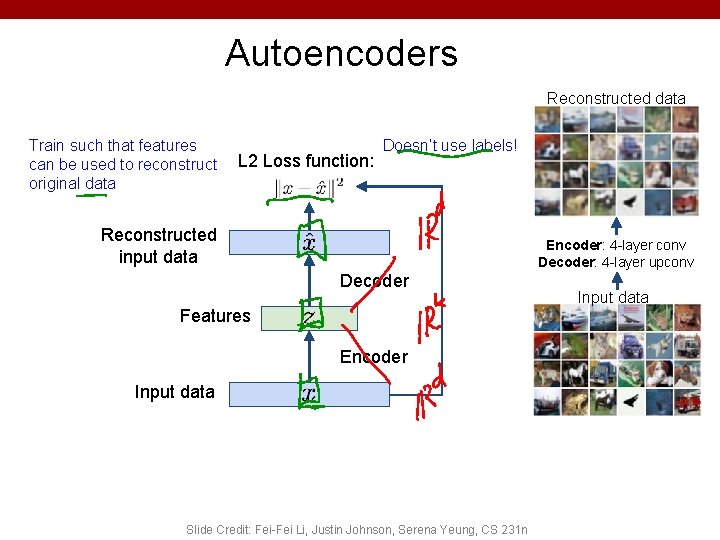
Autoencoders Reconstructed data Train such that features can be used to reconstruct original data L 2 Loss function: Doesn’t use labels! Reconstructed input data Encoder: 4 -layer conv Decoder: 4 -layer upconv Decoder Features Encoder Input data Slide Credit: Fei-Fei Li, Justin Johnson, Serena Yeung, CS 231 n Input data
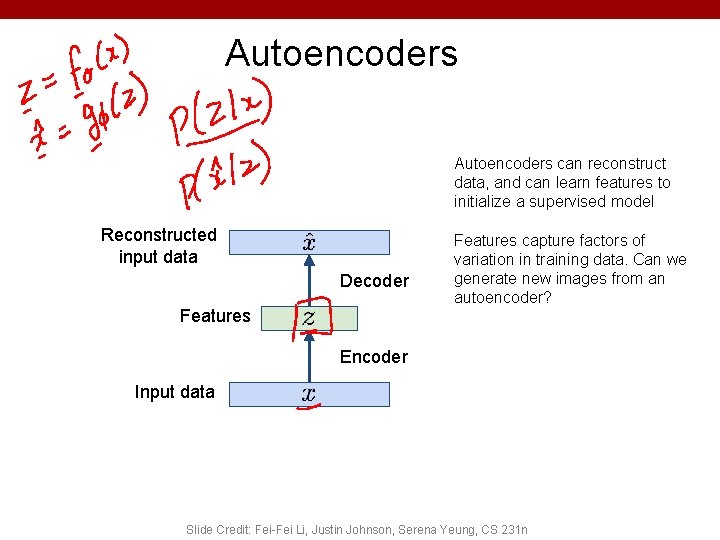
Autoencoders can reconstruct data, and can learn features to initialize a supervised model Reconstructed input data Decoder Features capture factors of variation in training data. Can we generate new images from an autoencoder? Encoder Input data Slide Credit: Fei-Fei Li, Justin Johnson, Serena Yeung, CS 231 n
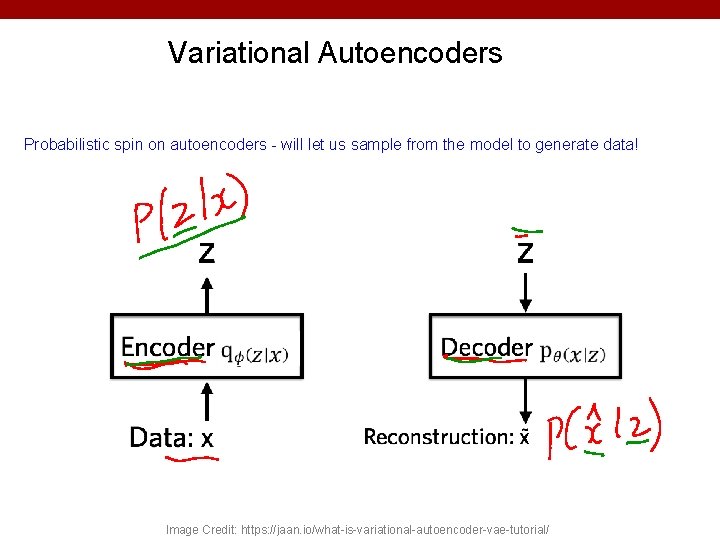
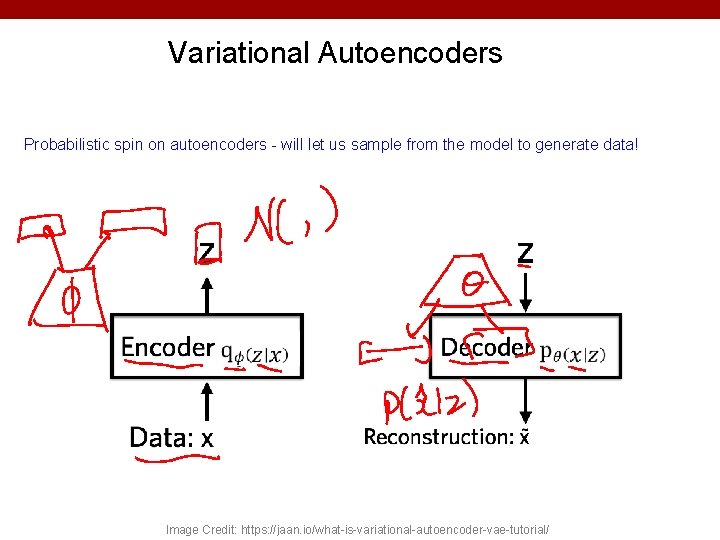
Variational Autoencoders Probabilistic spin on autoencoders - will let us sample from the model to generate data! Image Credit: https: //jaan. io/what-is-variational-autoencoder-vae-tutorial/
Variational Auto Encoders VAEs are a combination of the following ideas: 1. Auto Encoders 2. Variational Approximation • Variational Lower Bound / ELBO 3. Amortized Inference Neural Networks 4. “Reparameterization” Trick (C) Dhruv Batra 11
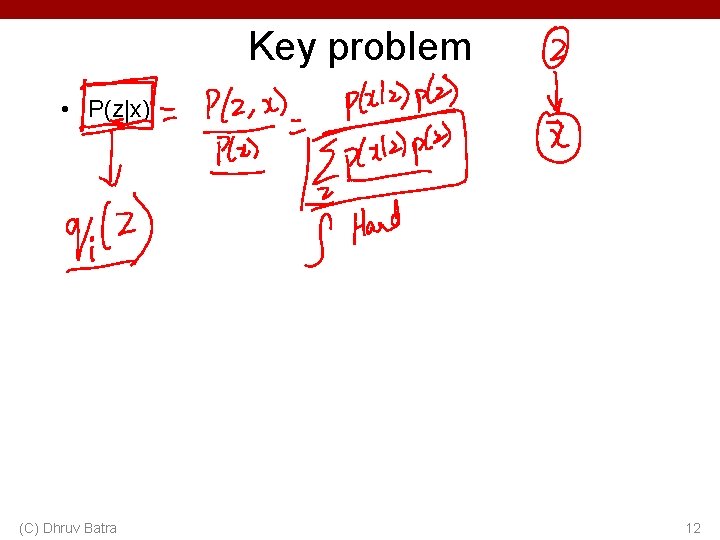
Key problem • P(z|x) (C) Dhruv Batra 12
What is Variational Inference? • Key idea – Reality is complex – Can we approximate it with something “simple”? – Just make sure simple thing is “close” to the complex thing. (C) Dhruv Batra 13
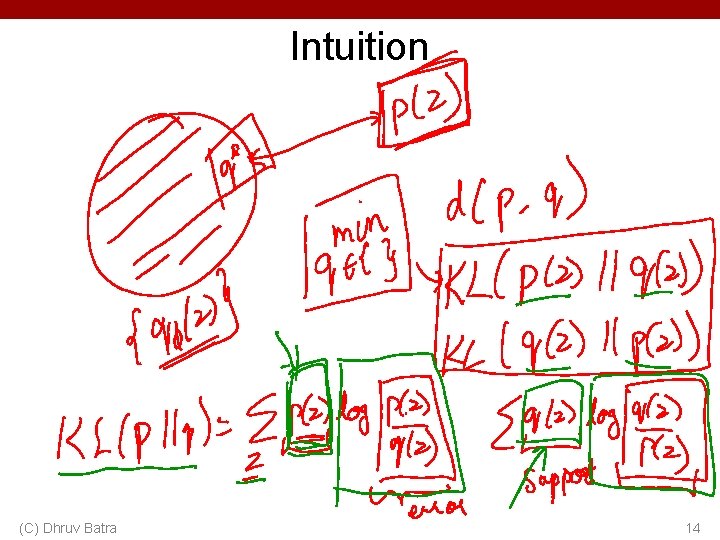
Intuition (C) Dhruv Batra 14
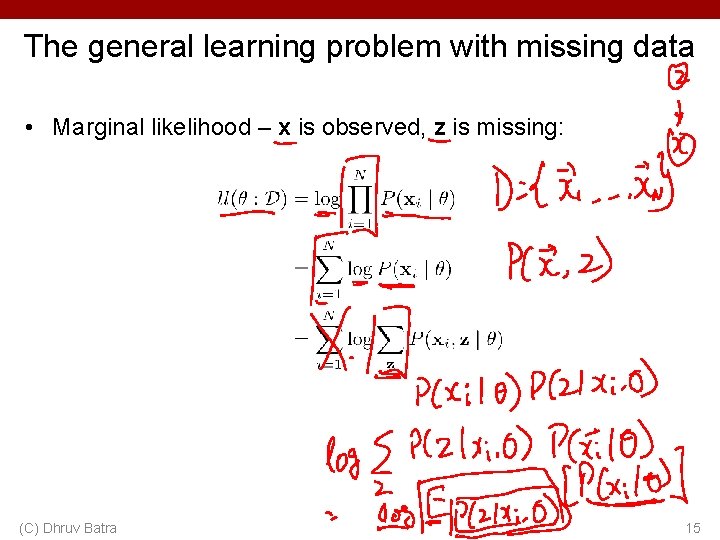
The general learning problem with missing data • Marginal likelihood – x is observed, z is missing: (C) Dhruv Batra 15
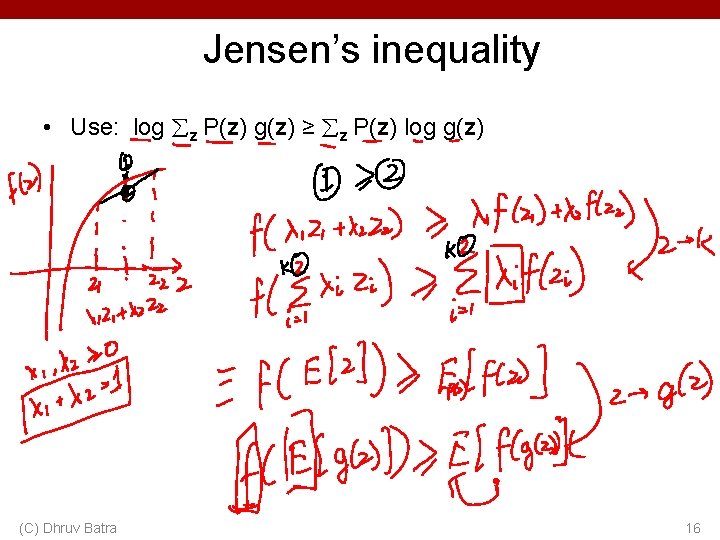
Jensen’s inequality • Use: log z P(z) g(z) ≥ z P(z) log g(z) (C) Dhruv Batra 16
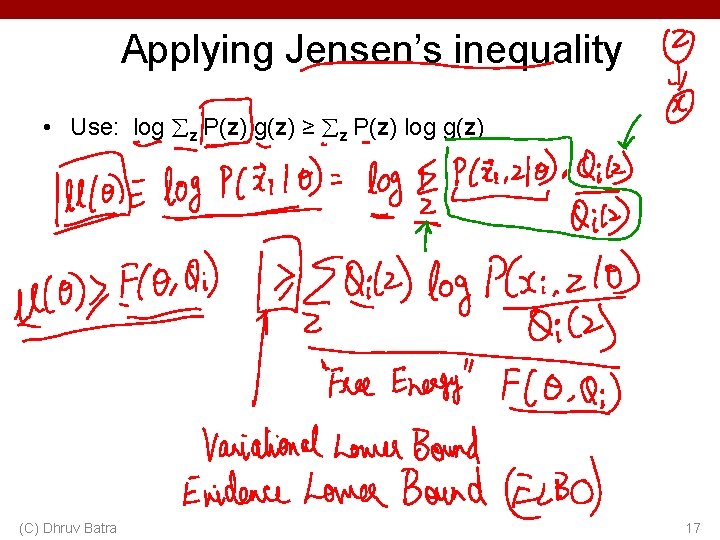
Applying Jensen’s inequality • Use: log z P(z) g(z) ≥ z P(z) log g(z) (C) Dhruv Batra 17
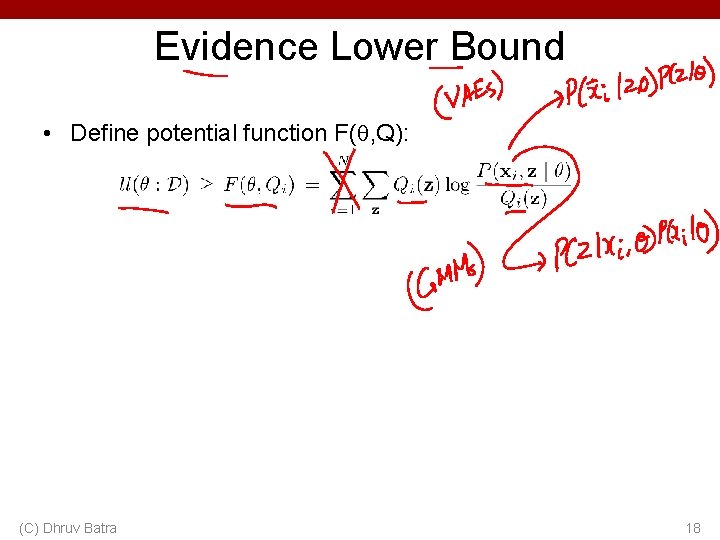
Evidence Lower Bound • Define potential function F( , Q): (C) Dhruv Batra 18
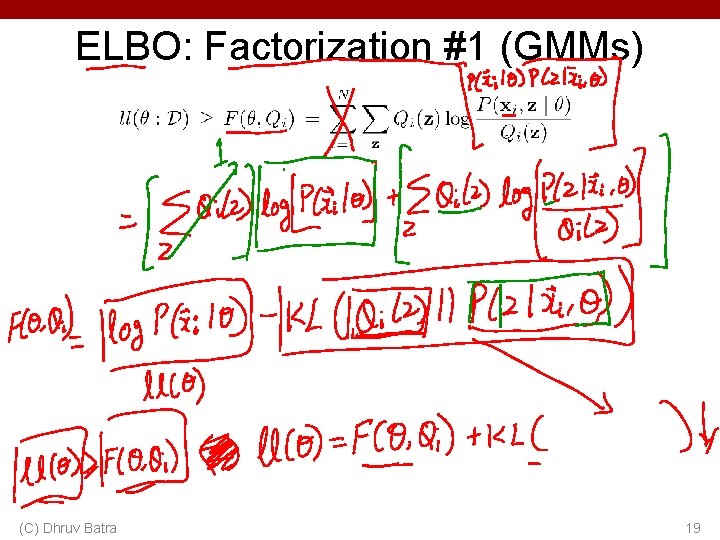
ELBO: Factorization #1 (GMMs) (C) Dhruv Batra 19
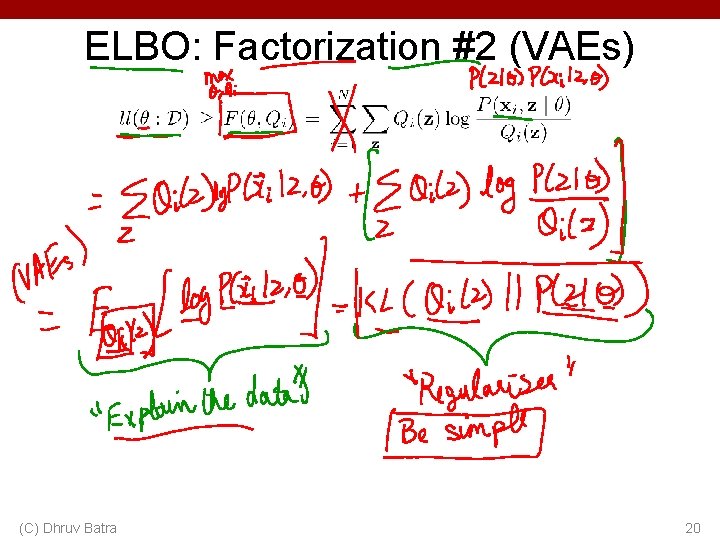
ELBO: Factorization #2 (VAEs) (C) Dhruv Batra 20
Variational Auto Encoders VAEs are a combination of the following ideas: 1. Auto Encoders 2. Variational Approximation • Variational Lower Bound / ELBO 3. Amortized Inference Neural Networks 4. “Reparameterization” Trick (C) Dhruv Batra 21
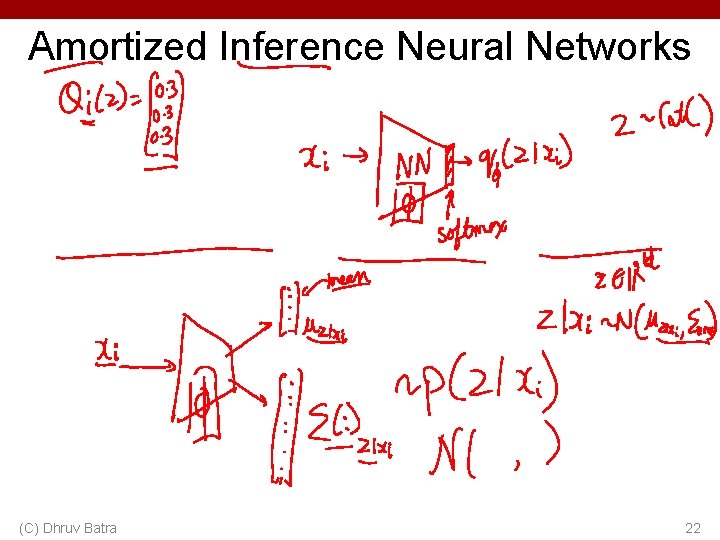
Amortized Inference Neural Networks (C) Dhruv Batra 22
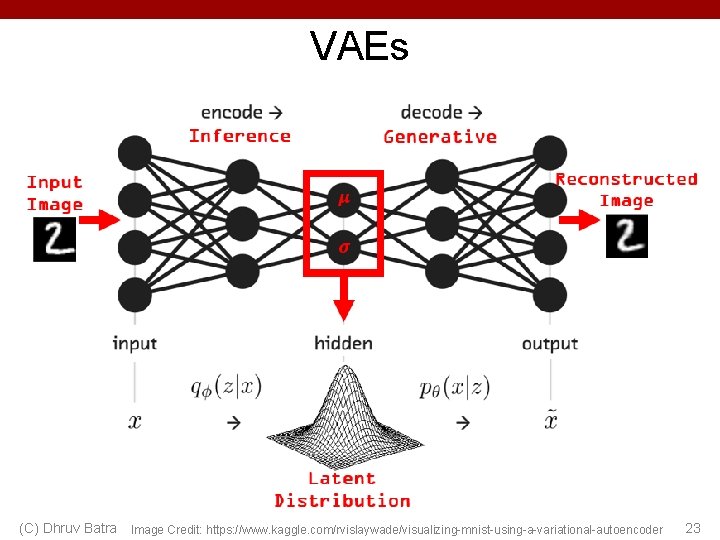
VAEs (C) Dhruv Batra Image Credit: https: //www. kaggle. com/rvislaywade/visualizing-mnist-using-a-variational-autoencoder 23
Variational Autoencoders Probabilistic spin on autoencoders - will let us sample from the model to generate data! Image Credit: https: //jaan. io/what-is-variational-autoencoder-vae-tutorial/
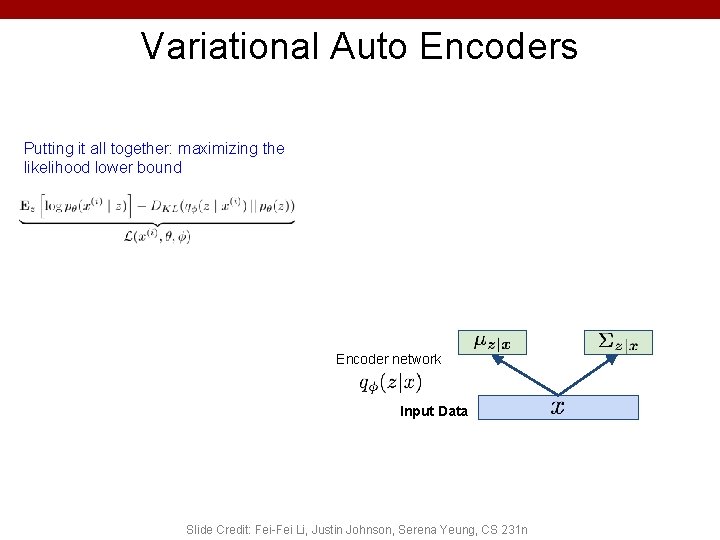
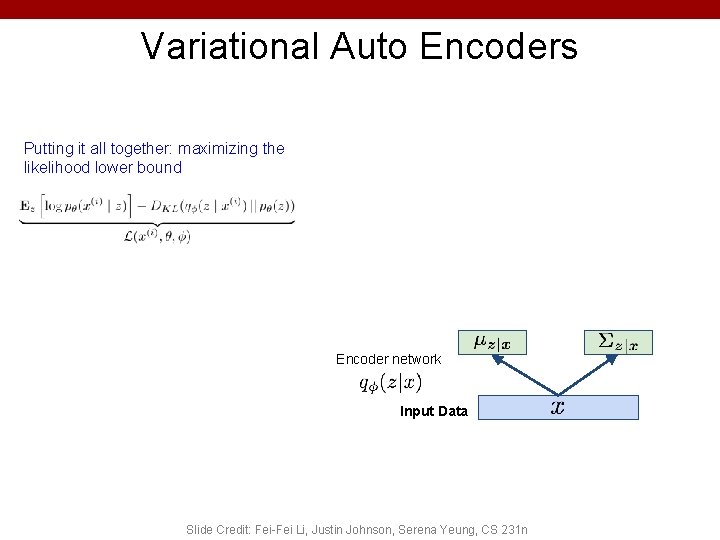
Variational Auto Encoders Putting it all together: maximizing the likelihood lower bound Encoder network Input Data Slide Credit: Fei-Fei Li, Justin Johnson, Serena Yeung, CS 231 n
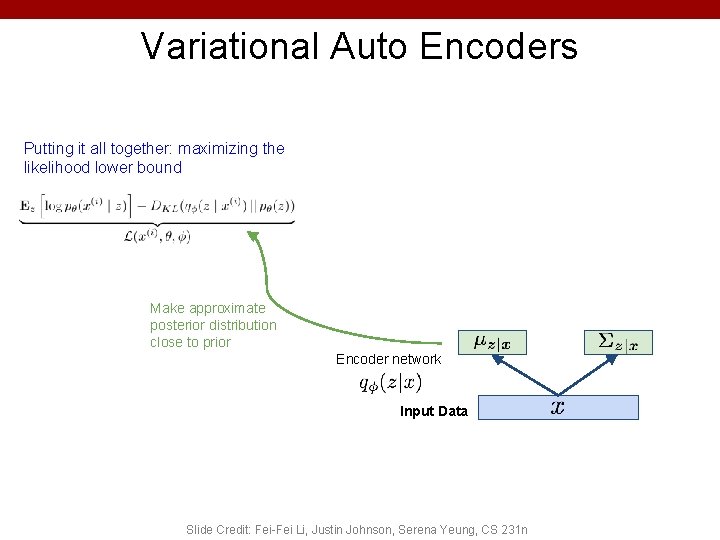
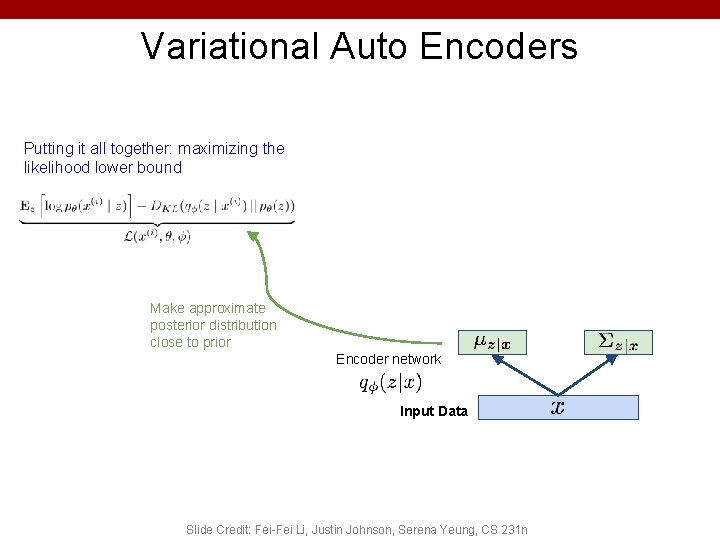
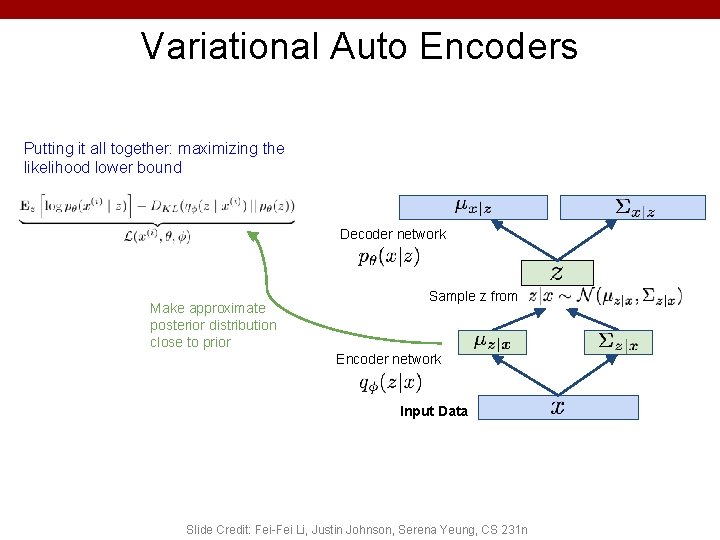
Variational Auto Encoders Putting it all together: maximizing the likelihood lower bound Make approximate posterior distribution close to prior Encoder network Input Data Slide Credit: Fei-Fei Li, Justin Johnson, Serena Yeung, CS 231 n
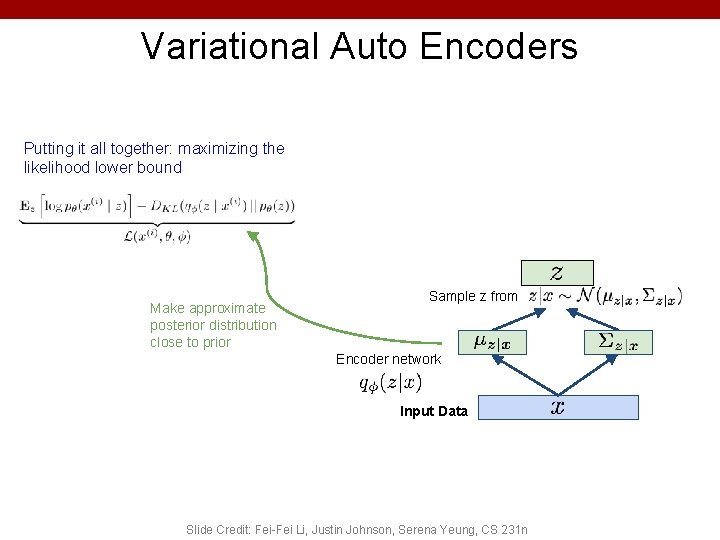
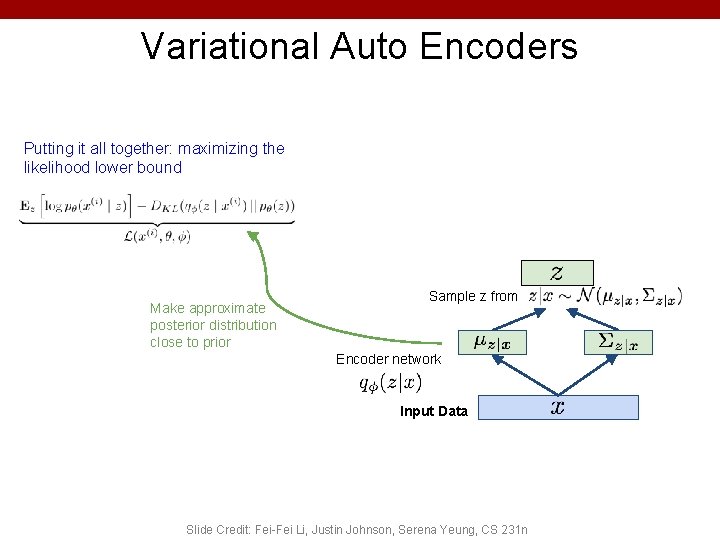
Variational Auto Encoders Putting it all together: maximizing the likelihood lower bound Make approximate posterior distribution close to prior Sample z from Encoder network Input Data Slide Credit: Fei-Fei Li, Justin Johnson, Serena Yeung, CS 231 n
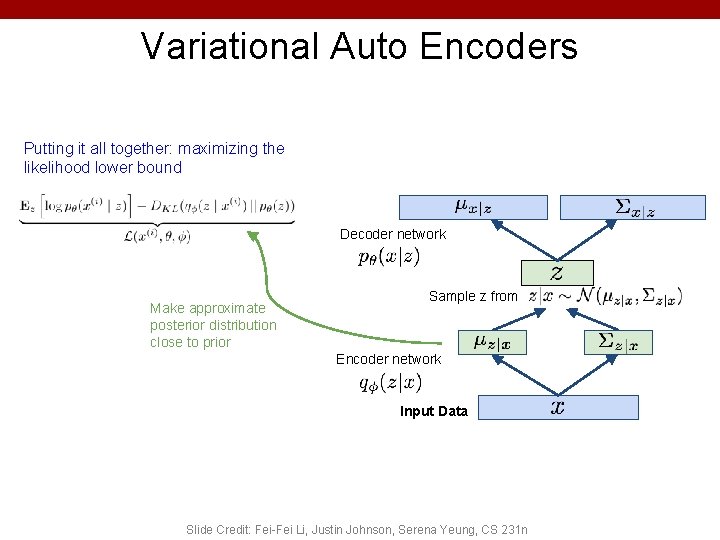
Variational Auto Encoders Putting it all together: maximizing the likelihood lower bound Decoder network Make approximate posterior distribution close to prior Sample z from Encoder network Input Data Slide Credit: Fei-Fei Li, Justin Johnson, Serena Yeung, CS 231 n
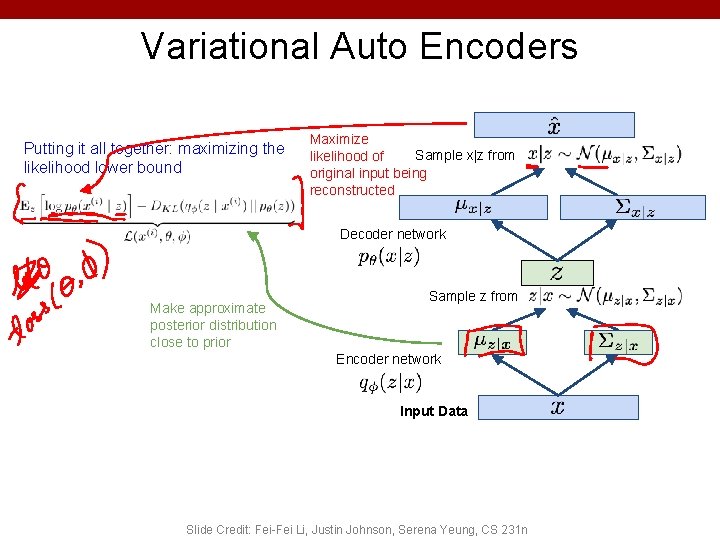
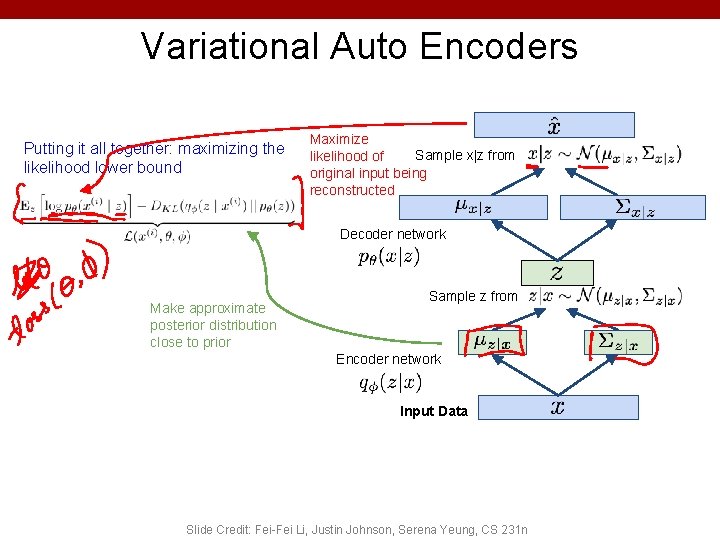
Variational Auto Encoders Putting it all together: maximizing the likelihood lower bound Maximize Sample x|z from likelihood of original input being reconstructed Decoder network Make approximate posterior distribution close to prior Sample z from Encoder network Input Data Slide Credit: Fei-Fei Li, Justin Johnson, Serena Yeung, CS 231 n
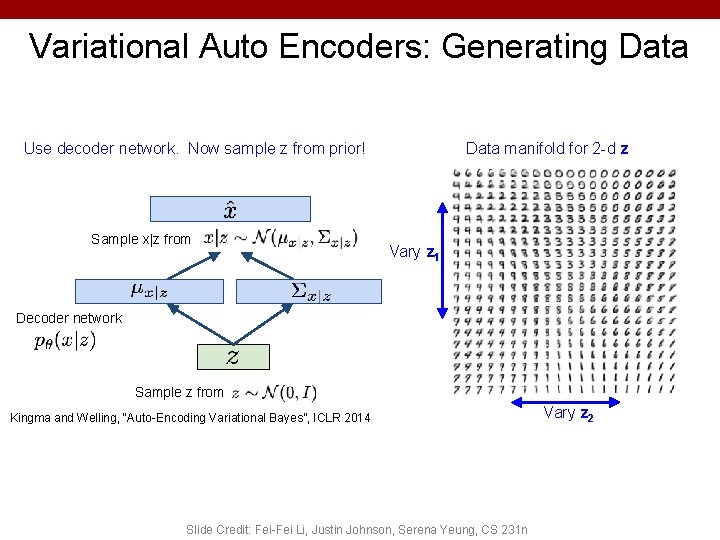
Variational Auto Encoders: Generating Data Use decoder network. Now sample z from prior! Sample x|z from Data manifold for 2 -d z Vary z 1 Decoder network Sample z from Kingma and Welling, “Auto-Encoding Variational Bayes”, ICLR 2014 Slide Credit: Fei-Fei Li, Justin Johnson, Serena Yeung, CS 231 n Vary z 2
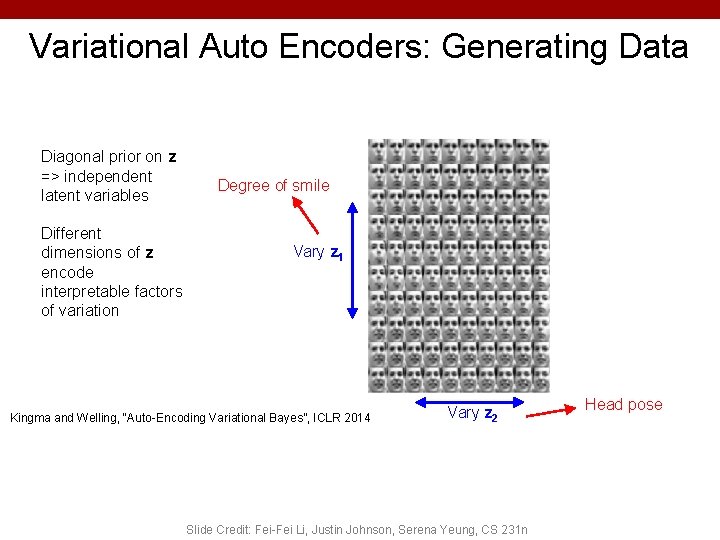
Variational Auto Encoders: Generating Data Diagonal prior on z => independent latent variables Different dimensions of z encode interpretable factors of variation Degree of smile Vary z 1 Kingma and Welling, “Auto-Encoding Variational Bayes”, ICLR 2014 Vary z 2 Slide Credit: Fei-Fei Li, Justin Johnson, Serena Yeung, CS 231 n Head pose
Plan for Today • VAEs – Reparameterization trick (C) Dhruv Batra 32
Variational Auto Encoders VAEs are a combination of the following ideas: 1. Auto Encoders 2. Variational Approximation • Variational Lower Bound / ELBO 3. Amortized Inference Neural Networks 4. “Reparameterization” Trick (C) Dhruv Batra 33
Variational Auto Encoders Putting it all together: maximizing the likelihood lower bound Maximize Sample x|z from likelihood of original input being reconstructed Decoder network Make approximate posterior distribution close to prior Sample z from Encoder network Input Data Slide Credit: Fei-Fei Li, Justin Johnson, Serena Yeung, CS 231 n
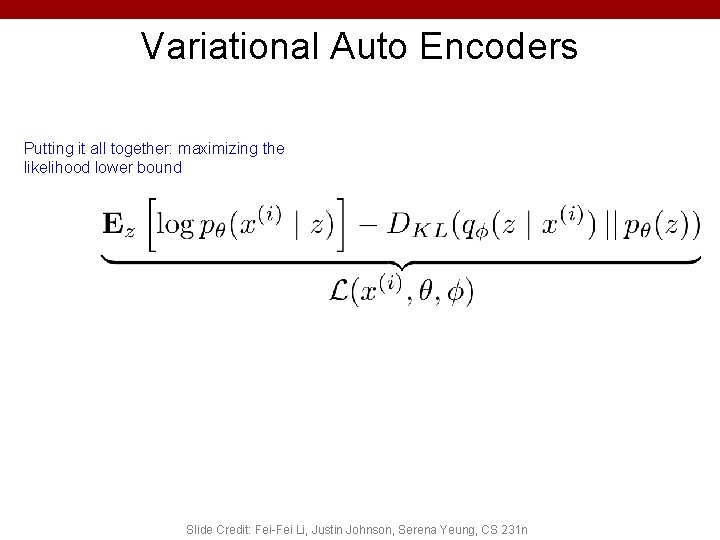
Variational Auto Encoders Putting it all together: maximizing the likelihood lower bound Slide Credit: Fei-Fei Li, Justin Johnson, Serena Yeung, CS 231 n
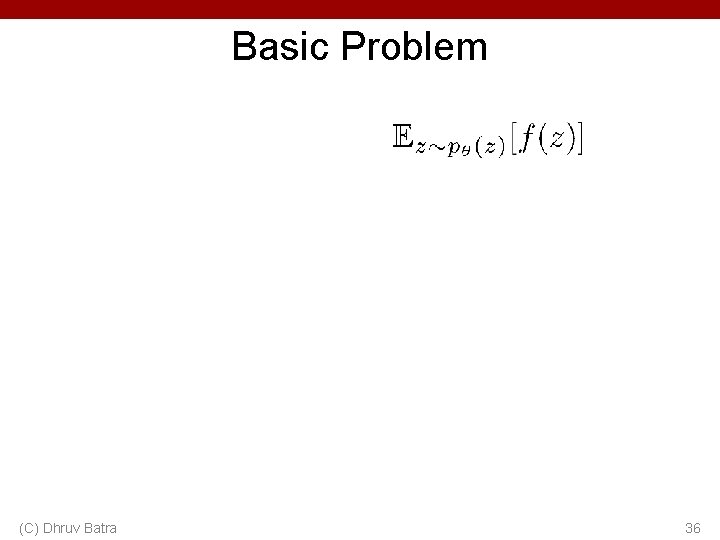
Basic Problem (C) Dhruv Batra 36
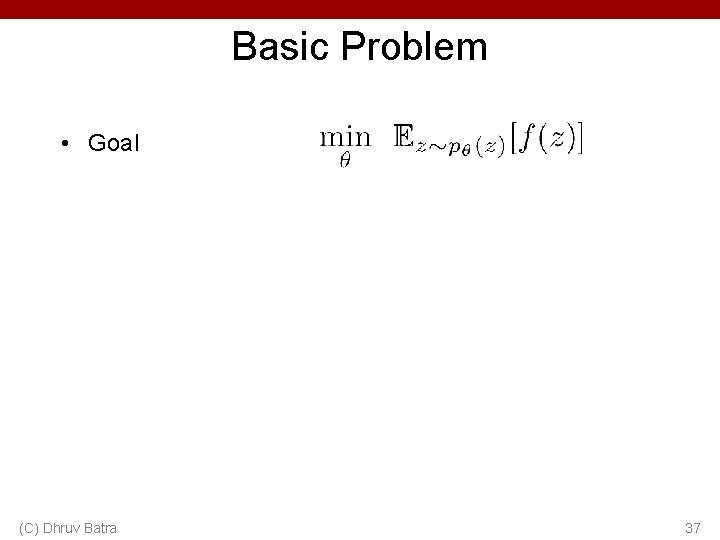
Basic Problem • Goal (C) Dhruv Batra 37
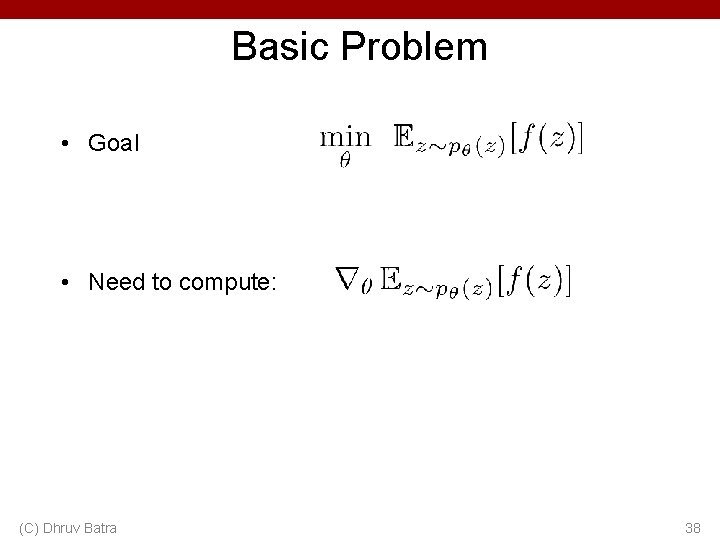
Basic Problem • Goal • Need to compute: (C) Dhruv Batra 38
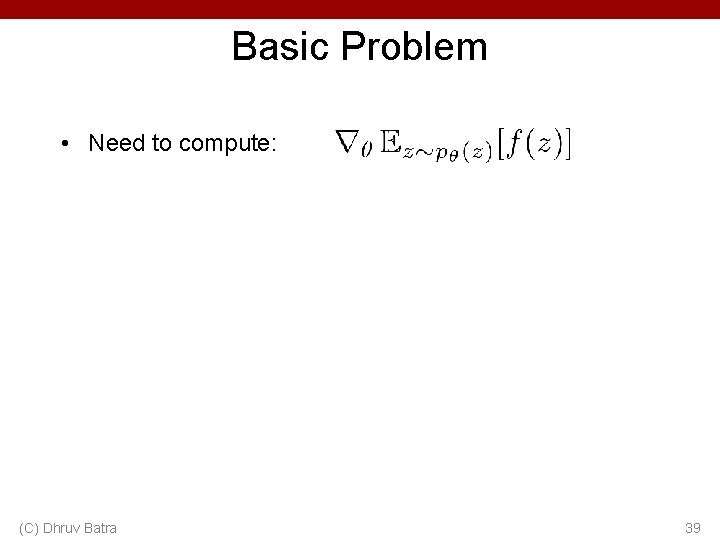
Basic Problem • Need to compute: (C) Dhruv Batra 39
Example (C) Dhruv Batra 40
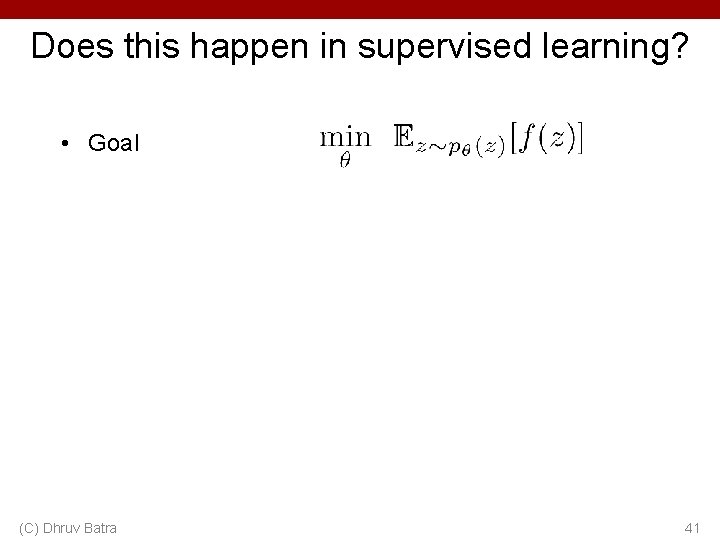
Does this happen in supervised learning? • Goal (C) Dhruv Batra 41
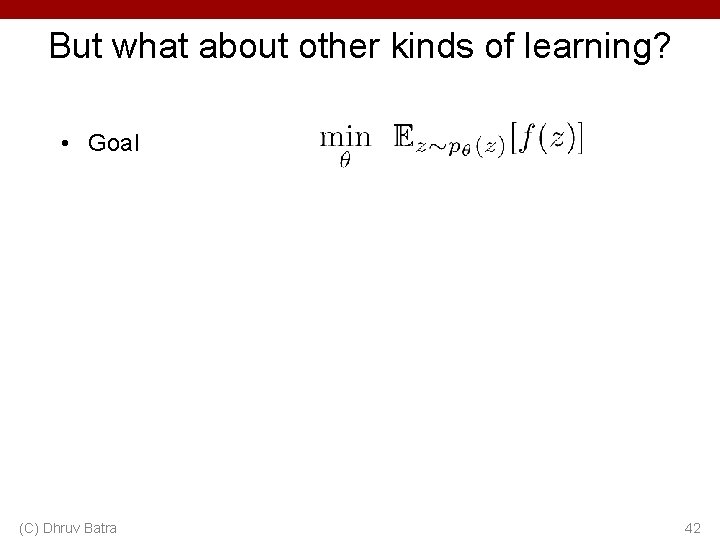
But what about other kinds of learning? • Goal (C) Dhruv Batra 42
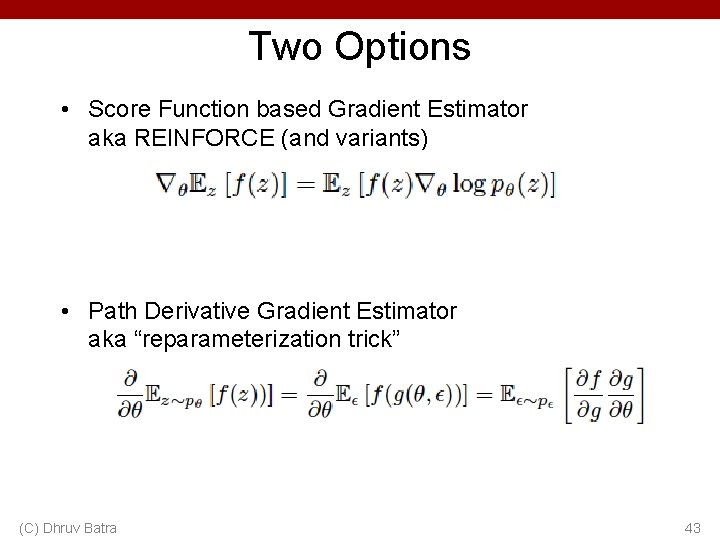
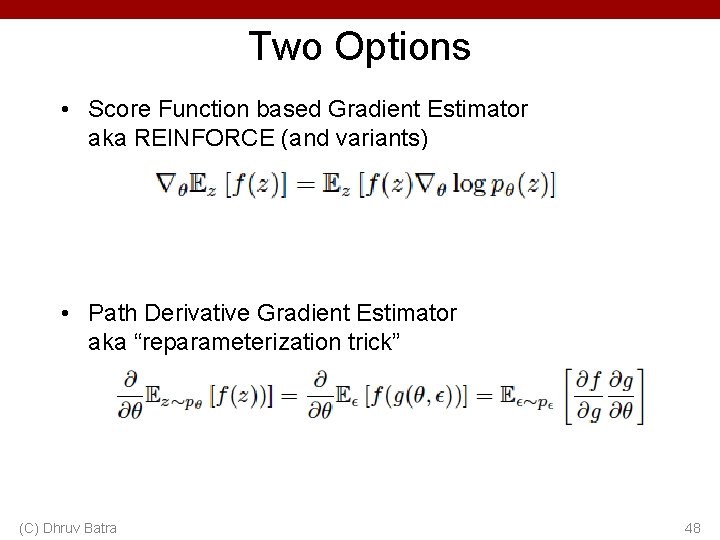
Two Options • Score Function based Gradient Estimator aka REINFORCE (and variants) • Path Derivative Gradient Estimator aka “reparameterization trick” (C) Dhruv Batra 43
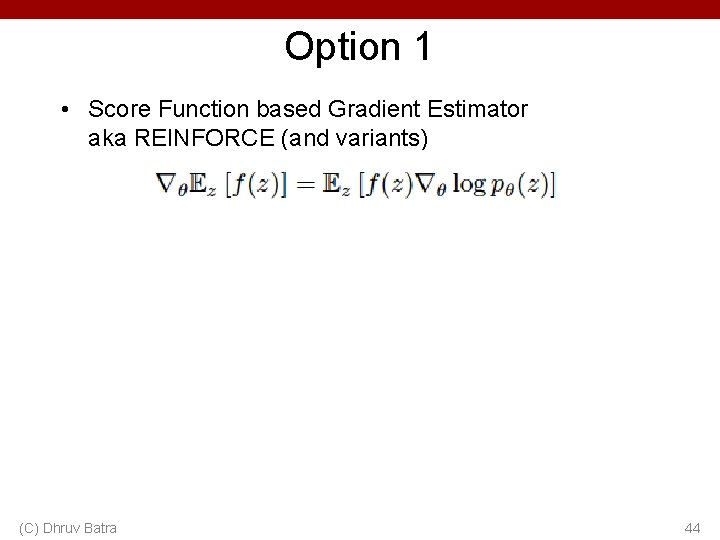
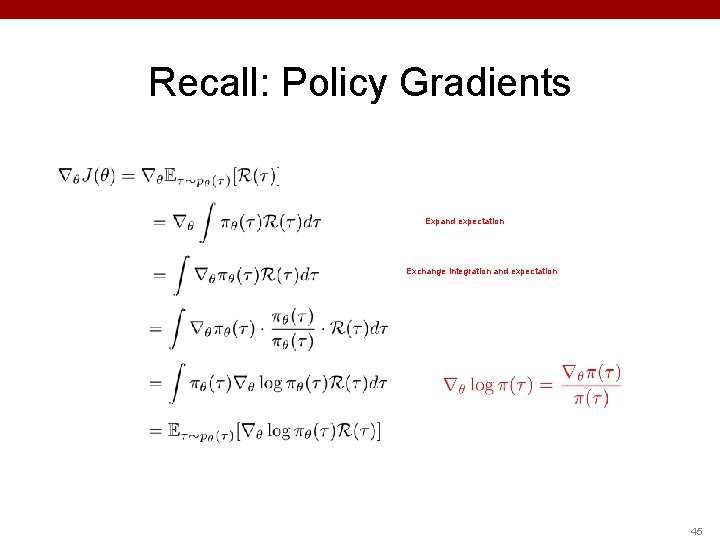
Option 1 • Score Function based Gradient Estimator aka REINFORCE (and variants) (C) Dhruv Batra 44
Recall: Policy Gradients Expand expectation Exchange integration and expectation 45
Example (C) Dhruv Batra 46
Mental Break! • VAE Demo – https: //www. siarez. com/projects/variational-autoencoder (C) Dhruv Batra 47
Two Options • Score Function based Gradient Estimator aka REINFORCE (and variants) • Path Derivative Gradient Estimator aka “reparameterization trick” (C) Dhruv Batra 48
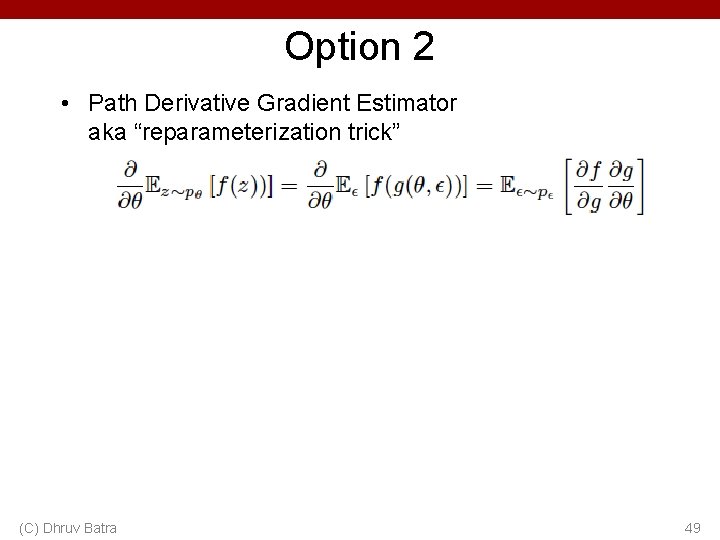
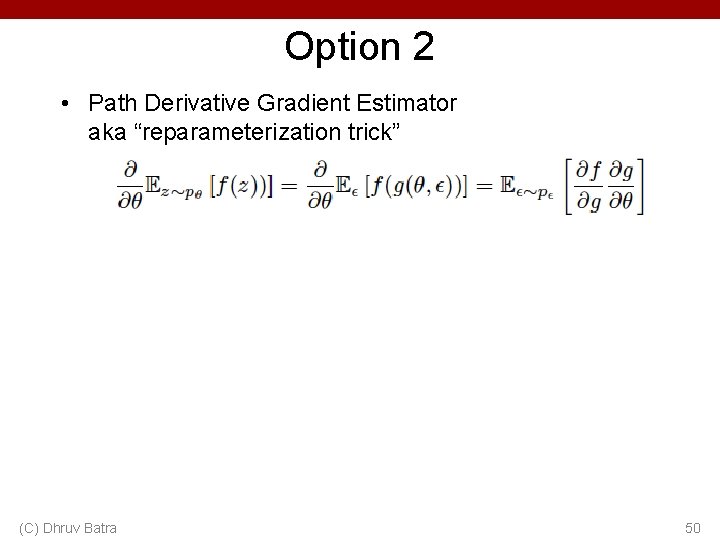
Option 2 • Path Derivative Gradient Estimator aka “reparameterization trick” (C) Dhruv Batra 49
Option 2 • Path Derivative Gradient Estimator aka “reparameterization trick” (C) Dhruv Batra 50
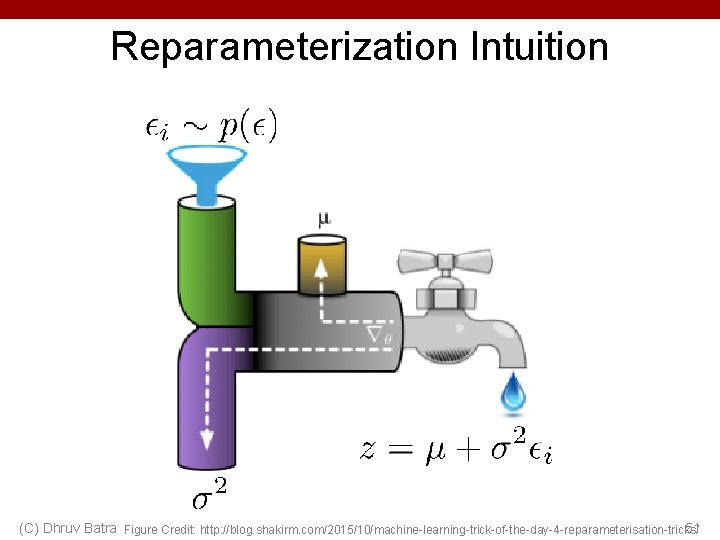
Reparameterization Intuition (C) Dhruv Batra Figure Credit: http: //blog. shakirm. com/2015/10/machine-learning-trick-of-the-day-4 -reparameterisation-tricks/ 51
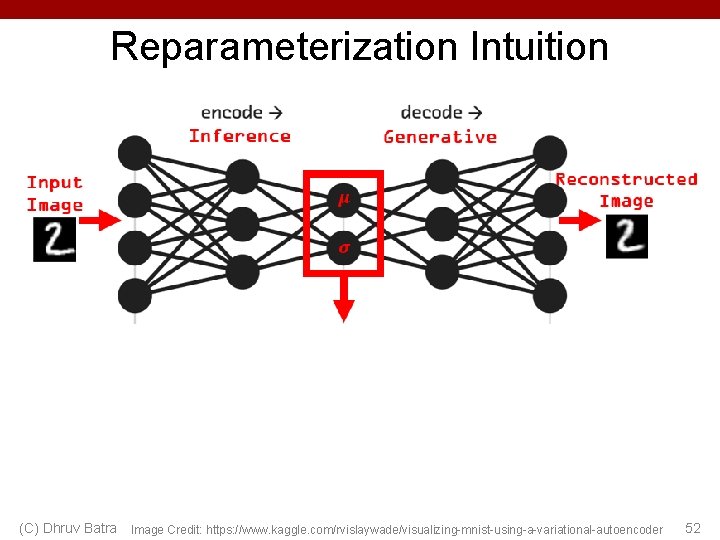
Reparameterization Intuition (C) Dhruv Batra Image Credit: https: //www. kaggle. com/rvislaywade/visualizing-mnist-using-a-variational-autoencoder 52
Example (C) Dhruv Batra 54
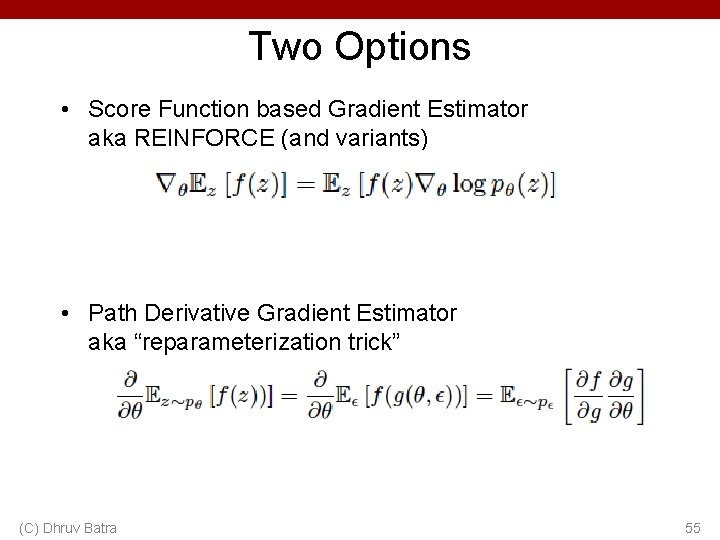
Two Options • Score Function based Gradient Estimator aka REINFORCE (and variants) • Path Derivative Gradient Estimator aka “reparameterization trick” (C) Dhruv Batra 55
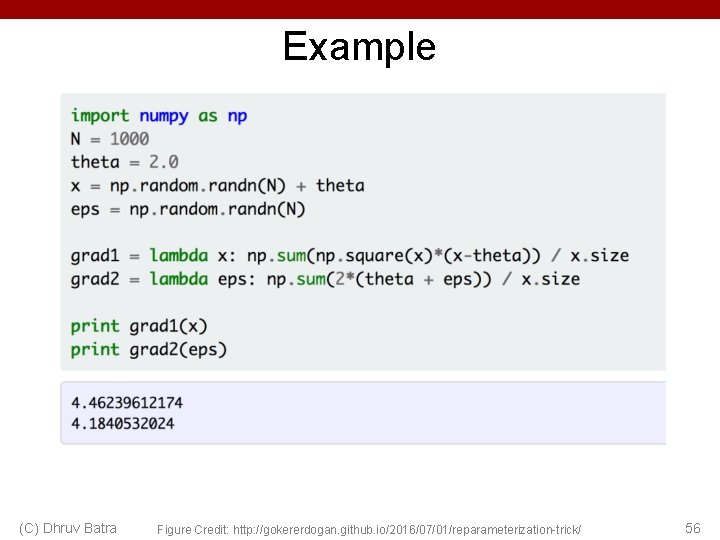
Example (C) Dhruv Batra Figure Credit: http: //gokererdogan. github. io/2016/07/01/reparameterization-trick/ 56
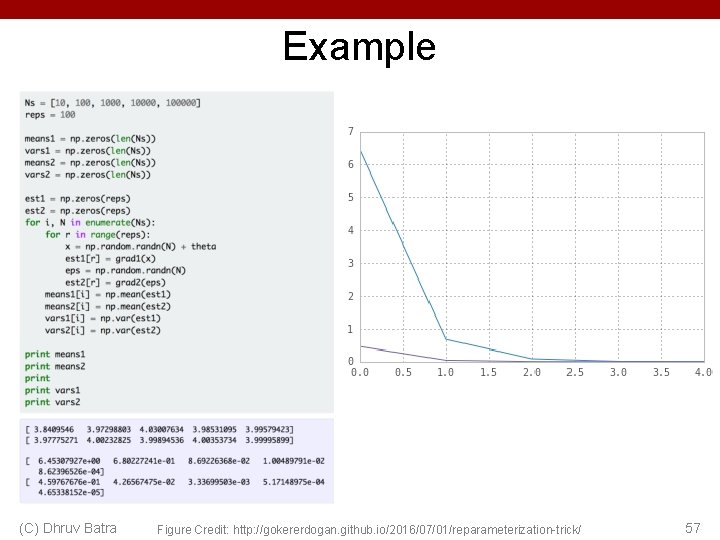
Example (C) Dhruv Batra Figure Credit: http: //gokererdogan. github. io/2016/07/01/reparameterization-trick/ 57
Variational Auto Encoders VAEs are a combination of the following ideas: 1. Auto Encoders 2. Variational Approximation • Variational Lower Bound / ELBO 3. Amortized Inference Neural Networks 4. “Reparameterization” Trick (C) Dhruv Batra 60
Variational Auto Encoders Putting it all together: maximizing the likelihood lower bound Encoder network Input Data Slide Credit: Fei-Fei Li, Justin Johnson, Serena Yeung, CS 231 n
Variational Auto Encoders Putting it all together: maximizing the likelihood lower bound Make approximate posterior distribution close to prior Encoder network Input Data Slide Credit: Fei-Fei Li, Justin Johnson, Serena Yeung, CS 231 n
Variational Auto Encoders Putting it all together: maximizing the likelihood lower bound Make approximate posterior distribution close to prior Sample z from Encoder network Input Data Slide Credit: Fei-Fei Li, Justin Johnson, Serena Yeung, CS 231 n
Variational Auto Encoders Putting it all together: maximizing the likelihood lower bound Decoder network Make approximate posterior distribution close to prior Sample z from Encoder network Input Data Slide Credit: Fei-Fei Li, Justin Johnson, Serena Yeung, CS 231 n