
Cluster Analysis concetti di base e algoritmi Cos
Cluster Analysis: concetti di base e algoritmi
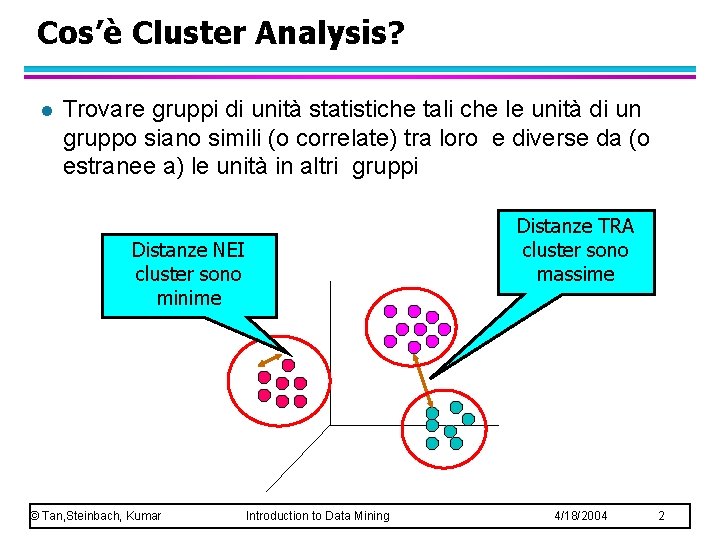
Cos’è Cluster Analysis? l Trovare gruppi di unità statistiche tali che le unità di un gruppo siano simili (o correlate) tra loro e diverse da (o estranee a) le unità in altri gruppi Distanze TRA cluster sono massime Distanze NEI cluster sono minime © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 2
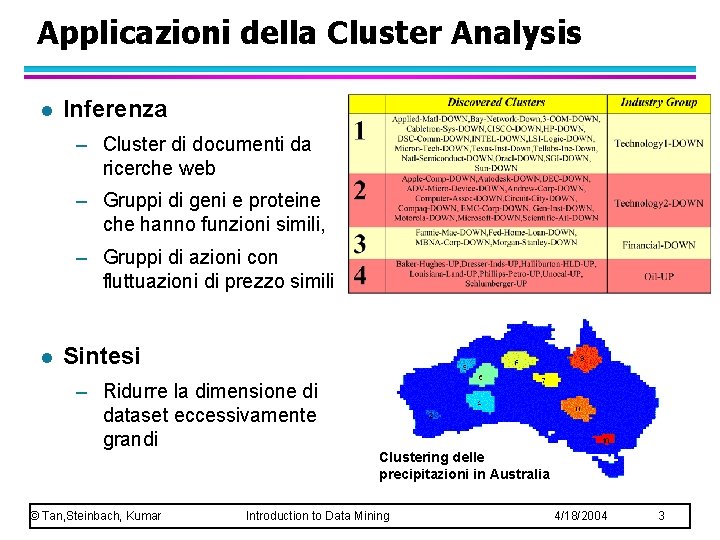
Applicazioni della Cluster Analysis l Inferenza – Cluster di documenti da ricerche web – Gruppi di geni e proteine che hanno funzioni simili, – Gruppi di azioni con fluttuazioni di prezzo simili l Sintesi – Ridurre la dimensione di dataset eccessivamente grandi © Tan, Steinbach, Kumar Clustering delle precipitazioni in Australia Introduction to Data Mining 4/18/2004 3
Non è Cluster Analysis l Classificazione supervisionata delle unità – Quando si ha già l’etichetta di appartenenza ad un gruppo l Segmentazione semplice – Dividere gli studenti in gruppi in base al cognome l Risultato di un’interrogazione del database – Raggruppare in base ad alcune caratteristiche predefinite l Partizione grafica – Rilevanza parziale, ma non la stessa cosa © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 4
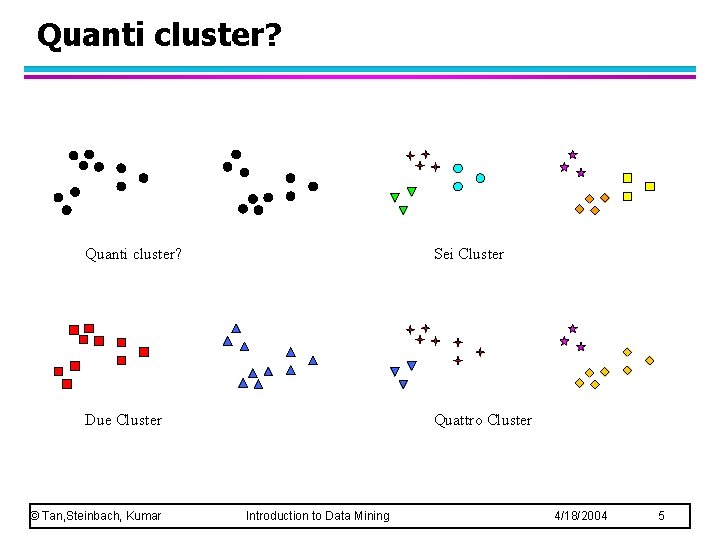
Quanti cluster? Sei Cluster Due Cluster Quattro Cluster © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 5
Clustering l Si definisce clustering un insieme di cluster l Clustering partizionale – Una divisione in cluster che non si sovrappongono l Clustering gerarchico – Un insieme di cluster innestati organizzati come un albero gerarchico © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 6
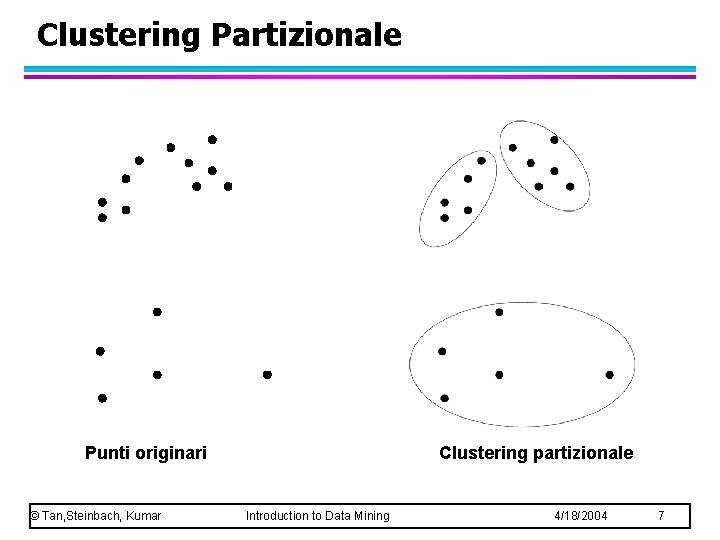
Clustering Partizionale Punti originari © Tan, Steinbach, Kumar Clustering partizionale Introduction to Data Mining 4/18/2004 7
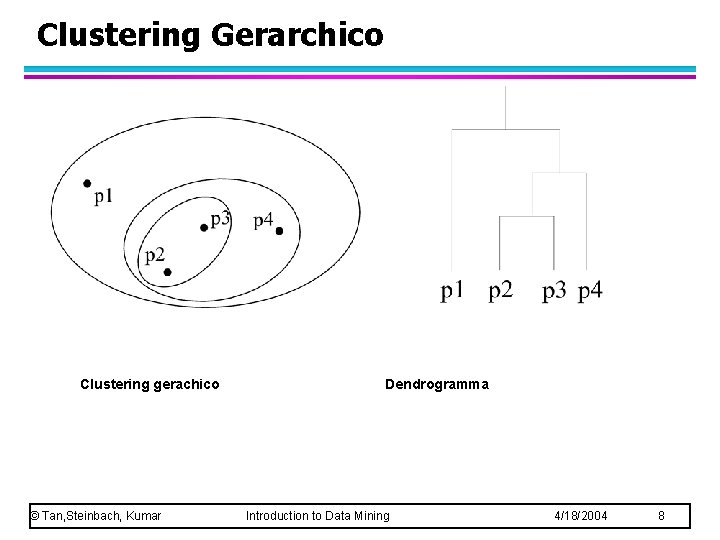
Clustering Gerarchico Clustering gerachico © Tan, Steinbach, Kumar Dendrogramma Introduction to Data Mining 4/18/2004 8
Algoritmi di Clustering l K-means e le sue varianti l Clustering gerarchico l Clustering basato sulla densità © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 9
K-means Clustering l Approccio partizionale al clustering l Ogni cluster è associato ad un centroide (baricentro) l Ogni punto è assegnato al cluster con il baricentro più vicino l Il numero di cluster, K, è specificato dall’analista l L’algoritmo di base è molto semplice: – Seleziona K centroidi iniziali – Assegna le unità al gruppo del centroide più prossimo – Ricalcola I centroidi – Ripeti fino a convergenza © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 10
K-means Clustering – Dettagli l I centroidi iniziali sono spesso scelti in maniera casuale. l Il centroide è (tipicamente) la media dei punti nel gruppo. l La ‘vicinanza’ è misurata usando la distanza Euclidea, similarità angolare, correlazione, etc. l L’algoritmo K-means converge per le più comuni misure di prossimità. l La convergenza avviene di solito dopo poche operazioni. – l Spesso la condizione di arresto viene modificata in 'Fino a quando relativamente pochi punti cambiano cluster‘ La complessità è O( n * K * I * d ) – n = numero di unità, K = numero di cluster, I = numero di iterazioni, d = numero di attributi © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 11
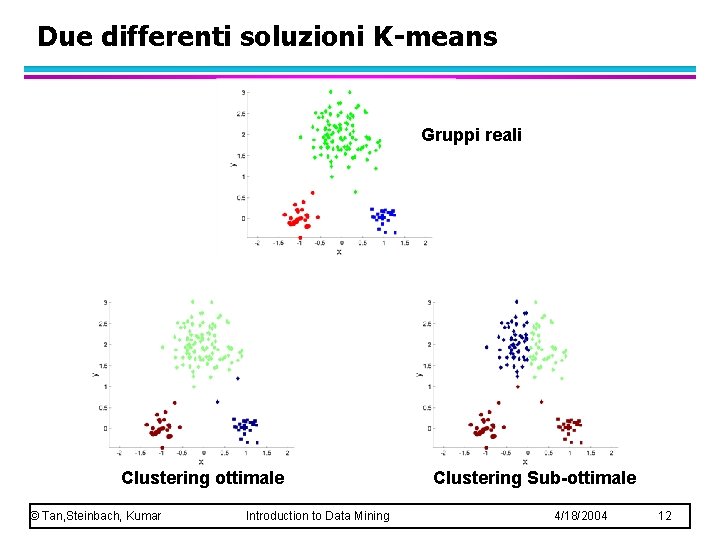
Due differenti soluzioni K-means Gruppi reali Clustering ottimale © Tan, Steinbach, Kumar Introduction to Data Mining Clustering Sub-ottimale 4/18/2004 12
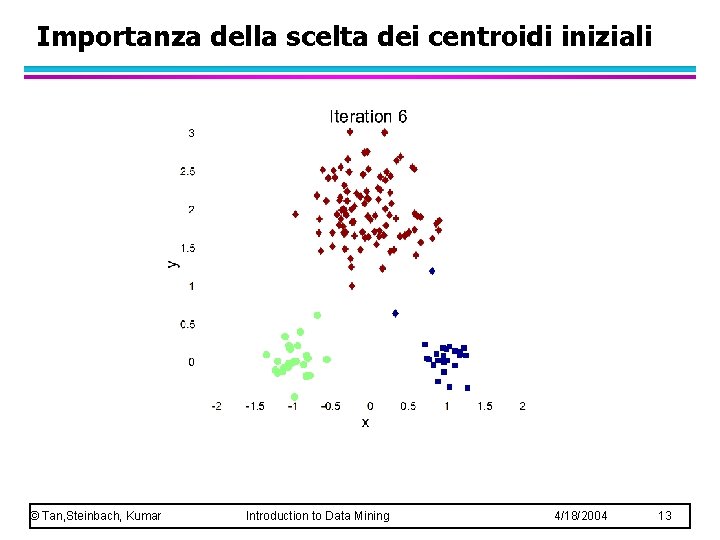
Importanza della scelta dei centroidi iniziali © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 13
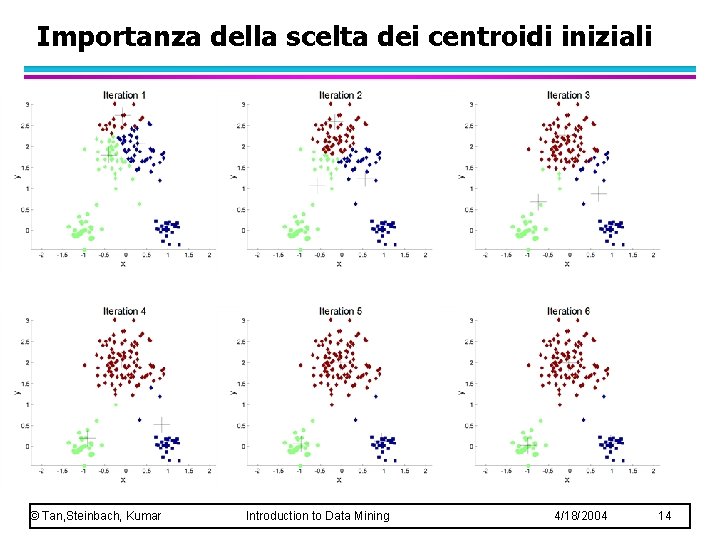
Importanza della scelta dei centroidi iniziali © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 14
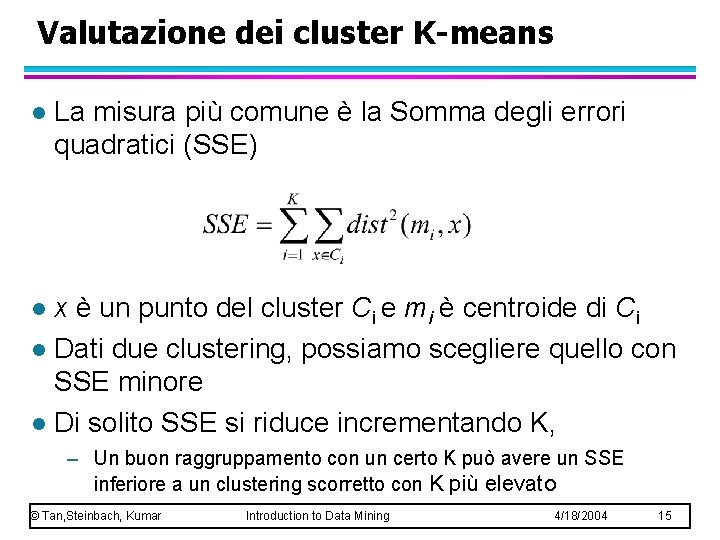
Valutazione dei cluster K-means l La misura più comune è la Somma degli errori quadratici (SSE) x è un punto del cluster Ci e mi è centroide di Ci l Dati due clustering, possiamo scegliere quello con SSE minore l Di solito SSE si riduce incrementando K, l – Un buon raggruppamento con un certo K può avere un SSE inferiore a un clustering scorretto con K più elevato © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 15
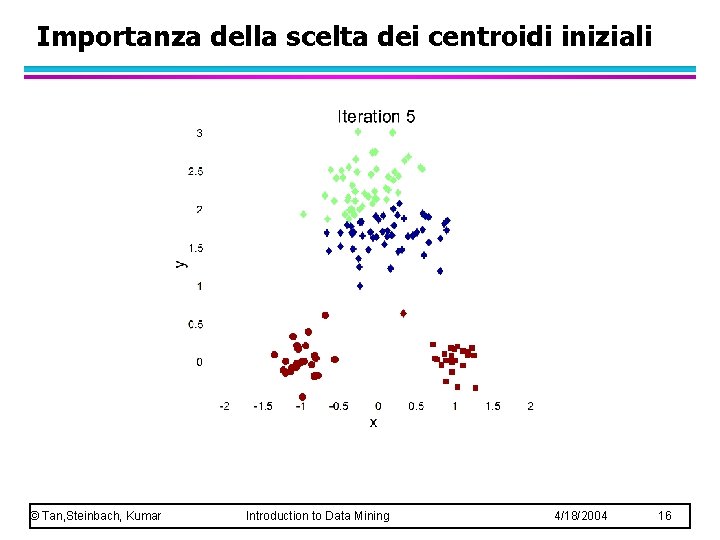
Importanza della scelta dei centroidi iniziali © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 16
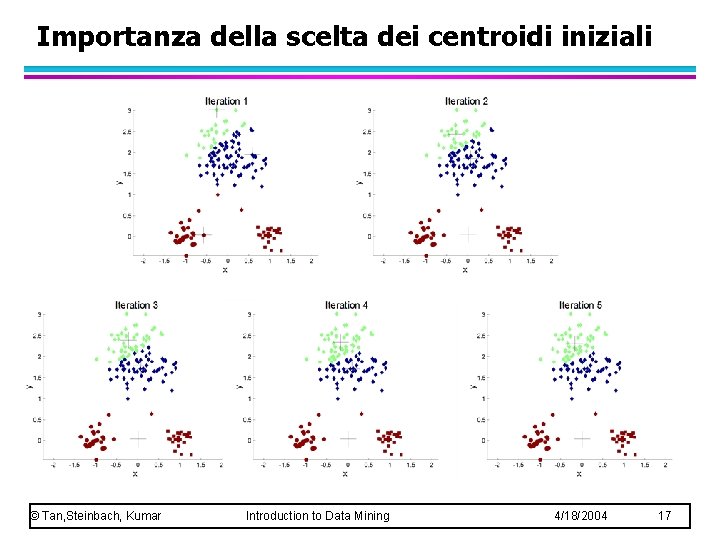
Importanza della scelta dei centroidi iniziali © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 17
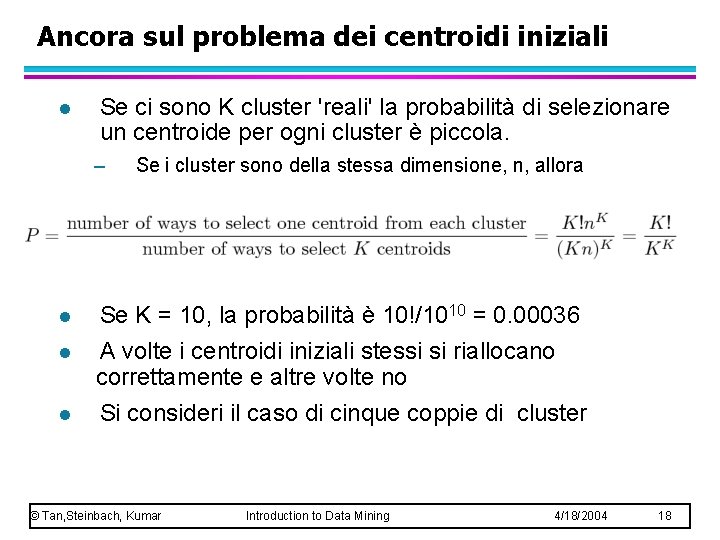
Ancora sul problema dei centroidi iniziali l Se ci sono K cluster 'reali' la probabilità di selezionare un centroide per ogni cluster è piccola. – l l l Se i cluster sono della stessa dimensione, n, allora Se K = 10, la probabilità è 10!/1010 = 0. 00036 A volte i centroidi iniziali stessi si riallocano correttamente e altre volte no Si consideri il caso di cinque coppie di cluster © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 18
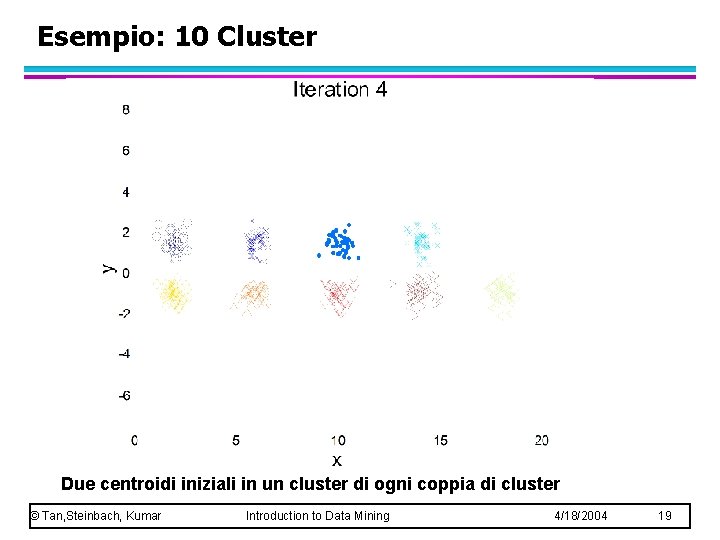
Esempio: 10 Cluster Due centroidi iniziali in un cluster di ogni coppia di cluster © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 19
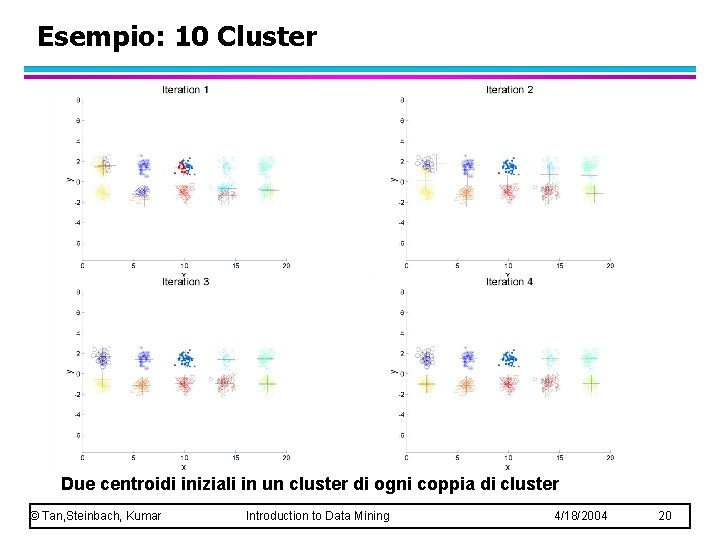
Esempio: 10 Cluster Due centroidi iniziali in un cluster di ogni coppia di cluster © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 20
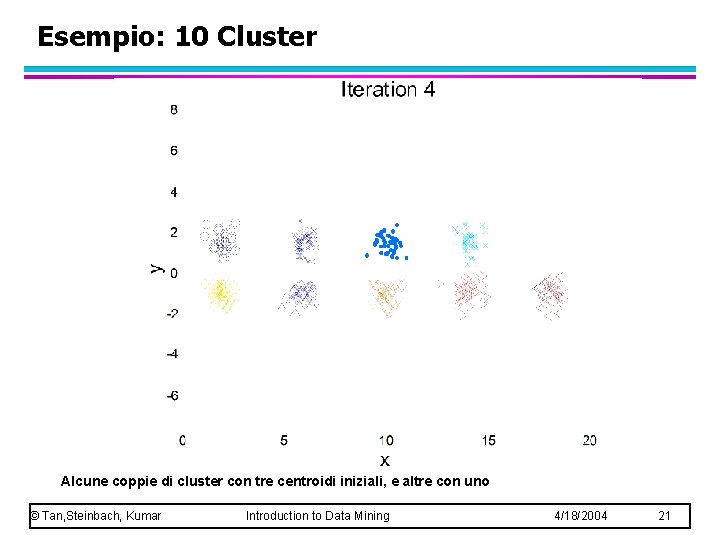
Esempio: 10 Cluster Alcune coppie di cluster con tre centroidi iniziali, e altre con uno © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 21
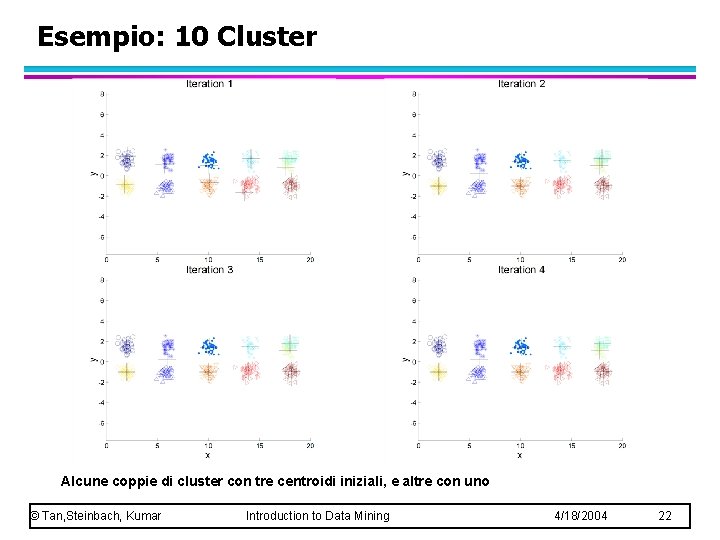
Esempio: 10 Cluster Alcune coppie di cluster con tre centroidi iniziali, e altre con uno © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 22
Alcune Soluzioni Seleziona più insiemi iniziali l Si usi il clustering gerarchico per determinare i centroidi iniziali l Selezionare più di K centroidi iniziali e quindi selezionare tra questi centroidi iniziali l – Selezionare quelli più separati Postprocessing l Bisecting K-means l – Non così sensibile alla scelta iniziale © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 23
Bisecting K-means l Variante di K-means che può produrre un clustering partizionale o gerarchico l Algoritmo: – – Si inizi con un cluster che contiene tutte le unità Bisezionare il cluster usando k-means Dei due cluster formati, bisezionare quello con SSE più elevato Procedere fino ad ottenere K cluster © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 24
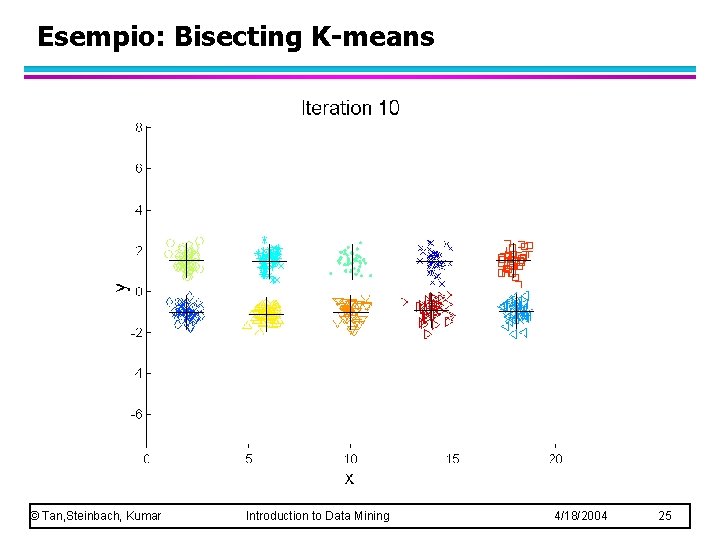
Esempio: Bisecting K-means © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 25
Limitazioni di K-means l K-Means ha problemi quando i cluster sono di differenti: – dimensioni – densità – forme non globulari l K-means ha problemi quando i dati contengono outlier. © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 26
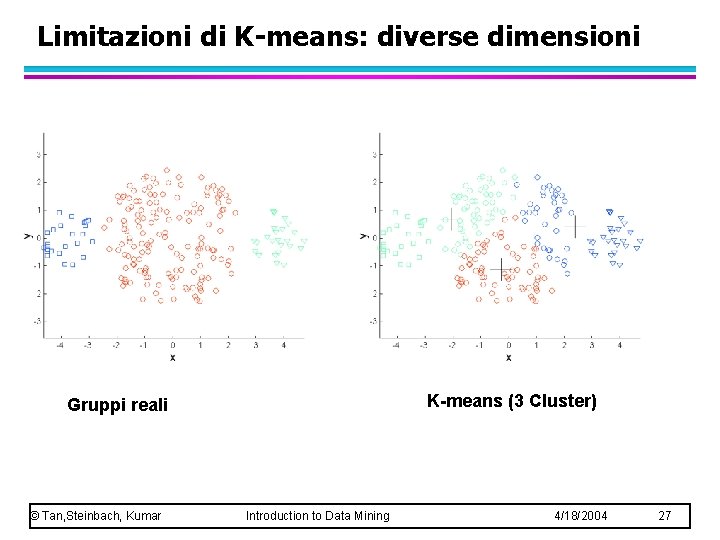
Limitazioni di K-means: diverse dimensioni K-means (3 Cluster) Gruppi reali © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 27
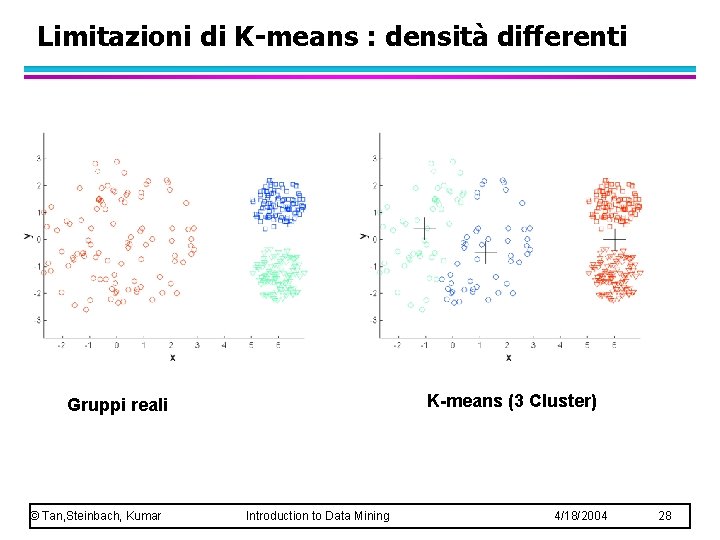
Limitazioni di K-means : densità differenti K-means (3 Cluster) Gruppi reali © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 28
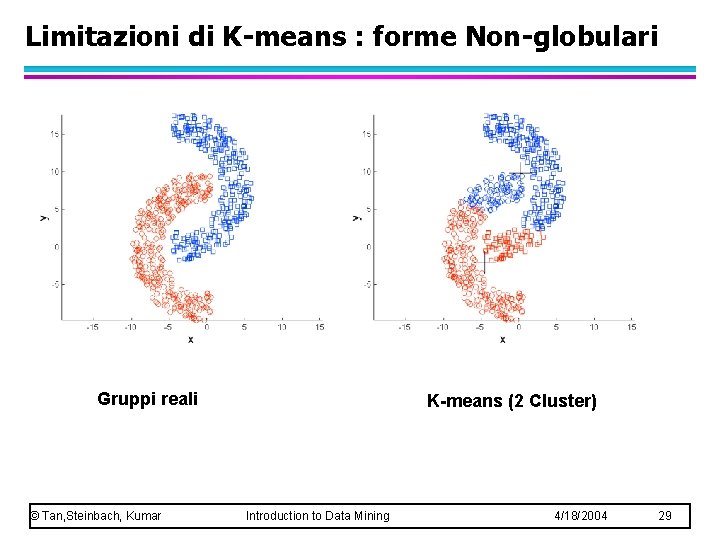
Limitazioni di K-means : forme Non-globulari Gruppi reali © Tan, Steinbach, Kumar K-means (2 Cluster) Introduction to Data Mining 4/18/2004 29
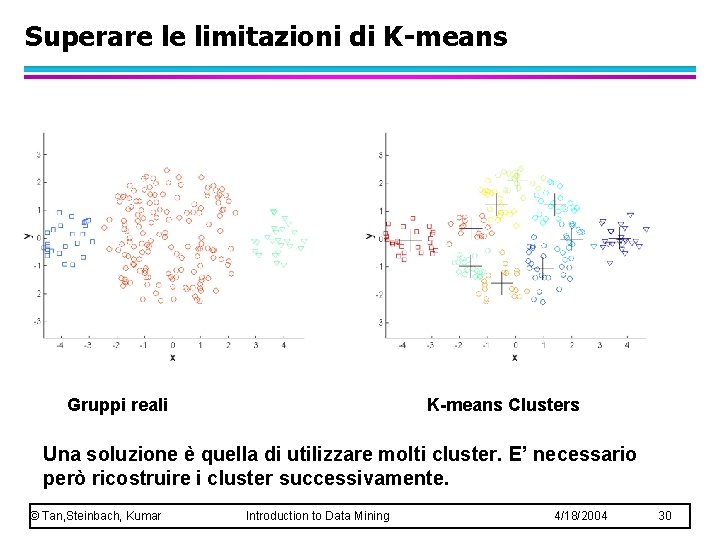
Superare le limitazioni di K-means Gruppi reali K-means Clusters Una soluzione è quella di utilizzare molti cluster. E’ necessario però ricostruire i cluster successivamente. © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 30
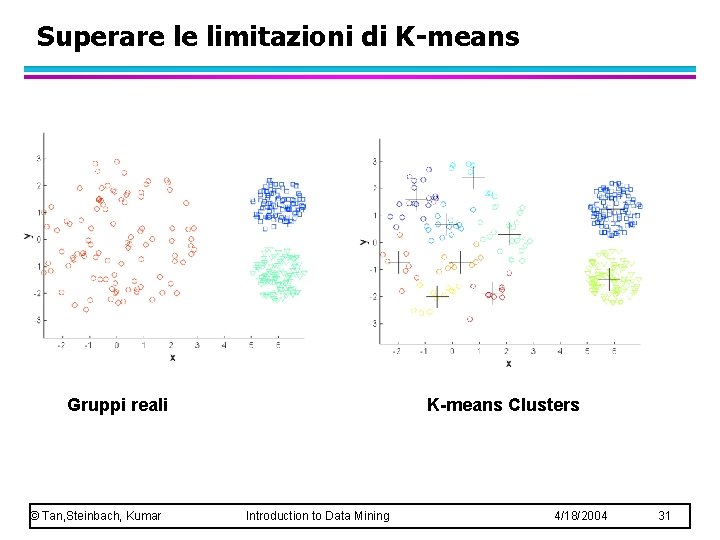
Superare le limitazioni di K-means Gruppi reali © Tan, Steinbach, Kumar K-means Clusters Introduction to Data Mining 4/18/2004 31
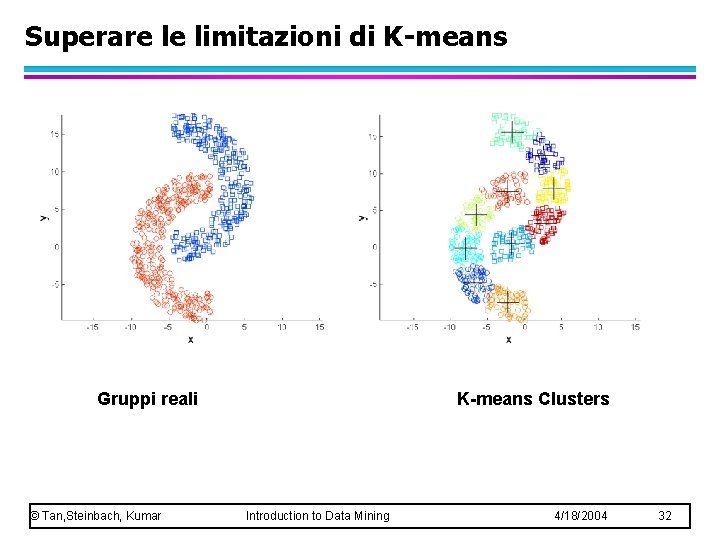
Superare le limitazioni di K-means Gruppi reali © Tan, Steinbach, Kumar K-means Clusters Introduction to Data Mining 4/18/2004 32
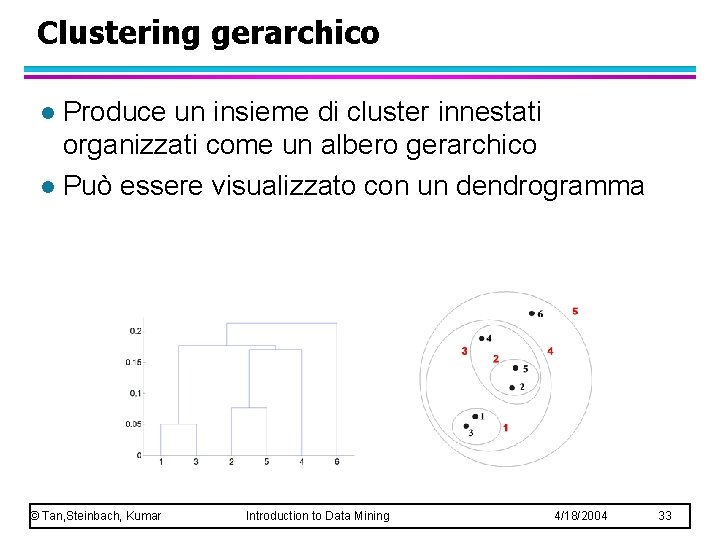
Clustering gerarchico Produce un insieme di cluster innestati organizzati come un albero gerarchico l Può essere visualizzato con un dendrogramma l © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 33
Vantaggi del Clustering gerarchico l Non è necessario assumere un numero fissato di cluster: – Qualsiasi numero desiderato di cluster può essere ottenuto con un 'taglio' del dendogramma al livello appropriato l Possono corrispondere a tassonomie – Specie animali, classificazioni di imprese © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 34
Clustering gerarchico l l Due tipi principali di clustering gerarchico Agglomerativo: u Inizia con i punti come singoli cluster u Ad ogni passo, unisce la coppia più vicina di cluster fino a quando rimane un solo cluster (o k cluster) l Divisivo: u Inizia con un cluster, (contiene tutti i punti) u Ad ogni passo, divide un gruppo fino a quando ogni cluster contiene un solo punto (o ci sono k cluster) l l Gli algoritmi gerarchici tradizionali utilizzano una matrice di similarità o di dissimilarità (distanza) Si unisce o si divide un gruppo alla volta © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 35
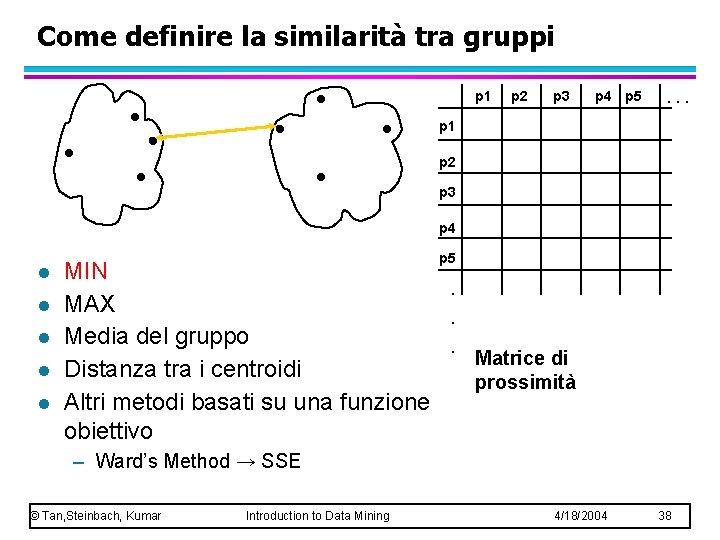
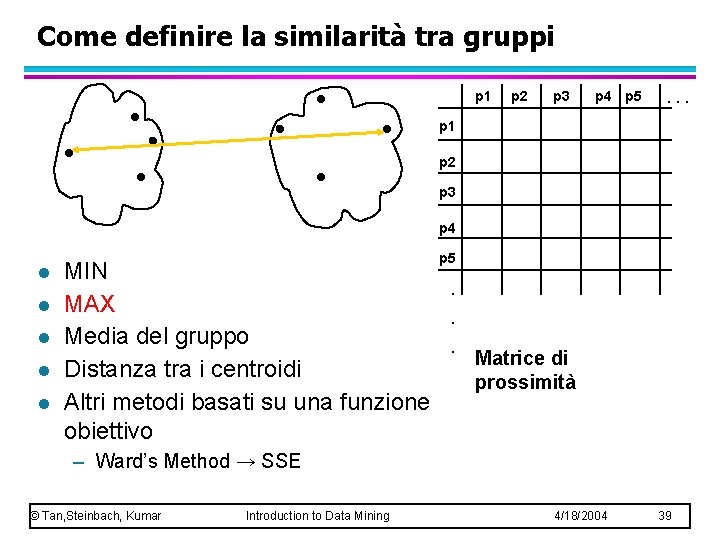
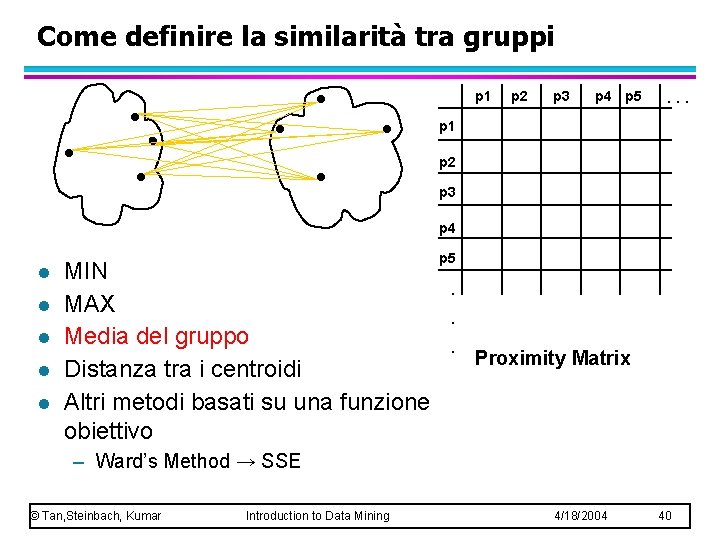
Algoritmo Agglomerativo l La tecnica di clustering gerarchico più diffusa l Algoritmo di base 1. 2. 3. 4. 5. 6. Calcola una matrice di prossimità (similarità o dissimilarità) Ogni punto è un cluster Ripeti Unisci i due cluster più vicini Aggiornal la matrice di prossimità Fino a quando rimane un solo cluster. l Punto chiave: la matrice di prossimità. – Approcci differenti nella definizione di prossimità portano a soluzioni differenti © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 36
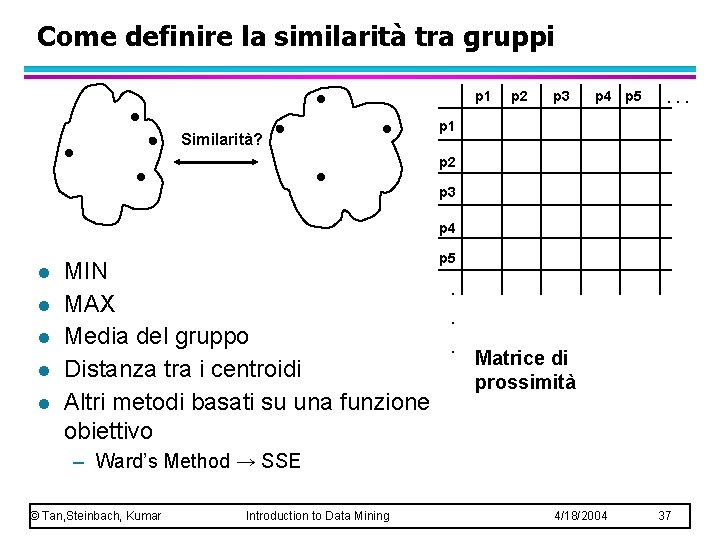
Come definire la similarità tra gruppi p 1 Similarità? p 2 p 3 p 4 p 5 . . . p 1 p 2 p 3 p 4 l l l MIN MAX Media del gruppo Distanza tra i centroidi Altri metodi basati su una funzione obiettivo p 5 . . . Matrice di prossimità – Ward’s Method → SSE © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 37
Come definire la similarità tra gruppi p 1 p 2 p 3 p 4 p 5 . . . p 1 p 2 p 3 p 4 l l l MIN MAX Media del gruppo Distanza tra i centroidi Altri metodi basati su una funzione obiettivo p 5 . . . Matrice di prossimità – Ward’s Method → SSE © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 38
Come definire la similarità tra gruppi p 1 p 2 p 3 p 4 p 5 . . . p 1 p 2 p 3 p 4 l l l MIN MAX Media del gruppo Distanza tra i centroidi Altri metodi basati su una funzione obiettivo p 5 . . . Matrice di prossimità – Ward’s Method → SSE © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 39
Come definire la similarità tra gruppi p 1 p 2 p 3 p 4 p 5 . . . p 1 p 2 p 3 p 4 l l l MIN MAX Media del gruppo Distanza tra i centroidi Altri metodi basati su una funzione obiettivo p 5 . . . Proximity Matrix – Ward’s Method → SSE © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 40
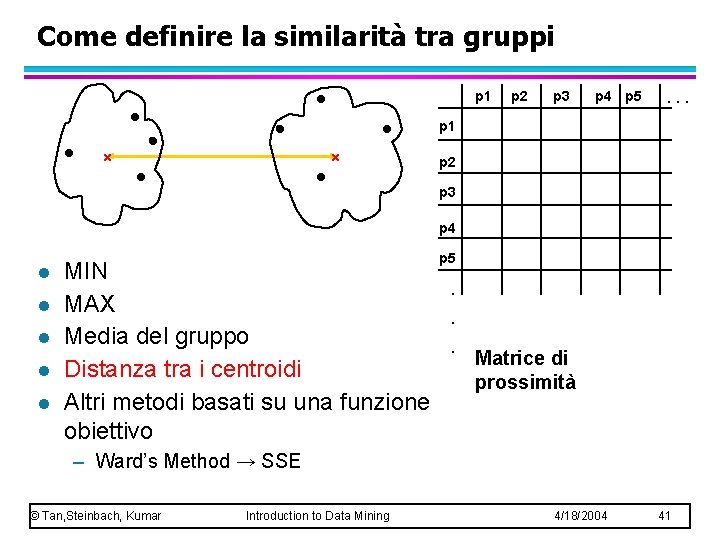
Come definire la similarità tra gruppi p 1 p 2 p 3 p 4 p 5 . . . p 1 p 2 p 3 p 4 l l l MIN MAX Media del gruppo Distanza tra i centroidi Altri metodi basati su una funzione obiettivo p 5 . . . Matrice di prossimità – Ward’s Method → SSE © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 41
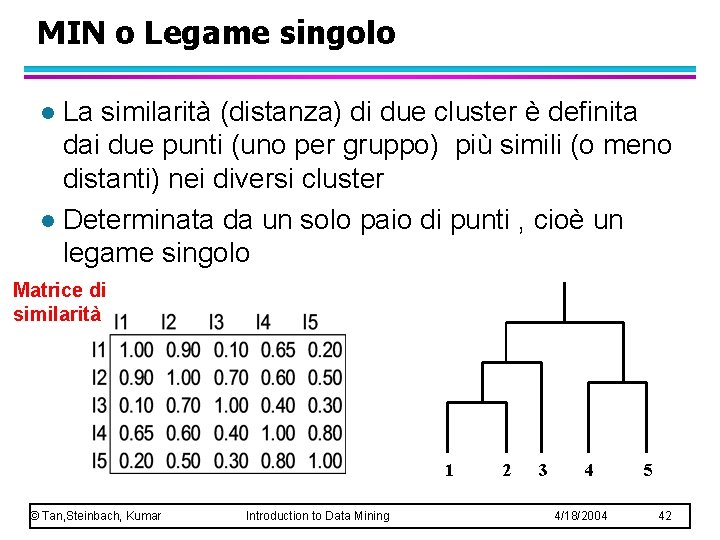
MIN o Legame singolo La similarità (distanza) di due cluster è definita dai due punti (uno per gruppo) più simili (o meno distanti) nei diversi cluster l Determinata da un solo paio di punti , cioè un legame singolo l Matrice di similarità 1 © Tan, Steinbach, Kumar Introduction to Data Mining 2 3 4 5 4/18/2004 42
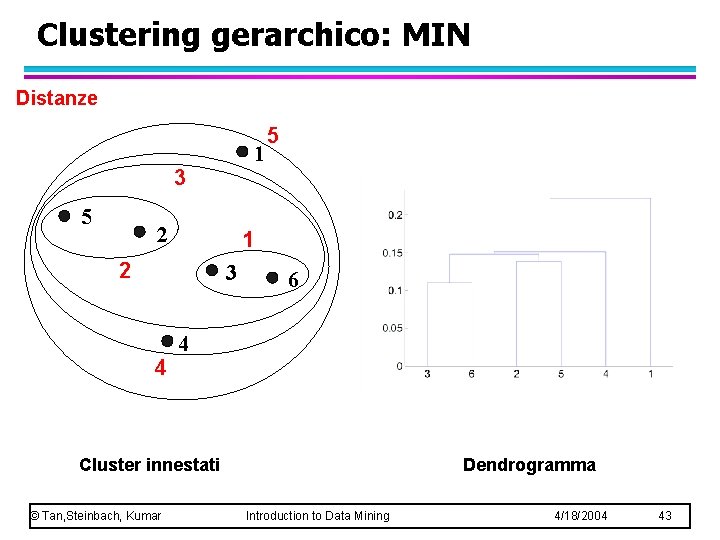
Clustering gerarchico: MIN Distanze 1 3 5 2 1 2 3 4 5 6 4 Cluster innestati © Tan, Steinbach, Kumar Dendrogramma Introduction to Data Mining 4/18/2004 43
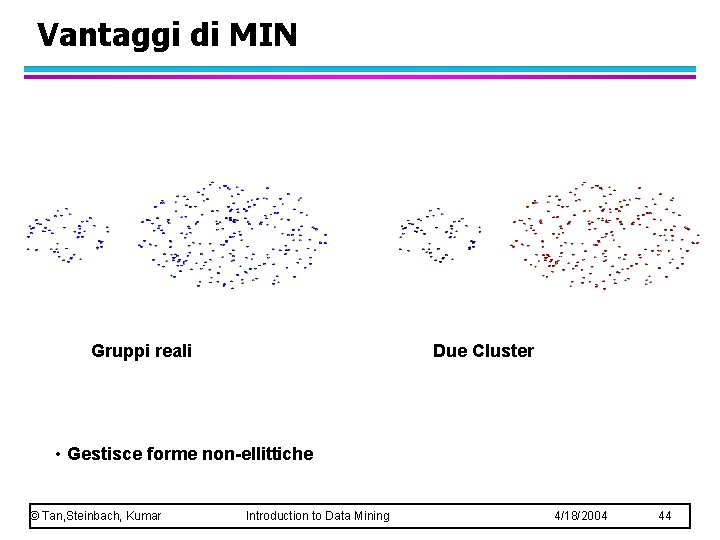
Vantaggi di MIN Gruppi reali Due Cluster • Gestisce forme non-ellittiche © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 44
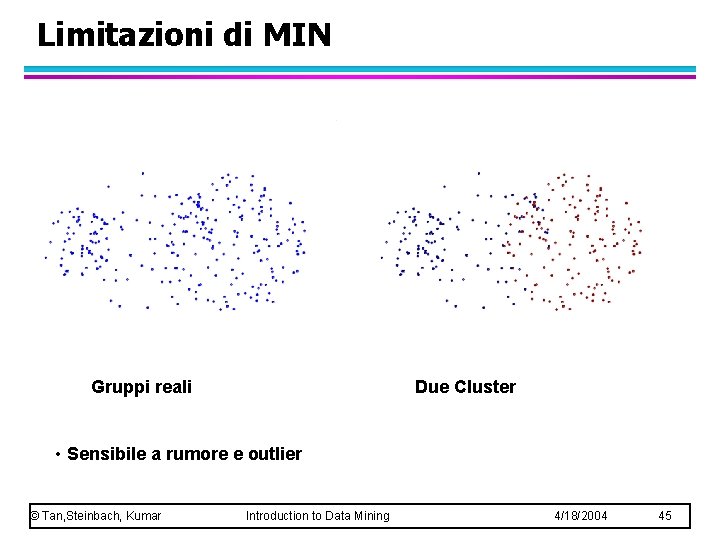
Limitazioni di MIN Gruppi reali Due Cluster • Sensibile a rumore e outlier © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 45
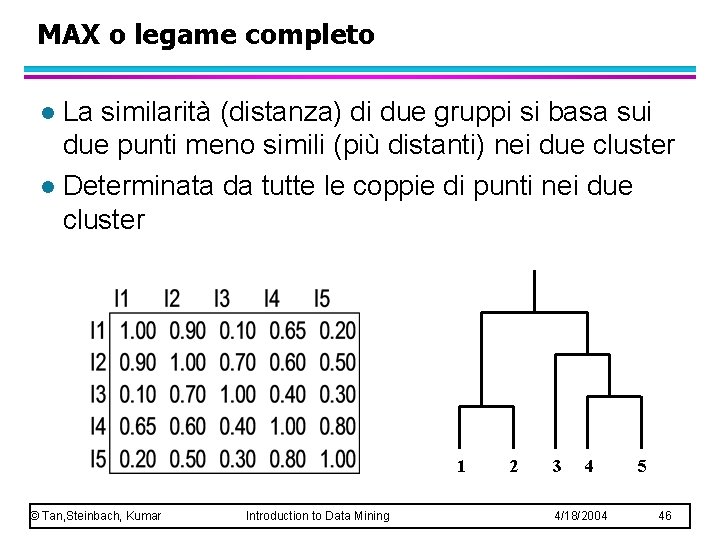
MAX o legame completo La similarità (distanza) di due gruppi si basa sui due punti meno simili (più distanti) nei due cluster l Determinata da tutte le coppie di punti nei due cluster l 1 © Tan, Steinbach, Kumar Introduction to Data Mining 2 3 4 5 4/18/2004 46
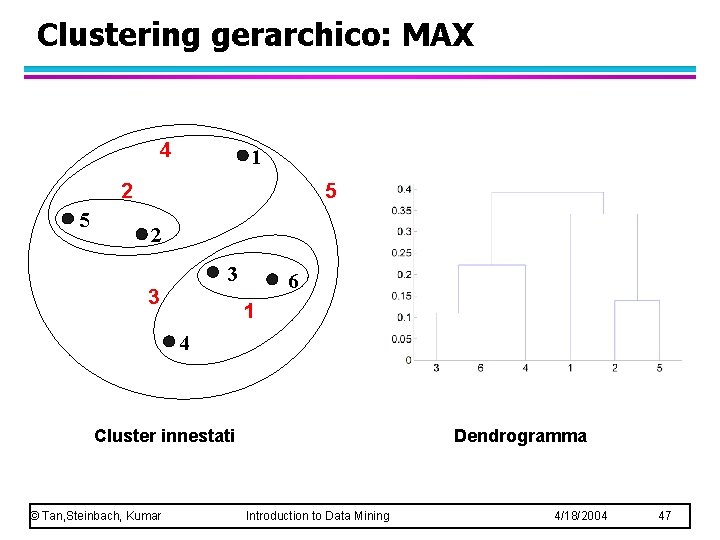
Clustering gerarchico: MAX 4 1 5 2 3 3 6 1 4 Cluster innestati © Tan, Steinbach, Kumar Dendrogramma Introduction to Data Mining 4/18/2004 47
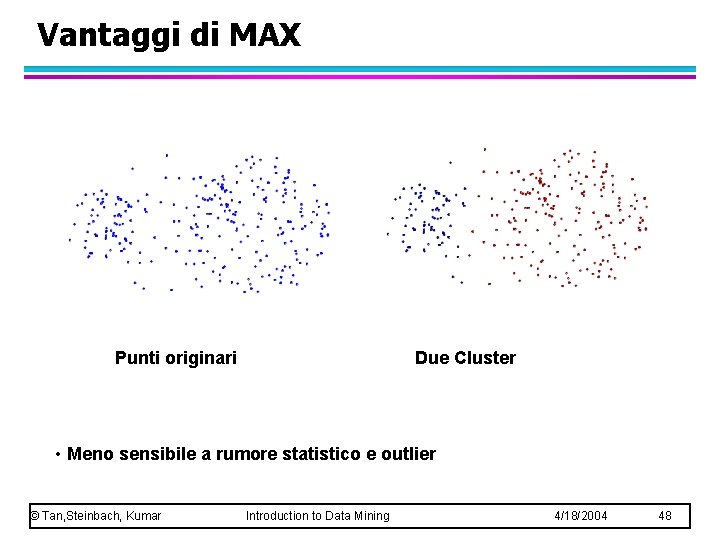
Vantaggi di MAX Punti originari Due Cluster • Meno sensibile a rumore statistico e outlier © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 48
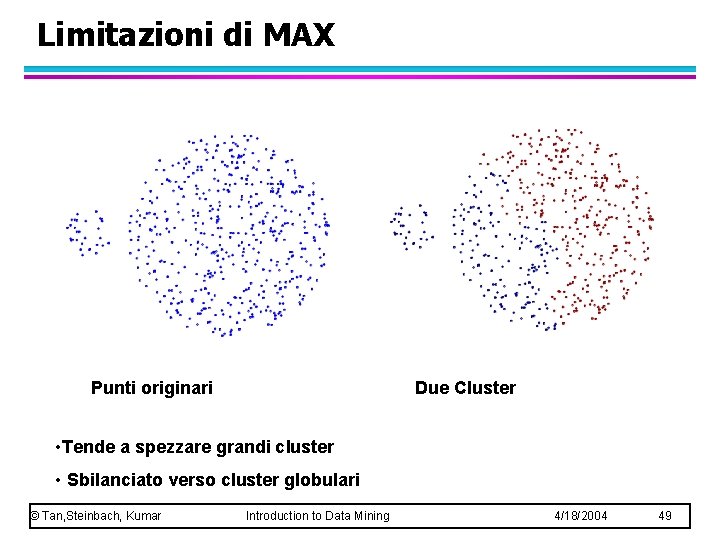
Limitazioni di MAX Due Cluster Punti originari • Tende a spezzare grandi cluster • Sbilanciato verso cluster globulari © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 49
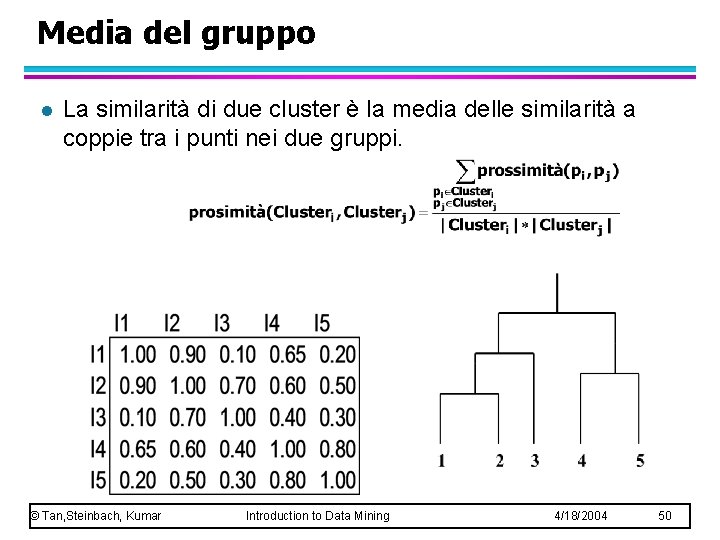
Media del gruppo l La similarità di due cluster è la media delle similarità a coppie tra i punti nei due gruppi. © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 50
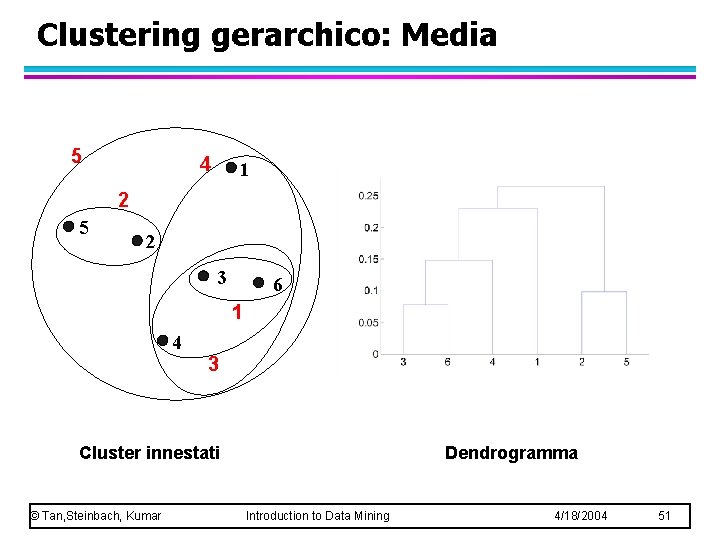
Clustering gerarchico: Media 5 4 1 2 5 2 3 6 1 4 3 Cluster innestati © Tan, Steinbach, Kumar Dendrogramma Introduction to Data Mining 4/18/2004 51
Clustering gerarchico : Media l Compromesso tra legame singolo e legame completo l Punto di forza – Meno sensibile a rumore e outliers l Limitazioni – Sbilanciato verso cluster globulari © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 52
Metodo di Ward l La similarità di due gruppi si basa sull’incremento di SSE quando i due gruppi vengono uniti: tanto minore l’incremento tanto più elevata la similarità l Simile al criterio della media se la distanza tra punti è la distanza Euclidea al quadrato. l Meno sensibile a rumore e outliers e sbilanciato verso cluster globulari l Analogo gerarchico di K-means – Può essere usato per scegliere I centroidi in K-means © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 53
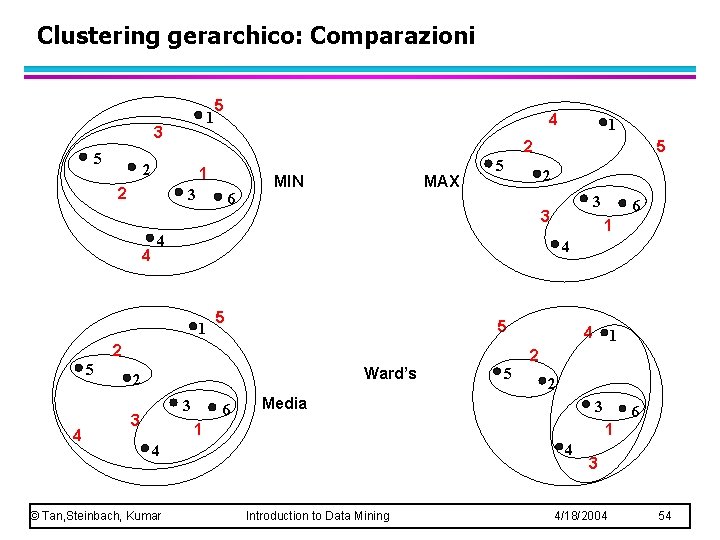
Clustering gerarchico: Comparazioni 1 3 5 5 1 2 3 6 MIN MAX 5 2 6 1 4 5 5 Ward’s 2 3 3 2 4 5 4 1 5 1 2 2 4 4 6 4 1 2 5 2 Media 3 1 1 4 4 © Tan, Steinbach, Kumar 6 Introduction to Data Mining 3 4/18/2004 54
Clustering gerarchico: Problemi e limitazioni l Una volta presa la decisione di combinare due cluster , non può essere annullata l Nessuna funzione obiettivo è minimizzata l Schemi differenti hanno problemi di vario tipo: – Sensibili a rumore statistico e outlier – Difficoltà nel gestire cluster di dimensioni differenti e forme convesse – Spezzano grandi cluster © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 55
DBSCAN l DBSCAN : density-based algorithm. – Densità = numero di punti entro un raggio specificato (Eps) – Un punto è definito core point se ha più di un numero specificato di punti (Min. Pts) entro Eps u Punti all’interno del cluster – Un border point ha meno punti di Min. Pts entro Eps, ma è nel vicinato di un core point – Un noise point è ogni altro punto che non è né core point o border point. © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 56
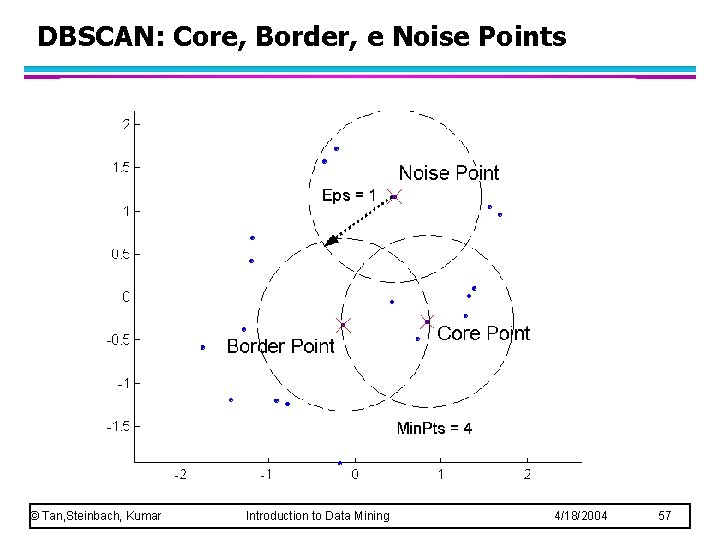
DBSCAN: Core, Border, e Noise Points © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 57
Algoritmo DBSCAN l Elimina i noise points l Aggrega in cluster i punti rimanenti – Gruppi formati da core point e border point collegati tra loro © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 58
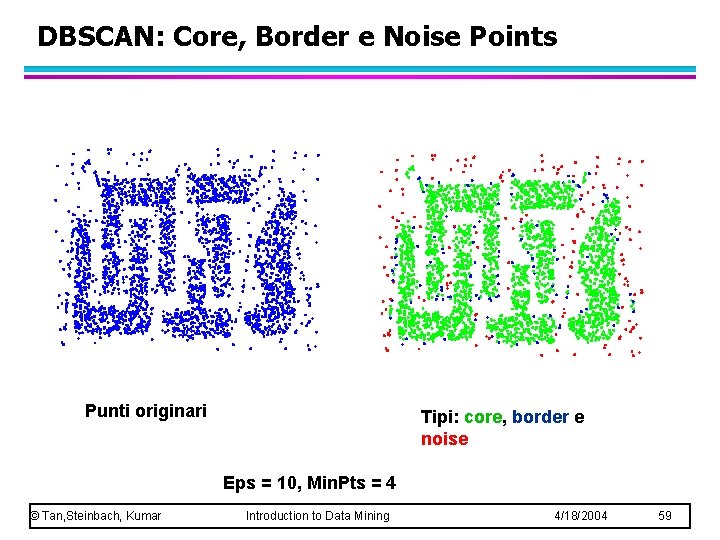
DBSCAN: Core, Border e Noise Points Punti originari Tipi: core, border e noise Eps = 10, Min. Pts = 4 © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 59
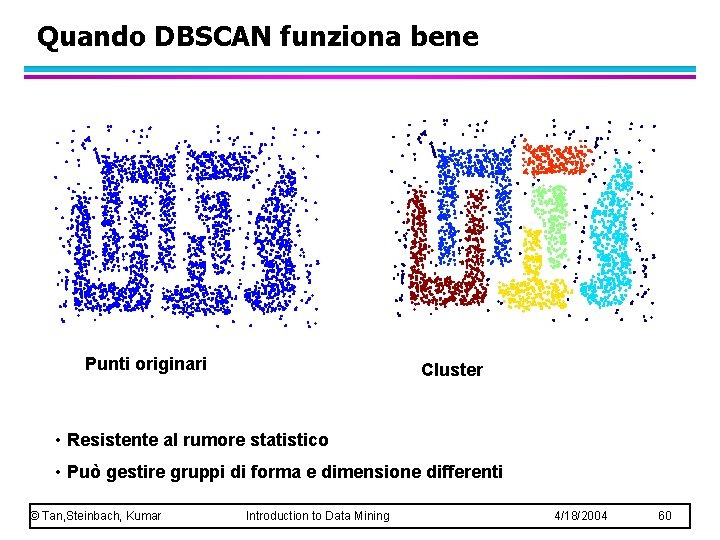
Quando DBSCAN funziona bene Punti originari Cluster • Resistente al rumore statistico • Può gestire gruppi di forma e dimensione differenti © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 60
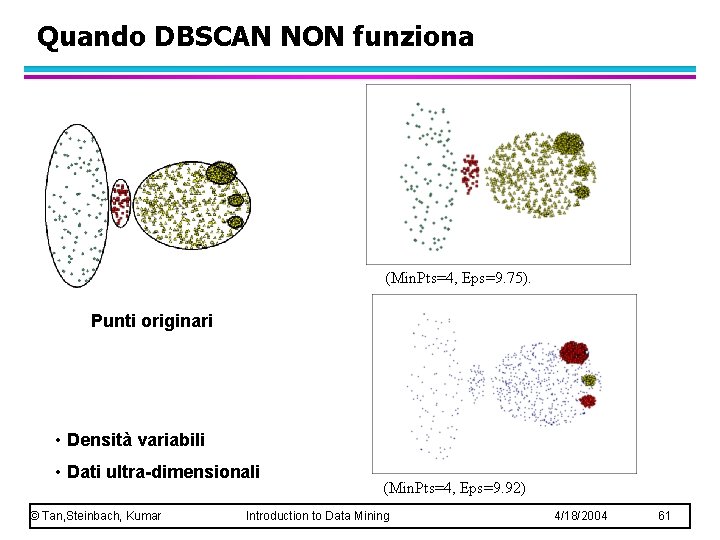
Quando DBSCAN NON funziona (Min. Pts=4, Eps=9. 75). Punti originari • Densità variabili • Dati ultra-dimensionali © Tan, Steinbach, Kumar (Min. Pts=4, Eps=9. 92) Introduction to Data Mining 4/18/2004 61
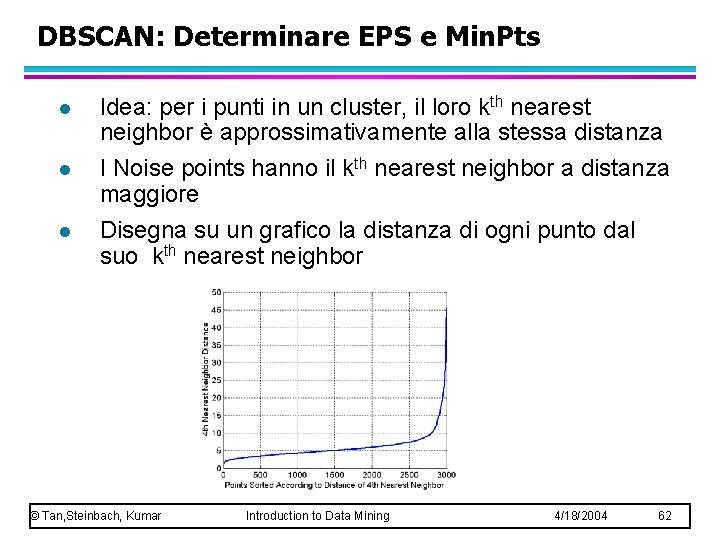
DBSCAN: Determinare EPS e Min. Pts l l l Idea: per i punti in un cluster, il loro kth nearest neighbor è approssimativamente alla stessa distanza I Noise points hanno il kth nearest neighbor a distanza maggiore Disegna su un grafico la distanza di ogni punto dal suo kth nearest neighbor © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 62
Validazione dei cluster l Evitare di trovare pattern in dati casuali l Compare algoritmi di clustering l Comparare i cluster © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 63
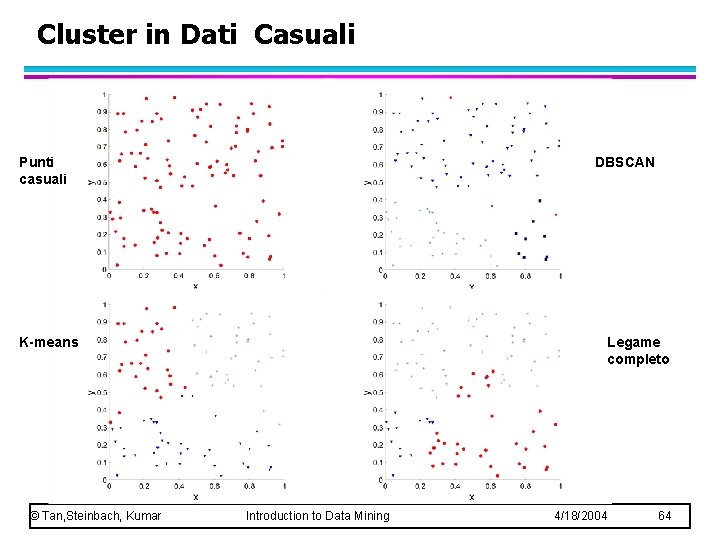
Cluster in Dati Casuali Punti casuali DBSCAN Legame completo K-means © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 64
Misure di validità dei Cluster l Le misure numeriche usate per valutare la bontà di un clustering, sono classificate in tre tipi: – Indici esterni: Usato per misurare fino a che punto le etichette del cluster corrispondono a quelle fornite da una fonte esterna. u Entropia – Indici interni: Usati per misurare la bontà di un clustering senza riferimento a informazione esterna. u Sum of Squared Error (SSE) – Indici relativi: Usati per comparare due clustering or cluster. u l Spesso un indice interno o esterno è usato in questi casi: SSE o entropia A volte si parla di criteri piuttosto che di indici © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 65
1. Misurare la validità con la correlazione l l Due matrici – Matrice di prossimità – Matrice di incidenza l Un riga e una colonna per ogni punto (n x n) u La cella della matrice è 1 se I punti associati sono nello stesso cluster. E’ nulla altrimenti Calcola la correlazione tra le celle corrispondenti delle due matrici – l u Poichè le matrici sono simmetriche, solo n(n-1) / 2 celle sono considerate. Alta correlazione indica che i punti che appartengono allo stesso cluster sono vicini tra loro. Non è una misura che funziona bene nel caso di cluster a densità differente o definito dalla contiguità. © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 66
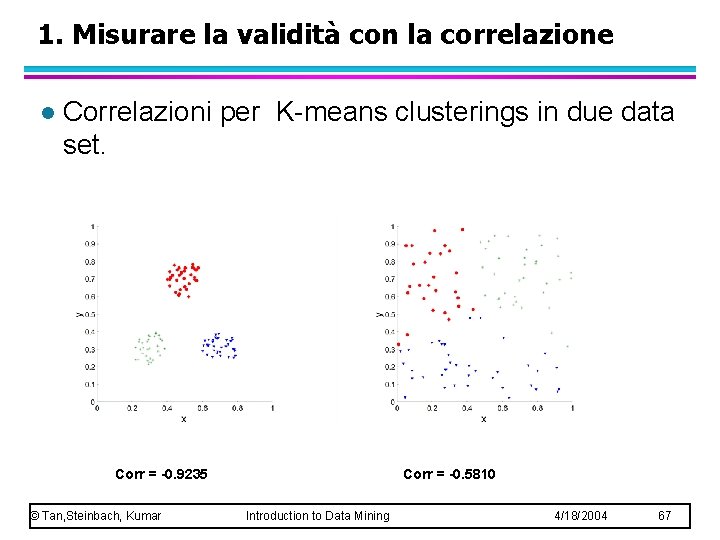
1. Misurare la validità con la correlazione l Correlazioni per K-means clusterings in due data set. Corr = -0. 9235 © Tan, Steinbach, Kumar Corr = -0. 5810 Introduction to Data Mining 4/18/2004 67
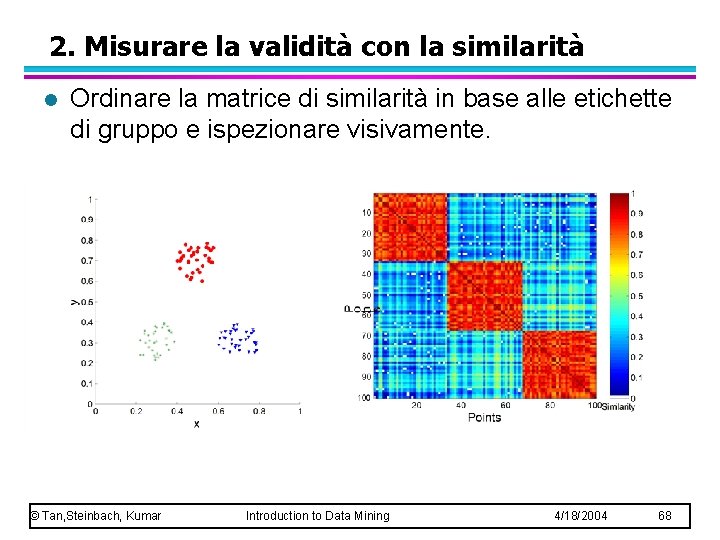
2. Misurare la validità con la similarità l Ordinare la matrice di similarità in base alle etichette di gruppo e ispezionare visivamente. © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 68
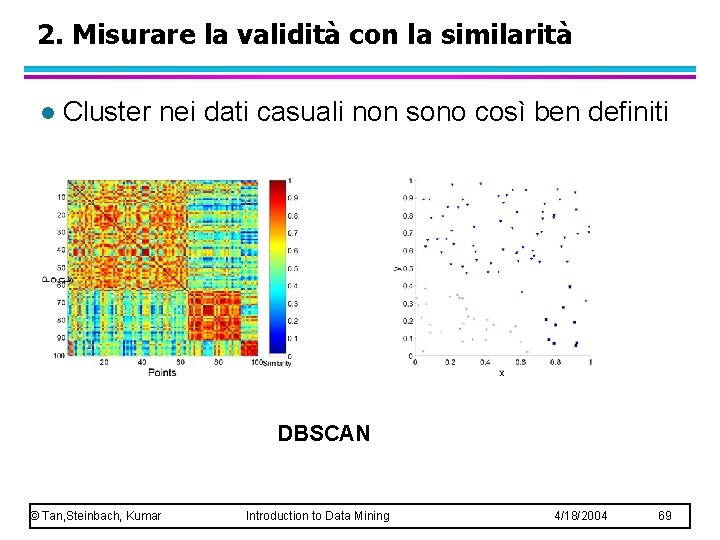
2. Misurare la validità con la similarità l Cluster nei dati casuali non sono così ben definiti DBSCAN © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 69
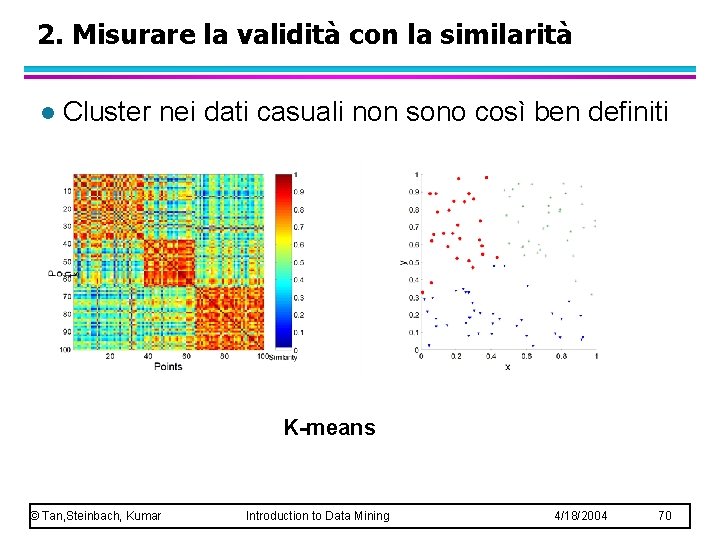
2. Misurare la validità con la similarità l Cluster nei dati casuali non sono così ben definiti K-means © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 70
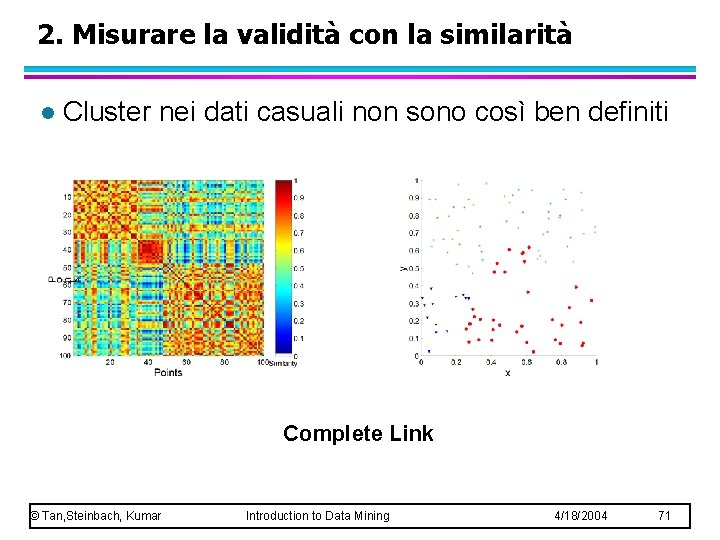
2. Misurare la validità con la similarità l Cluster nei dati casuali non sono così ben definiti Complete Link © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 71
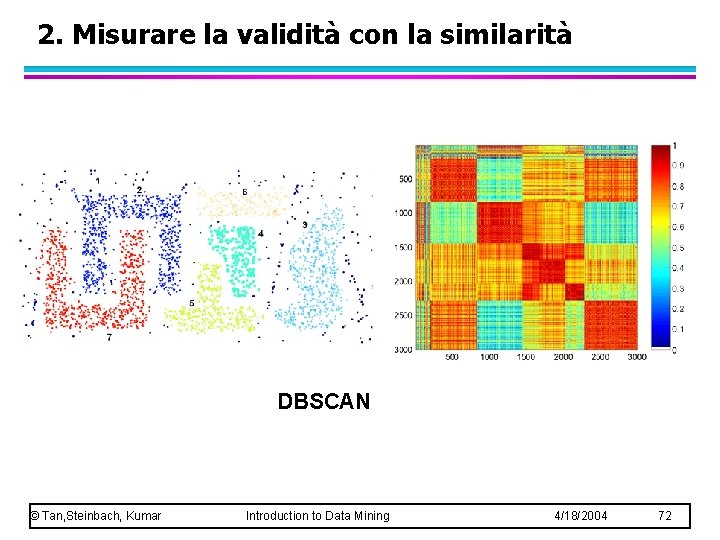
2. Misurare la validità con la similarità DBSCAN © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 72
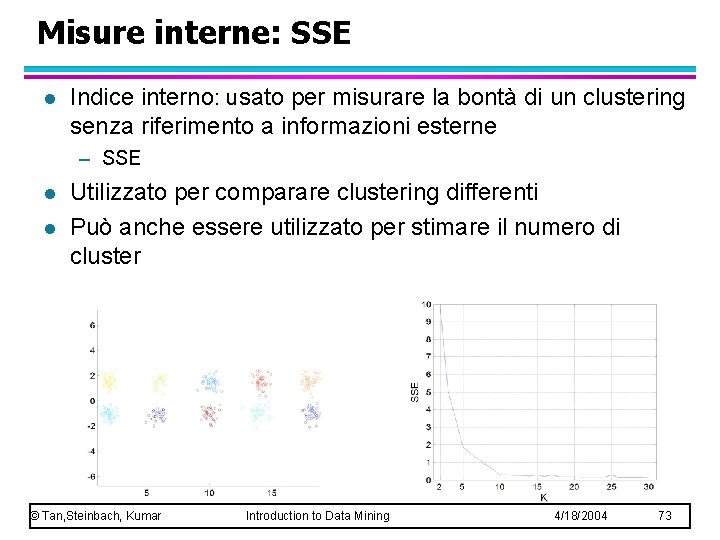
Misure interne: SSE l Indice interno: usato per misurare la bontà di un clustering senza riferimento a informazioni esterne – SSE l l Utilizzato per comparare clustering differenti Può anche essere utilizzato per stimare il numero di cluster © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 73
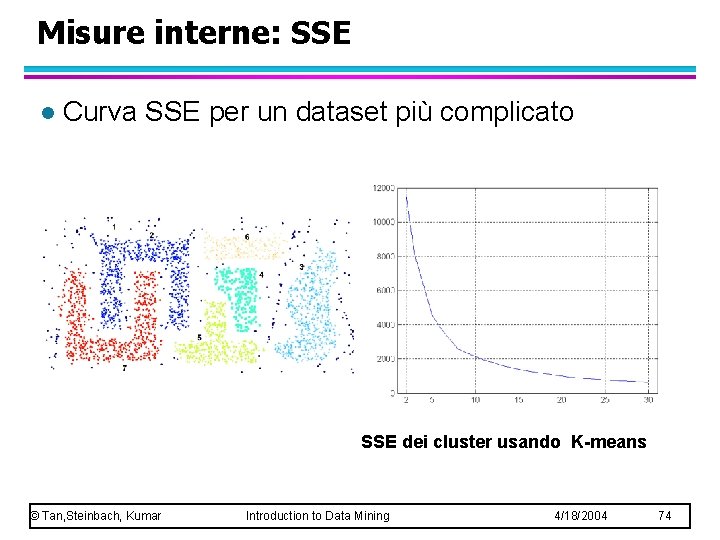
Misure interne: SSE l Curva SSE per un dataset più complicato SSE dei cluster usando K-means © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 74
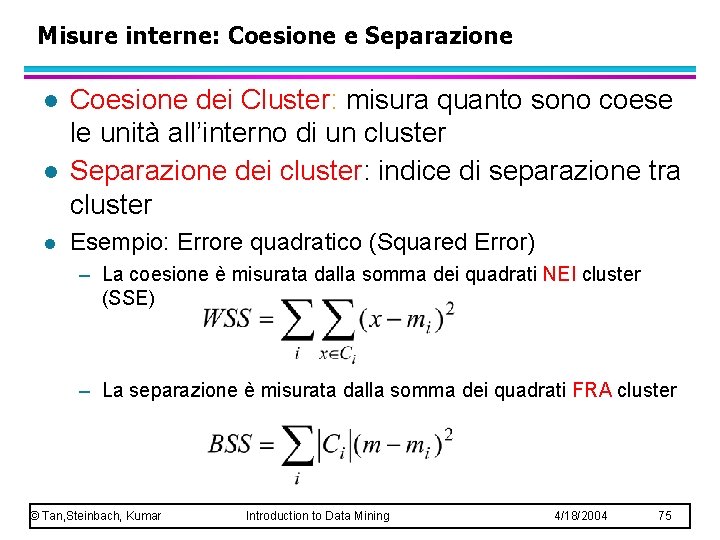
Misure interne: Coesione e Separazione l l l Coesione dei Cluster: misura quanto sono coese le unità all’interno di un cluster Separazione dei cluster: indice di separazione tra cluster Esempio: Errore quadratico (Squared Error) – La coesione è misurata dalla somma dei quadrati NEI cluster (SSE) – La separazione è misurata dalla somma dei quadrati FRA cluster © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 75
“The validation of clustering structures is the most difficult and frustrating part of cluster analysis. Without a strong effort in this direction, cluster analysis will remain a black art accessible only to those true believers who have experience and great courage. ” Algorithms for Clustering Data, Jain and Dubes © Tan, Steinbach, Kumar Introduction to Data Mining 4/18/2004 76
- Slides: 76