
Calcolo delle Probabilita e Statistica Metodi Statistici per
Calcolo delle Probabilita’ e Statistica Metodi Statistici per l’Ingegneria A. A. 2013 -14 Recapiti del docente: • @ nntmdl@unife. it • Tel 0532 – 97 4994 Mailing List: scrivetemi per essere inclusi nella mailing list del corso, in modo da ricevere informazioni e aggiornamenti su eventuali cambi di orario, etc. Orario di ricevimento • Martedi’ 17: 00 -18: 00 e su prenotazione alle 18: 50 c/o Dipartimento di Ingegneria (Blocco A) piano 3 stanza 313 durante il periodo didattico. Si prega cmq di prenotarsi per mail almeno il giorno prima. Ricevimento su appuntamento nel resto dell’anno. Libro di testo • Sheldon Ross, Probabilita’ e Statistica per Ingegneria e le Scienze, 2 ed. , Apogeo Esame • Scritto • Orale (nella stessa sessione) – – opzionale per chi ha superato lo scritto con almeno 18, obbligatorio per chi ha tra 15 e 17. Oscillazione di voto [-3, +3] • Obbligo di iscrizione almeno 3 gg prima sul web • Testi dei compiti e TRACCE di soluzione sul minisito Programma del corso • Sul minisito dell’insegnamento Orario di lezione • http: //servizi. unife. it/orariolezioni/ • martedi’ 14: 15 -16: 30, venerdi’ 16: 30 -18: 45 • No lezione venerdi’ 18 Ottobre, Ottobre recupero in data da definire
Programma del corso (cap 1 -8) Statistica descrittiva, • Rappresentazione dei dati di un campione, mediana, moda, e varianza campionaria; percentili; boxplot. • disuguaglianza di Chebyshev su insiemi finiti; campioni normali; • insiemi bivariati; coefficiente di correlazione campionaria. Introduzione alla probabilità: • diagrammi di Venn e algebra degli eventi. • Richiami di calcolo combinatorio. • Assiomi della probabilità. Probabilità condizionale, formula di Bayes, eventi indipendenti. Variabili Aleatorie. – Variabili discrete: Bernoulli e Binomiale, Poissoniana, Ipergeometrica. – Variabili continue: Uniforme, Normale, Esponenziale, Gamma. – Variabili aleatorie inferenziali: Chi quadro, t(di student), F. • • • Valore atteso, def. e proprietà nel caso discreto e nel caso continuo. Valore atteso di somme di variabili aleatorie, valore atteso di funzioni di variabile aleatorie. Distribuzioni congiunte, marginali e condizionali. Variabili indipendenti. Varianza e covarianza di somme di variabili aleatorie. Funzione generatrice dei momenti. Disuguaglianza di Chebyshev per variabili aleatorie. Statistica inferenziale • popolazioni e campioni. Stimatori campionari, distribuzioni campionarie, media campionaria, varianza campionaria. • Teoria della Stima. Stime puntuali e per intervalli.
Statistica Descrittiva vs Inferenziale Descrittiva: Descrive in modo compatto l’insieme dei dati raccolti, attraverso l’utilizzo di indicatori sintetici. Inferenziale: A partire dall’analisi delle caratteristiche di un campione, cerca di inferire le caratteristiche della popolazione a cui il campione appartiene Per condurre correttamente l’analisi, occorre fare delle ipotesi sul modello probabilistico dei dati a cui e’ soggetto il nostro campione sperimentale. Per questo occorre avere le basi della teoria del calcolo delle probabilita’
La statistica Descrittiva • raccoglie dati, • li sintetizza • li interpreta Step 1: organizzare la raccolta dei dati • Step Fondamentale: la scelta del campione • Per essere rappresentativo, il campione deve essere scelto casualmente tra tutti i sottoinsiemi possibili di tale cardinalita’.
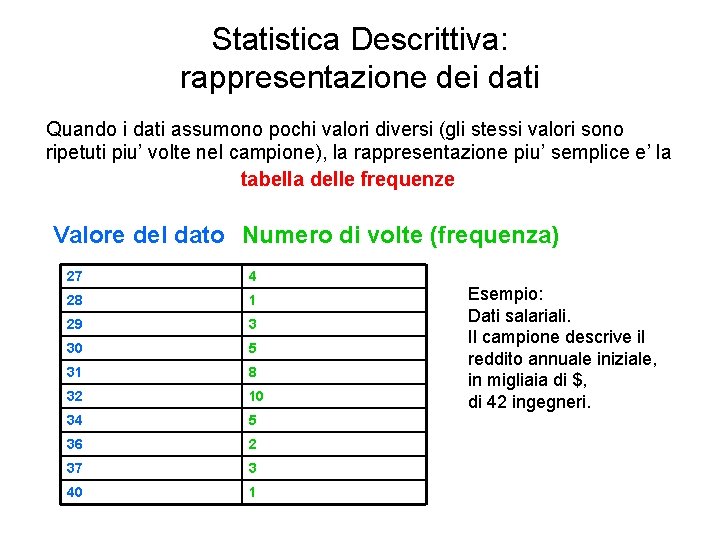
Statistica Descrittiva: rappresentazione dei dati Quando i dati assumono pochi valori diversi (gli stessi valori sono ripetuti piu’ volte nel campione), la rappresentazione piu’ semplice e’ la tabella delle frequenze Valore del dato Numero di volte (frequenza) 27 4 28 1 29 3 30 5 31 8 32 10 34 5 36 2 37 3 40 1 Esempio: Dati salariali. Il campione descrive il reddito annuale iniziale, in migliaia di $, di 42 ingegneri.
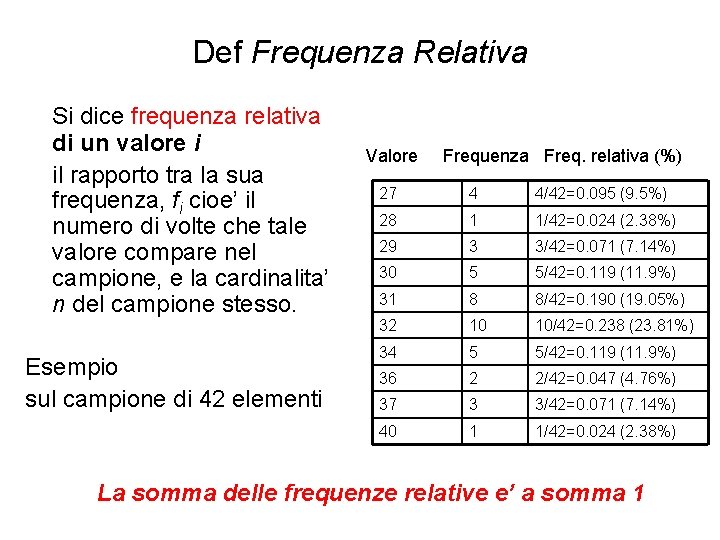
Def Frequenza Relativa Si dice frequenza relativa di un valore i il rapporto tra la sua frequenza, fi cioe’ il numero di volte che tale valore compare nel campione, e la cardinalita’ n del campione stesso. Esempio sul campione di 42 elementi Valore Frequenza Freq. relativa (%) 27 4 4/42=0. 095 (9. 5%) 28 1 1/42=0. 024 (2. 38%) 29 3 3/42=0. 071 (7. 14%) 30 5 5/42=0. 119 (11. 9%) 31 8 8/42=0. 190 (19. 05%) 32 10 10/42=0. 238 (23. 81%) 34 5 5/42=0. 119 (11. 9%) 36 2 2/42=0. 047 (4. 76%) 37 3 3/42=0. 071 (7. 14%) 40 1 1/42=0. 024 (2. 38%) La somma delle frequenze relative e’ a somma 1
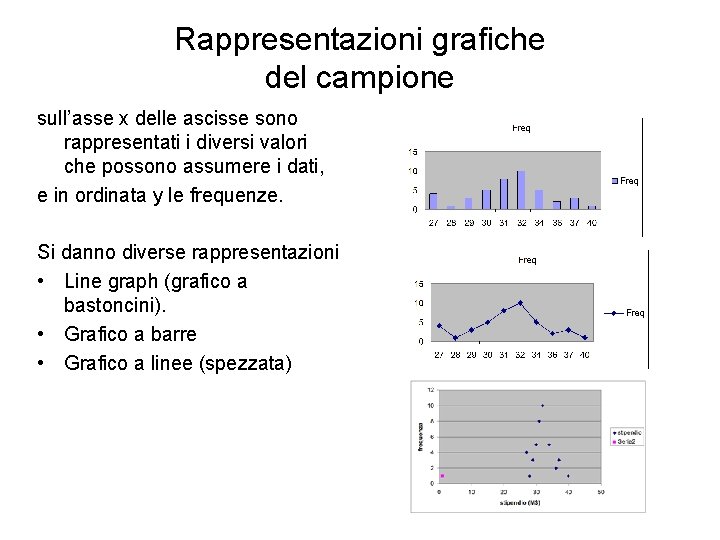
Rappresentazioni grafiche del campione sull’asse x delle ascisse sono rappresentati i diversi valori che possono assumere i dati, e in ordinata y le frequenze. Si danno diverse rappresentazioni • Line graph (grafico a bastoncini). • Grafico a barre • Grafico a linee (spezzata)
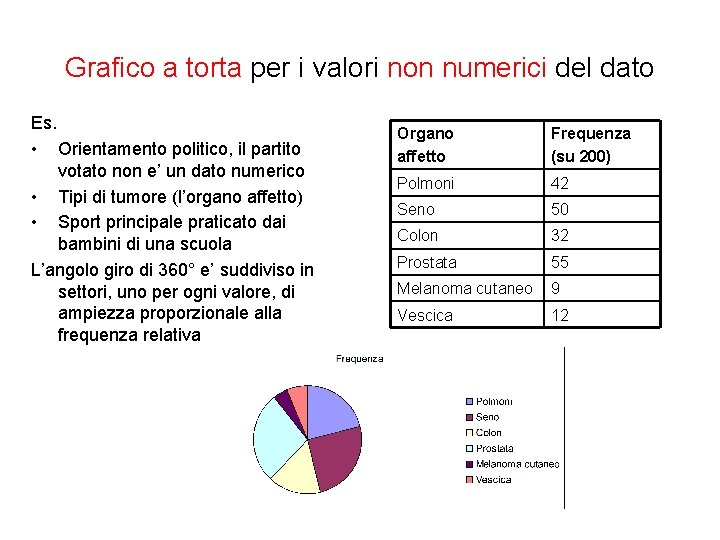
Grafico a torta per i valori non numerici del dato Es. • Orientamento politico, il partito votato non e’ un dato numerico • Tipi di tumore (l’organo affetto) • Sport principale praticato dai bambini di una scuola L’angolo giro di 360° e’ suddiviso in settori, uno per ogni valore, di ampiezza proporzionale alla frequenza relativa Organo affetto Frequenza (su 200) Polmoni 42 Seno 50 Colon 32 Prostata 55 Melanoma cutaneo 9 Vescica 12
Quando i valori assunti dati numerici sono molto numerosi (1) si aggregano per intervalli del tipo (ai, bi] di ampiezza costante In tal caso il grafico a barre prende il nome di ISTOGRAMMA. E’ molto utile in quanto visivamente rappresenta anche l’ampiezza scelta degli intervalli. I dati sull’asse delle x rappresentano i valori estremi degli intervalli e sono posti al confine tra una barra e la successiva, mentre nel grafico a barre vi e’ un valore (centrale) per ogni barra.
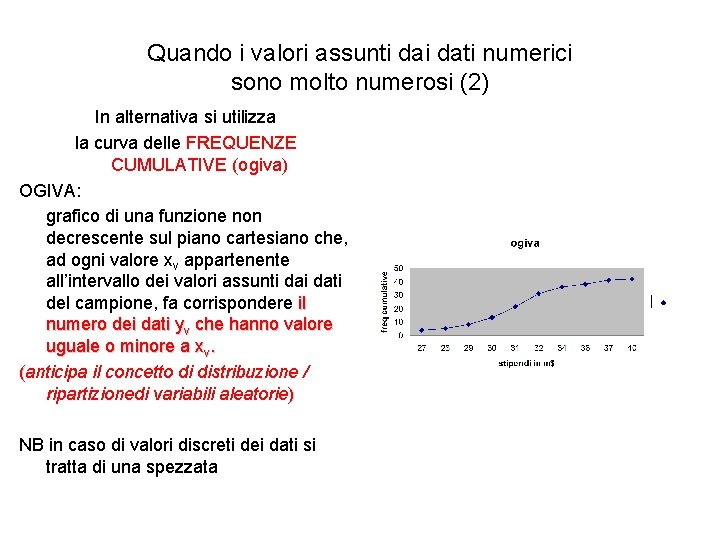
Quando i valori assunti dati numerici sono molto numerosi (2) In alternativa si utilizza la curva delle FREQUENZE CUMULATIVE (ogiva) OGIVA: grafico di una funzione non decrescente sul piano cartesiano che, ad ogni valore xv appartenente all’intervallo dei valori assunti dati del campione, fa corrispondere il numero dei dati yv che hanno valore uguale o minore a xv. (anticipa il concetto di distribuzione / ripartizionedi variabili aleatorie) NB in caso di valori discreti dei dati si tratta di una spezzata
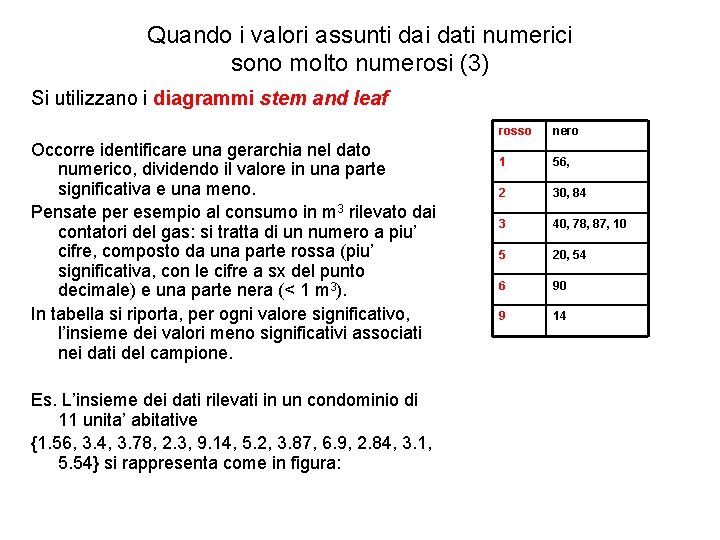
Quando i valori assunti dati numerici sono molto numerosi (3) Si utilizzano i diagrammi stem and leaf Occorre identificare una gerarchia nel dato numerico, dividendo il valore in una parte significativa e una meno. Pensate per esempio al consumo in m 3 rilevato dai contatori del gas: si tratta di un numero a piu’ cifre, composto da una parte rossa (piu’ significativa, con le cifre a sx del punto decimale) e una parte nera (< 1 m 3). In tabella si riporta, per ogni valore significativo, l’insieme dei valori meno significativi associati nei dati del campione. Es. L’insieme dei dati rilevati in un condominio di 11 unita’ abitative {1. 56, 3. 4, 3. 78, 2. 3, 9. 14, 5. 2, 3. 87, 6. 9, 2. 84, 3. 1, 5. 54} si rappresenta come in figura: rosso nero 1 56, 2 30, 84 3 40, 78, 87, 10 5 20, 54 6 90 9 14
Statistiche di sintesi dei dati numerici dei campioni • Media campionaria • Mediana campionaria • Moda campionaria
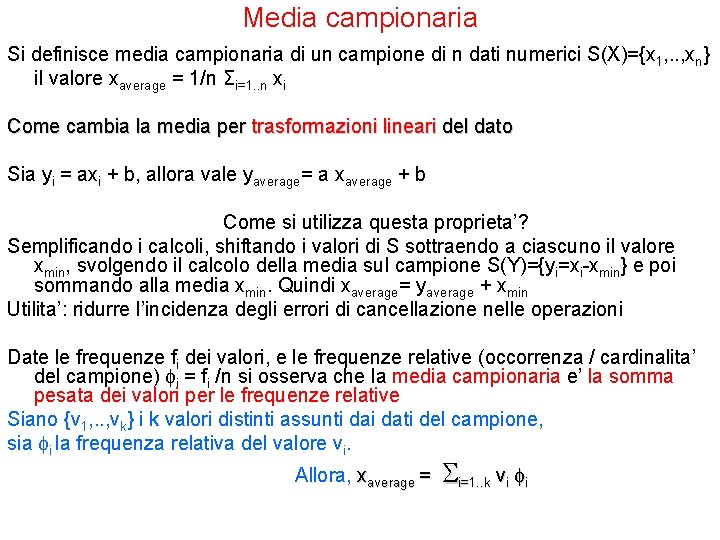
Media campionaria Si definisce media campionaria di un campione di n dati numerici S(X)={x 1, . . , xn} il valore xaverage = 1/n Σi=1. . n xi Come cambia la media per trasformazioni lineari del dato Sia yi = axi + b, allora vale yaverage= a xaverage + b Come si utilizza questa proprieta’? Semplificando i calcoli, shiftando i valori di S sottraendo a ciascuno il valore xmin, svolgendo il calcolo della media sul campione S(Y)={yi=xi-xmin} e poi sommando alla media xmin. Quindi xaverage= yaverage + xmin Utilita’: ridurre l’incidenza degli errori di cancellazione nelle operazioni Date le frequenze fi dei valori, e le frequenze relative (occorrenza / cardinalita’ del campione) fi = fi /n si osserva che la media campionaria e’ la somma pesata dei valori per le frequenze relative Siano {v 1, . . , vk} i k valori distinti assunti dati del campione, sia fi la frequenza relativa del valore vi. Allora, xaverage = Si=1. . k vi fi
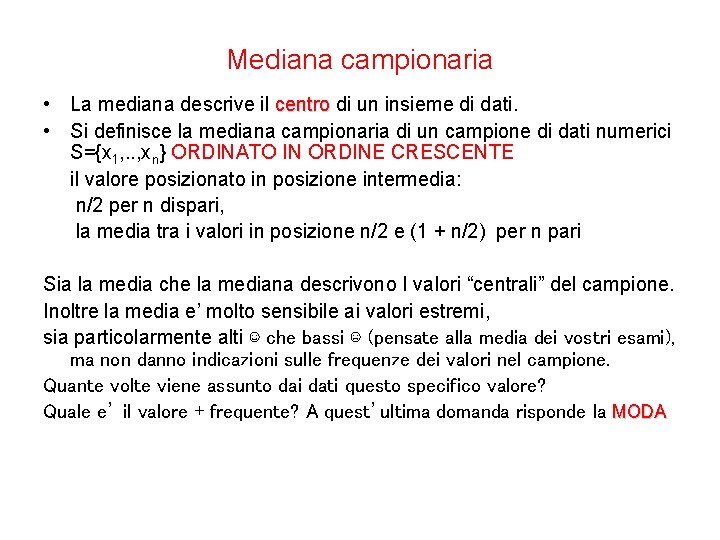
Mediana campionaria • La mediana descrive il centro di un insieme di dati. • Si definisce la mediana campionaria di un campione di dati numerici S={x 1, . . , xn} ORDINATO IN ORDINE CRESCENTE il valore posizionato in posizione intermedia: n/2 per n dispari, la media tra i valori in posizione n/2 e (1 + n/2) per n pari Sia la media che la mediana descrivono I valori “centrali” del campione. Inoltre la media e’ molto sensibile ai valori estremi, sia particolarmente alti ☺ che bassi ☹ (pensate alla media dei vostri esami), ma non danno indicazioni sulle frequenze dei valori nel campione. Quante volte viene assunto dai dati questo specifico valore? Quale e’ il valore + frequente? A quest’ultima domanda risponde la MODA
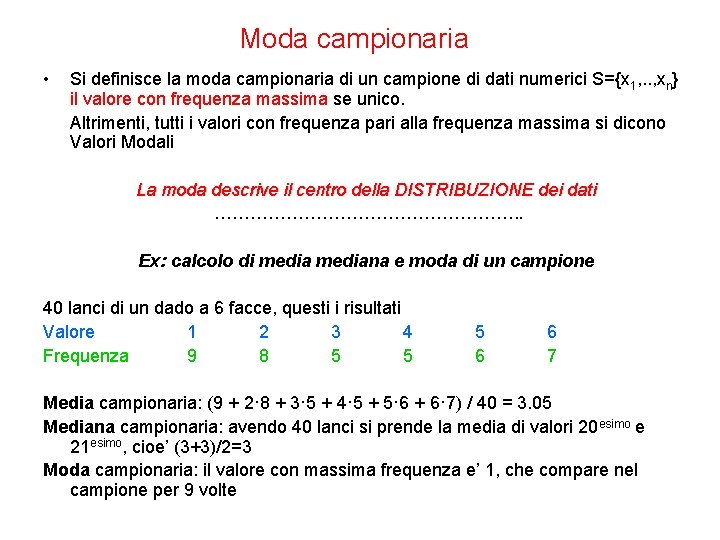
Moda campionaria • Si definisce la moda campionaria di un campione di dati numerici S={x 1, . . , xn} il valore con frequenza massima se unico. Altrimenti, tutti i valori con frequenza pari alla frequenza massima si dicono Valori Modali La moda descrive il centro della DISTRIBUZIONE dei dati ………………………. Ex: calcolo di mediana e moda di un campione 40 lanci di un dado a 6 facce, questi i risultati Valore 1 2 3 4 Frequenza 9 8 5 5 5 6 6 7 Media campionaria: (9 + 2· 8 + 3· 5 + 4· 5 + 5· 6 + 6· 7) / 40 = 3. 05 Mediana campionaria: avendo 40 lanci si prende la media di valori 20 esimo e 21 esimo, cioe’ (3+3)/2=3 Moda campionaria: il valore con massima frequenza e’ 1, che compare nel campione per 9 volte
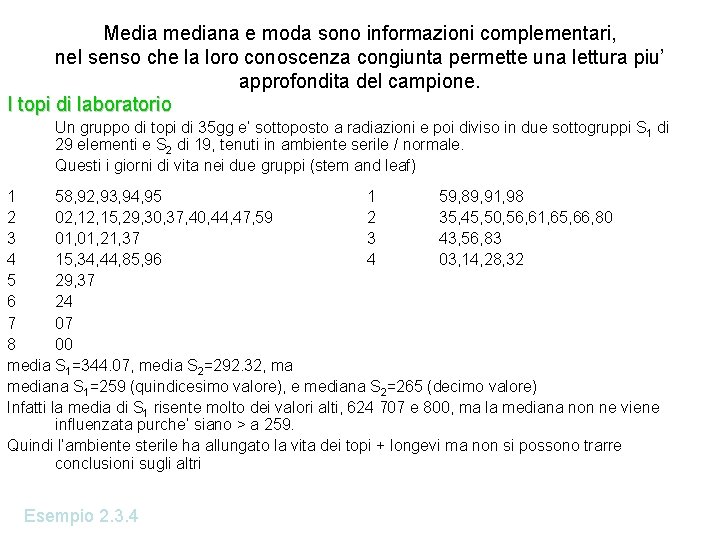
Media mediana e moda sono informazioni complementari, nel senso che la loro conoscenza congiunta permette una lettura piu’ approfondita del campione. I topi di laboratorio Un gruppo di topi di 35 gg e’ sottoposto a radiazioni e poi diviso in due sottogruppi S 1 di 29 elementi e S 2 di 19, tenuti in ambiente serile / normale. Questi i giorni di vita nei due gruppi (stem and leaf) 1 58, 92, 93, 94, 95 1 59, 89, 91, 98 2 02, 15, 29, 30, 37, 40, 44, 47, 59 2 35, 45, 50, 56, 61, 65, 66, 80 3 01, 21, 37 3 43, 56, 83 4 15, 34, 44, 85, 96 4 03, 14, 28, 32 5 29, 37 6 24 7 07 8 00 media S 1=344. 07, media S 2=292. 32, ma mediana S 1=259 (quindicesimo valore), e mediana S 2=265 (decimo valore) Infatti la media di S 1 risente molto dei valori alti, 624 707 e 800, ma la mediana non ne viene influenzata purche’ siano > a 259. Quindi l’ambiente sterile ha allungato la vita dei topi + longevi ma non si possono trarre conclusioni sugli altri Esempio 2. 3. 4
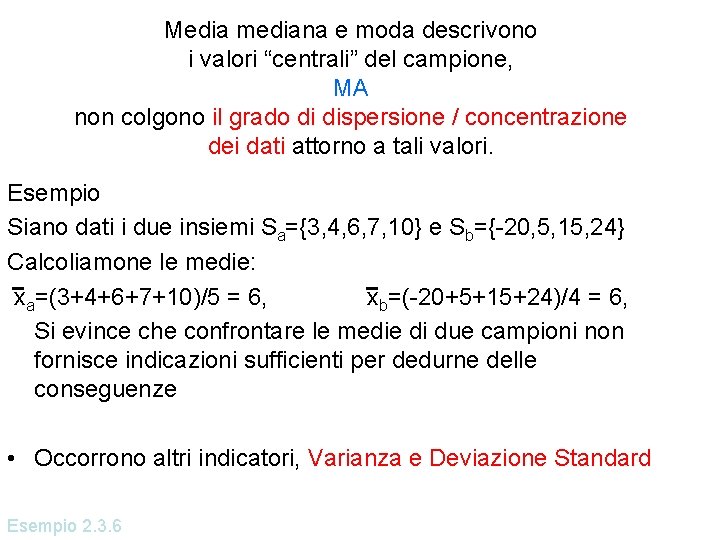
Media mediana e moda descrivono i valori “centrali” del campione, MA non colgono il grado di dispersione / concentrazione dei dati attorno a tali valori. Esempio Siano dati i due insiemi Sa={3, 4, 6, 7, 10} e Sb={-20, 5, 15, 24} Calcoliamone le medie: xa=(3+4+6+7+10)/5 = 6, xb=(-20+5+15+24)/4 = 6, Si evince che confrontare le medie di due campioni non fornisce indicazioni sufficienti per dedurne delle conseguenze • Occorrono altri indicatori, Varianza e Deviazione Standard Esempio 2. 3. 6
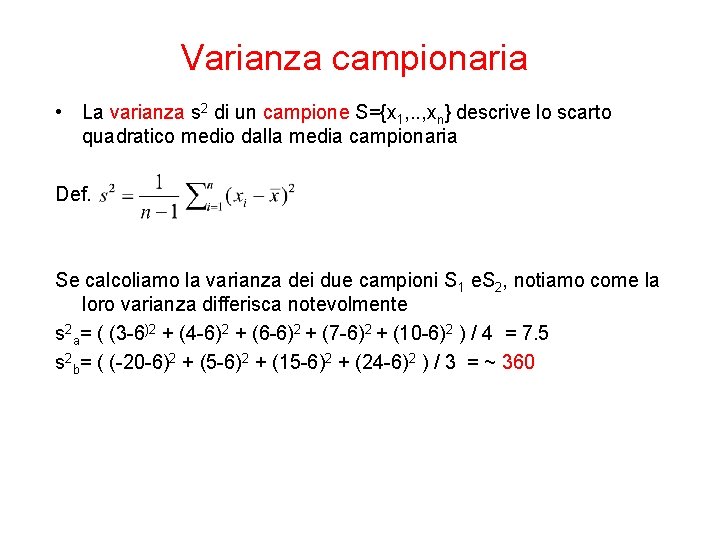
Varianza campionaria • La varianza s 2 di un campione S={x 1, . . , xn} descrive lo scarto quadratico medio dalla media campionaria Def. Se calcoliamo la varianza dei due campioni S 1 e. S 2, notiamo come la loro varianza differisca notevolmente s 2 a= ( (3 -6)2 + (4 -6)2 + (6 -6)2 + (7 -6)2 + (10 -6)2 ) / 4 = 7. 5 s 2 b= ( (-20 -6)2 + (5 -6)2 + (15 -6)2 + (24 -6)2 ) / 3 = ~ 360
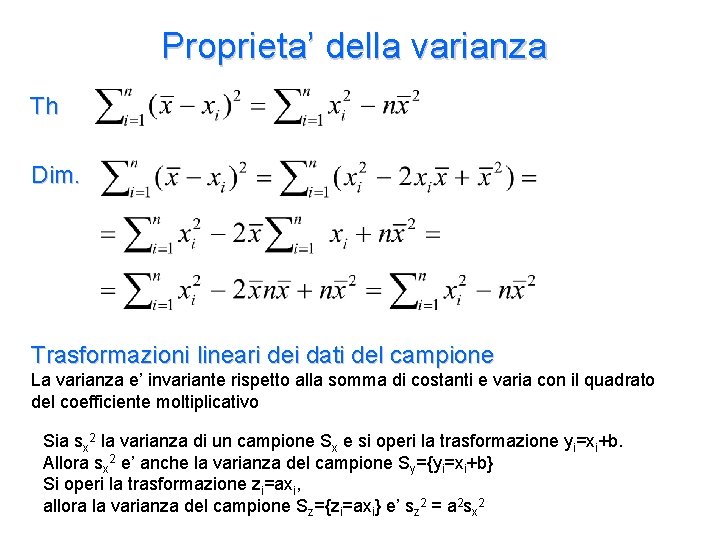
Proprieta’ della varianza Th Dim. Trasformazioni lineari dei dati del campione La varianza e’ invariante rispetto alla somma di costanti e varia con il quadrato del coefficiente moltiplicativo Sia sx 2 la varianza di un campione Sx e si operi la trasformazione yi=xi+b. Allora sx 2 e’ anche la varianza del campione Sy={yi=xi+b} Si operi la trasformazione zi=axi, allora la varianza del campione Sz={zi=axi} e’ sz 2 = a 2 sx 2
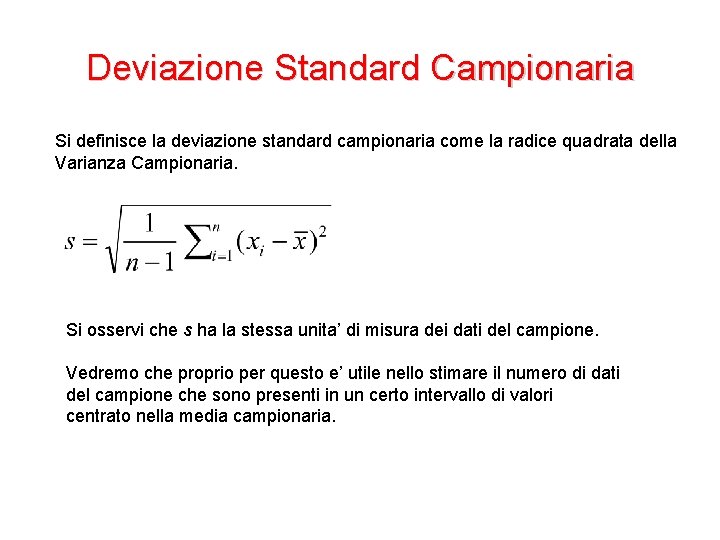
Deviazione Standard Campionaria Si definisce la deviazione standard campionaria come la radice quadrata della Varianza Campionaria. Si osservi che s ha la stessa unita’ di misura dei dati del campione. Vedremo che proprio per questo e’ utile nello stimare il numero di dati del campione che sono presenti in un certo intervallo di valori centrato nella media campionaria.
Percentile, quartile, box plot Def. dato k intero ∊(0, 100), si definisce come Percentile kesimo il valore al k% dei dati del campione e contemporaneamente ≤ al (100 -k)% dei dati, se unico, altrimenti la media dei 2. Si tratta del valore in posizione nk/100 avendo i dati del campione ordinati in ordine (non de)crescente. • Il 25 esimo percentile si dice primo quartile, quartile • il 50 esimo corrisponde alla mediana campionaria, o secondo quartile • il 75 esimo si dice terzo quartile
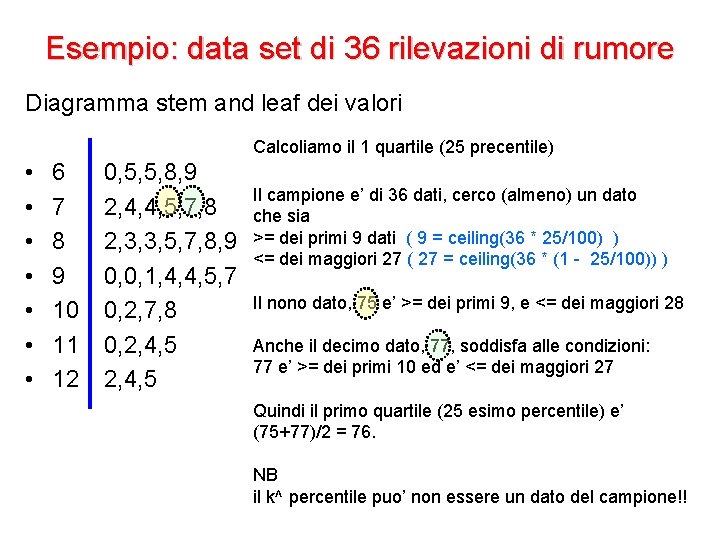
Esempio: data set di 36 rilevazioni di rumore Diagramma stem and leaf dei valori Calcoliamo il 1 quartile (25 precentile) • • 6 7 8 9 10 11 12 0, 5, 5, 8, 9 2, 4, 4, 5, 7, 8 2, 3, 3, 5, 7, 8, 9 0, 0, 1, 4, 4, 5, 7 0, 2, 7, 8 0, 2, 4, 5 Il campione e’ di 36 dati, cerco (almeno) un dato che sia >= dei primi 9 dati ( 9 = ceiling(36 * 25/100) ) <= dei maggiori 27 ( 27 = ceiling(36 * (1 - 25/100)) ) Il nono dato, 75 e’ >= dei primi 9, e <= dei maggiori 28 Anche il decimo dato, 77, soddisfa alle condizioni: 77 e’ >= dei primi 10 ed e’ <= dei maggiori 27 Quindi il primo quartile (25 esimo percentile) e’ (75+77)/2 = 76. NB il k^ percentile puo’ non essere un dato del campione!!
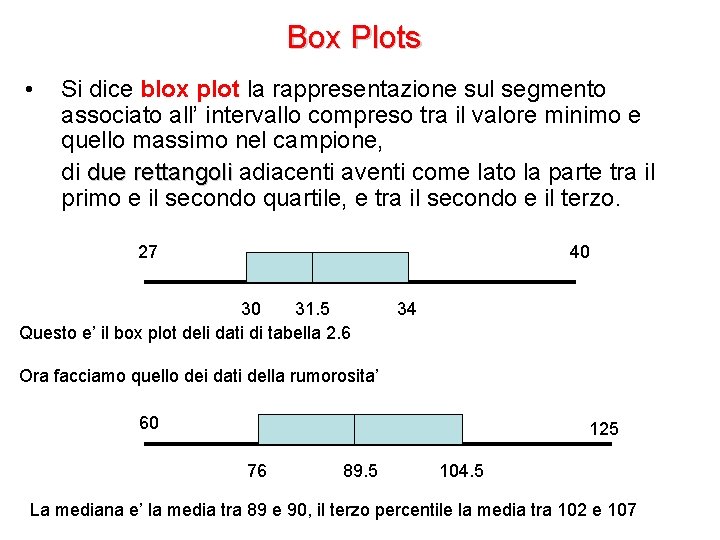
Box Plots • Si dice blox plot la rappresentazione sul segmento associato all’ intervallo compreso tra il valore minimo e quello massimo nel campione, di due rettangoli adiacenti aventi come lato la parte tra il primo e il secondo quartile, e tra il secondo e il terzo. 27 40 30 31. 5 Questo e’ il box plot deli dati di tabella 2. 6 34 Ora facciamo quello dei dati della rumorosita’ 60 125 76 89. 5 104. 5 La mediana e’ la media tra 89 e 90, il terzo percentile la media tra 102 e 107
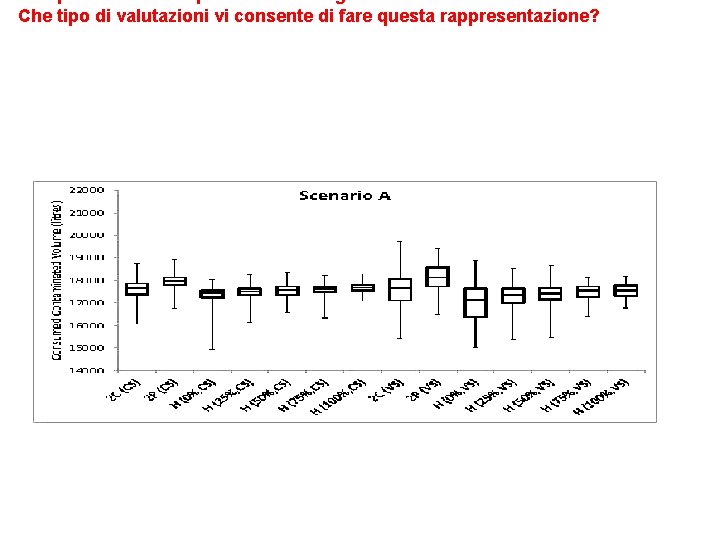
Che tipo di valutazioni vi consente di fare questa rappresentazione?
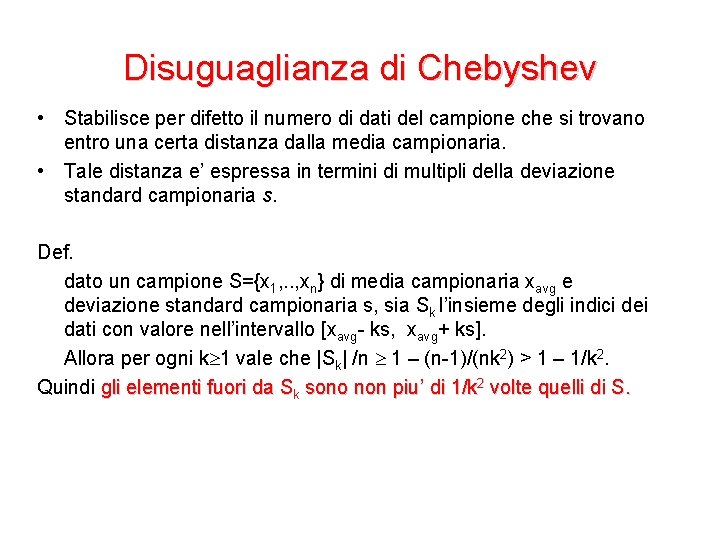
Disuguaglianza di Chebyshev • Stabilisce per difetto il numero di dati del campione che si trovano entro una certa distanza dalla media campionaria. • Tale distanza e’ espressa in termini di multipli della deviazione standard campionaria s. Def. dato un campione S={x 1, . . , xn} di media campionaria xavg e deviazione standard campionaria s, sia Sk l’insieme degli indici dei dati con valore nell’intervallo [xavg- ks, xavg+ ks]. Allora per ogni k 1 vale che |Sk| /n 1 – (n-1)/(nk 2) > 1 – 1/k 2. Quindi gli elementi fuori da Sk sono non piu’ di 1/k 2 volte quelli di S.
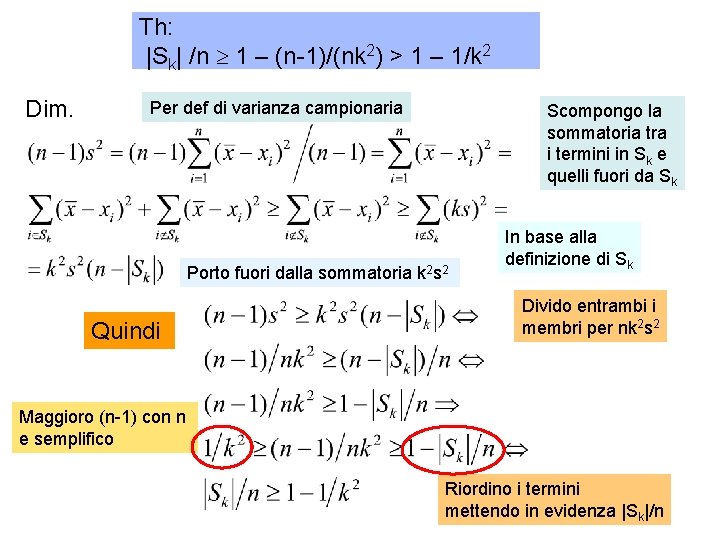
Th: |Sk| /n 1 – (n-1)/(nk 2) > 1 – 1/k 2 Dim. Per def di varianza campionaria Scompongo la sommatoria tra i termini in Sk e quelli fuori da Sk Porto fuori dalla sommatoria k 2 s 2 Quindi In base alla definizione di Sk Divido entrambi i membri per nk 2 s 2 Maggioro (n-1) con n e semplifico Riordino i termini mettendo in evidenza |Sk|/n
Campioni Normali Molto spesso gli istogrammi dei dati relativi a delle misurazioni sperimentali in contesti anche molto dissimili, hanno una forma caratteristica • I campioni normali sono contraddistinti dalla forma a campana degli istogrammi dei dati • Presentano un unico massimo in corrispondenza della mediana • Media = mediana = moda • La curva della campana e’ simmetrica rispetto alla media Esempi: altezza dei bambini di una certa scuola, misurata al k esimo giorno di eta’, ore spese davanti alla tv in un giorno, valore dell’emoglobina negli individui sani di sesso maschile in una certa fascia di eta’, … I campioni con queste caratteristiche si dicono campioni NORMALI
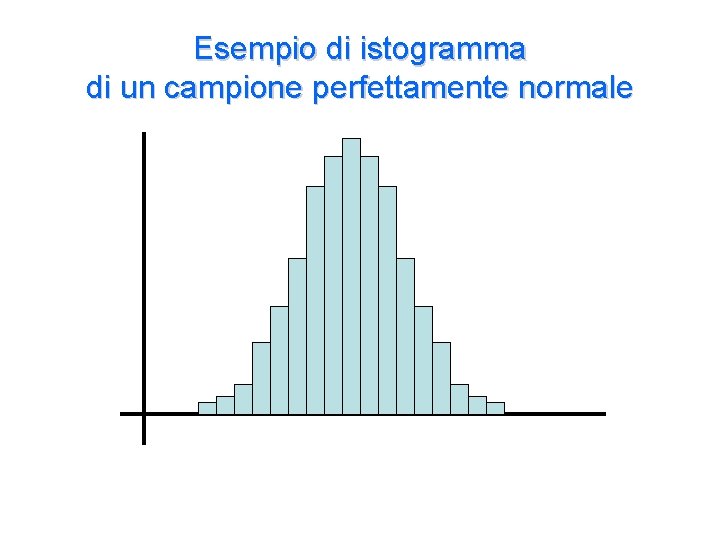
Esempio di istogramma di un campione perfettamente normale
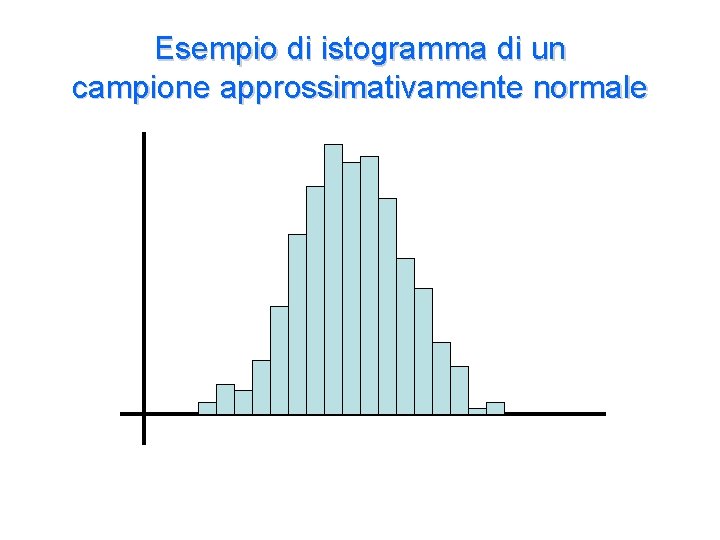
Esempio di istogramma di un campione approssimativamente normale
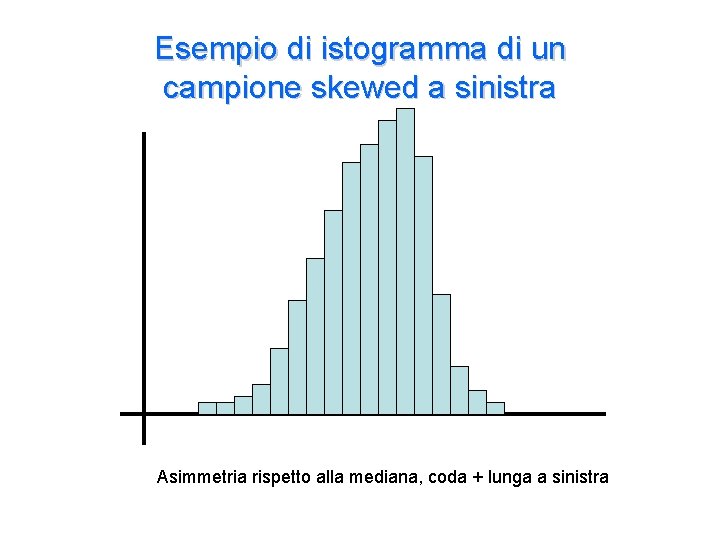
Esempio di istogramma di un campione skewed a sinistra Asimmetria rispetto alla mediana, coda + lunga a sinistra
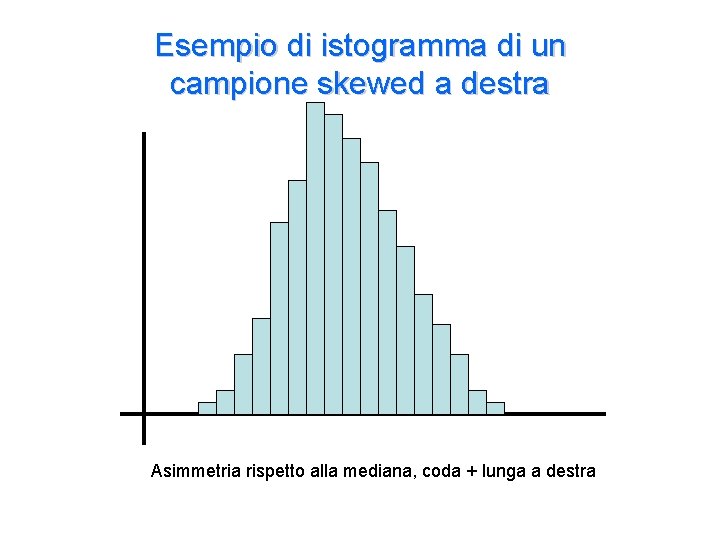
Esempio di istogramma di un campione skewed a destra Asimmetria rispetto alla mediana, coda + lunga a destra
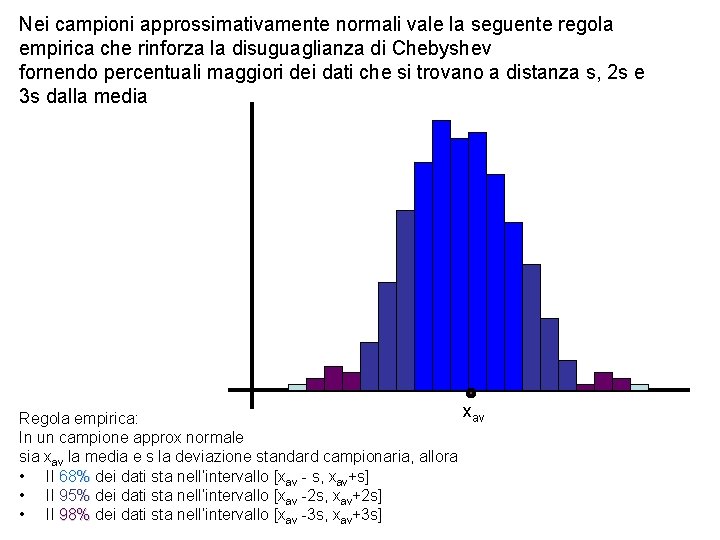
Nei campioni approssimativamente normali vale la seguente regola empirica che rinforza la disuguaglianza di Chebyshev fornendo percentuali maggiori dei dati che si trovano a distanza s, 2 s e 3 s dalla media xav Regola empirica: In un campione approx normale sia xav la media e s la deviazione standard campionaria, allora • Il 68% dei dati sta nell’intervallo [xav - s, xav+s] • Il 95% dei dati sta nell’intervallo [xav -2 s, xav+2 s] • Il 98% dei dati sta nell’intervallo [xav -3 s, xav+3 s]
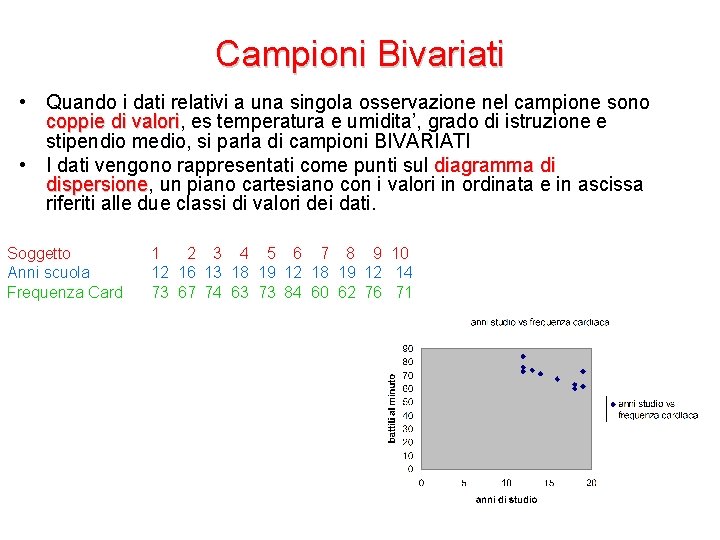
Campioni Bivariati • Quando i dati relativi a una singola osservazione nel campione sono coppie di valori, valori es temperatura e umidita’, grado di istruzione e stipendio medio, si parla di campioni BIVARIATI • I dati vengono rappresentati come punti sul diagramma di dispersione, dispersione un piano cartesiano con i valori in ordinata e in ascissa riferiti alle due classi di valori dei dati. Soggetto Anni scuola Frequenza Card 1 2 3 4 5 6 7 8 9 10 12 16 13 18 19 12 14 73 67 74 63 73 84 60 62 76 71
Correlazione tra valori delle coppie (x, y) Indichiamo ogni dato iesimo con la coppia dei valori associati (xi, yi) Ci si domanda se esiste corrispodenza tra I valori di x e y, in particolare – se a valori alti di x corrispondono generalmente valori alti di y e a valori bassi di x corrispondono generalmente a valori bassi di y si parla di correlazione positiva MENTRE – Se a valori alti di x corrispondono generalmente valori bassi di y e a valori bassi di x corrispondono generalmente valori alti di y si parla di correlazione negativa tra x e y. • Nel primo caso il diagrama di dispersione evidenzia una curva crescente, nel secondo una curva decrescente
Introduciamo una misura di questa relazione Siano xavg e yavg le medie dei valori dei dati relativi al primo e al secondo valore dei dati. Per ogni dato iesimo consideriamo il prodotto delle differenze dalle medie, (xavg -xi)(yavg -yi) Se (xavg -xi)(yavg -yi)>0 allora sia il primo che il secondo valore del dato sono sopra la rispettiva media, oppure entrambi inferiori ad essa. E’ cio’ che accadrebbe in caso di correlazione POSITIVA Se (xavg -xi)(yavg -yi)<0 allora o il primo valore del dato iesimo xi e’ inferiore alla sua media xavg mentre il secondo valore yi e’ superiore alla propria media yavg, o viceversa. E’ cio’ che accadrebbe in caso di correlazione NEGATIVA. Sommiamo questo valore per tutti i dati del campione e normalizziamo dividendo per ((n-1) sy sx) dove n e’ la cardinalita’ del campione, e sx sy sono le deviazioni standard campionarie del primo e del secondo valore dei dati del campione.
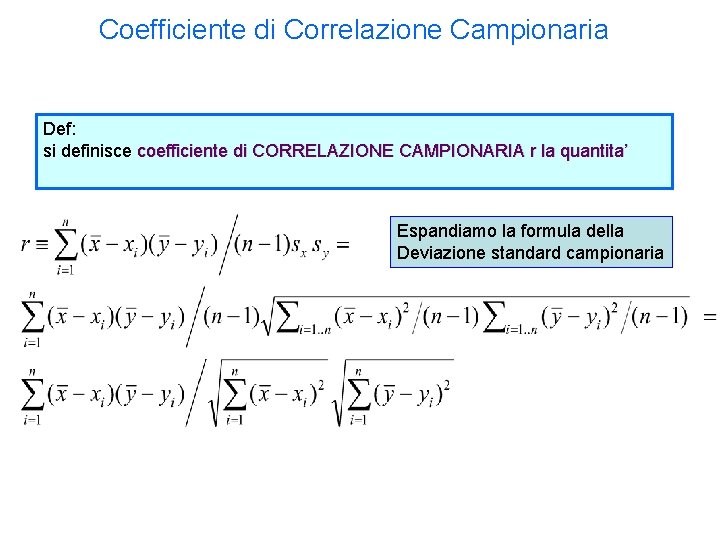
Coefficiente di Correlazione Campionaria Def: si definisce coefficiente di CORRELAZIONE CAMPIONARIA r la quantita’ Espandiamo la formula della Deviazione standard campionaria
Proprieta’ del Coefficiente di Correlazione Campionaria 1) Il valore del coefficiente di correlazione campionaria e’ compreso tra -1 e 1 2) Se i valori del secondo elemento della coppia di ciascun dato sono legati al primo da una relazione lineare, i. e. , yi = axi+b i=1. . n, con a>0 allora |r| = 1 Se invece la relazione vale per a<0 allora |r| = -1 3) Sia r e’ il coefficiente di correlazione campionaria del campione C 1={(xi, yi)} e sia C 2={(wi, zi)} con wi = axi+b e zi = cyi+d i=1. . n, dove i coefficienti a e c hanno lo stesso segno, allora il campione C 2 ha lo stesso coefficiente di correlazione campionario r del campione C 1. Una rilevante conseguenza della proprieta’ 3 e’ che il coefficiente di correlazione tra i due valori {xi} e {yi} NON dipende dall’unita’ di misura utilizzata per misurarli.
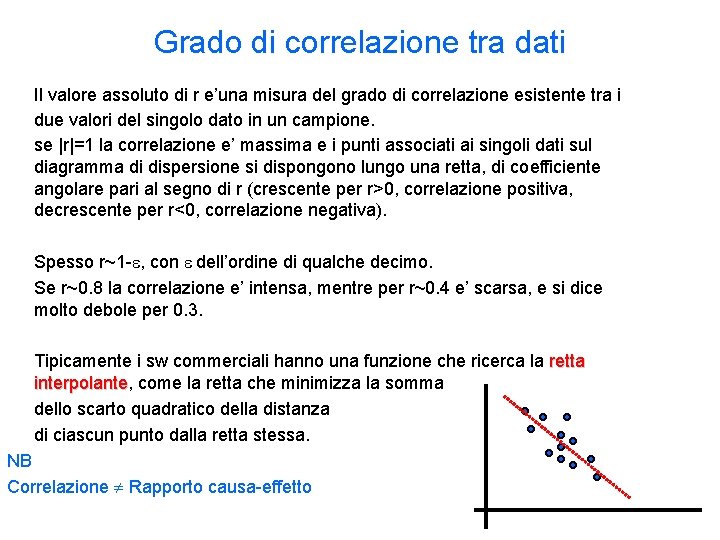
Grado di correlazione tra dati Il valore assoluto di r e’una misura del grado di correlazione esistente tra i due valori del singolo dato in un campione. se |r|=1 la correlazione e’ massima e i punti associati ai singoli dati sul diagramma di dispersione si dispongono lungo una retta, di coefficiente angolare pari al segno di r (crescente per r>0, correlazione positiva, decrescente per r<0, correlazione negativa). Spesso r~1 -e, con e dell’ordine di qualche decimo. Se r~0. 8 la correlazione e’ intensa, mentre per r~0. 4 e’ scarsa, e si dice molto debole per 0. 3. Tipicamente i sw commerciali hanno una funzione che ricerca la retta interpolante, interpolante come la retta che minimizza la somma dello scarto quadratico della distanza di ciascun punto dalla retta stessa. NB Correlazione Rapporto causa-effetto
- Slides: 38