
BANCO DE DADOS Sistemas de Recuperao Bacharelado em
BANCO DE DADOS Sistemas de Recuperação Bacharelado em Ciência da Computação IFCE - Campus Aracati - Semestre 2018. 1 Prof. Érica Gallindo - erica. gallindo@ifce. edu. br
Assuntos Abordados 1. Conceitos de Recuperação em BD 2. Técnicas de Recuperação Com atualização adiada Com modificação imediata 3. 4. 5. 6. Recuperação com transações concorrentes Gerenciamento de buffer Sistemas de backup remoto Método de Recuperação ARIES
1. Conceitos de Recuperação em BD
Sistemas de Recuperação Um sistema computacional está sujeito a falhas por uma série de causas: falha de disco, falta de energia, erro de software, incêndio na sala de equipamentos, etc. Falhas podem levar a perda de informações Sistemas de banco de dados precisam se antecipar a estas questões de forma que as propriedades de atomicidade e durabilidade sejam preservadas. Um esquema de recuperação deve ser capaz de restaurar o banco ao último estado coerente antes da ocorrência de falhas. Deve também oferecer alta disponibilidade; reduzir o downtime do sistema
Recuperação de Falhas A recuperação de falhas existe para garantir as propriedades de atomicidade e de durabilidade das transações O sistema de recuperação de falhas é responsável pela restauração do banco de dados para o estado anterior ao de ocorrência de uma falha.
Classificação de Falhas Tipos de falhas tratáveis por um sistema de recuperação de falhas Falhas de transação -> SGBD entra em ação Erros lógicos: transação não pode continuar devido a alguma condição de erro interna Erros de sistema: o sistema entrou em um estado indesejável comprometendo a execução da transação. Falha do sistema causa perda do armazenamento volátil e encerra a transação. Falha de disco Perda parcial ou total do conteúdo não volátil Backups são usados para a recuperação deste tipo de falha
Algoritmos de Recuperação Os algoritmos de recuperação possuem duas partes: 1. Ações tomadas durante o processamento normal de uma transação, para garantir informações suficientes para permitir a recuperação de falhas; 2. Ações realizadas após uma falha, para recuperar o conteúdo do banco de dados a um estado que garanta sua consistência, atomicidade e a durabilidade das transações.
Estrutura de Armazenamento 1) Armazenamento volátil: Não sobrevive a crash do sistema Acesso rápido tanto devido a velocidade do próprio componente quanto ao fato de se acessar um item de dado diretamente. 2) Armazenamento não-volátil: Sobrevive a crashes do sistema Ainda pode falhar, causando perda de dados 3) Armazenamento estável (stable storage): Informação nunca é perdida Em teoria impossível de se obter mas técnicas tornam a perda de dados extremamente improvável
Implementação de Stable Storage Sistemas RAID Replicação da informação necessária em vários meios de armazenamentos não-volátil (ex: discos) Garantem que a falha em um único disco não resultará em perda de dados Forma mais simples: discos espelhados, mantendo duas cópias de cada bloco em discos separados Não protegem contra perda de dados devido a desastres como incêndio ou inundação. Alternativa Backups em fitas, guardados em locais distintos, para proteção contra desastres; sistemas de backups remotos (transferência de dados via rede)
Proteção contra a falha durante a transferência de dados A transferência de bloco entre a memória e o armazenamento em disco pode resultar em: Término bem sucedido: a informação transferida chegou com segurança ao destino Falha parcial: a falha ocorreu no meio da transferência, e o bloco de destino possui informações incorretas. Falha total: a falha ocorreu suficientemente cedo durante a transferência, de modo que o bloco de destino permanece intacto Se houver uma falha de transferência de dados, é preciso que o sistema a detecte e invoque um procedimento de recuperação para restaurar o bloco a um estado consistente.
Como é feita a detecção do estado inconsistente? O sistema precisa manter dois blocos físicos para cada bloco lógico do banco de dados Discos espelhados: ambos blocos no mesmo local Backup remoto: um dos blocos está local e o outro está em uma instalação remota Uma operação de saída é executada da seguinte forma: 1. Escreva a informação no primeiro bloco físico 2. Quando a 1ª. escrita terminar com sucesso, escreva o 2º. bloco físico 3. A saída só é completada quando a 2ª. escrita terminar com sucesso
Recuperação de dados o stable storage Durante a recuperação o sistema examina cada par de blocos físicos Se ambos forem iguais e não houver erro detectável, então nenhuma ação adicional é necessária Se o sistema detectar um erro em um bloco, ele substitui seu conteúdo pelo conteúdo do outro bloco Se os dois blocos não tiverem um erro detectável mas diferirem no conteúdo, então o sistema substitui o conteúdo do 1º. bloco pelo valor do segundo Este procedimento de recuperação garante que uma escrita no armazenamento estável tenha sucesso completo (atualize todas as cópias) ou não resulte em mudança alguma processo dispendioso.
Acesso aos Dados: blocos Blocos são as unidades: de armazenamento de tamanho fixo dos BD de transferência de/para o disco que contém diversos itens de dados. Assumiremos que todo item de dado cabe dentro de um único bloco. Tipos de Blocos físicos são aqueles que residem no disco. Blocos de buffer são aqueles que reside temporariamente na memória principal. Área da memória onde os blocos residem: buffer de disco
Acesso aos Dados: movimentação de blocos A movimentação de blocos entre o disco e a memória é envolve duas operações: input(B) transfere o bloco físico B para a memória. output(B) transfere o bloco de buffer B para o disco, e substitui o bloco físico apropriado (no disco).
Acesso aos Dados: área de trabalho das transações Cada transação Ti tem sua área de trabalho privada na qual são mantidas cópias de todos os itens de dados acessados e atualizados por Ti Esta área é criada quando a transação é iniciada; é removida quando a transação é confirmada ou abortada A cópia local de Ti de um item de dado X é chamada xi. A transação Ti interage com o BD transferindo dados de/para sua área de trabalho no buffer de disco e vice-versa
Operações de transferência de dados (da área local de Ti para o buffer de bloco) Operações read(X): copia o valor do item de dado X para a variável de programa xi write(X): atribui o valor da variável local xi ao item de dado X no buffer de disco Em ambas operações se o bloco Bx em que X reside não estiver na memória principal, então é emitido input (Bx) Não exigem especificamente que blocos sejam levados da memória para o disco
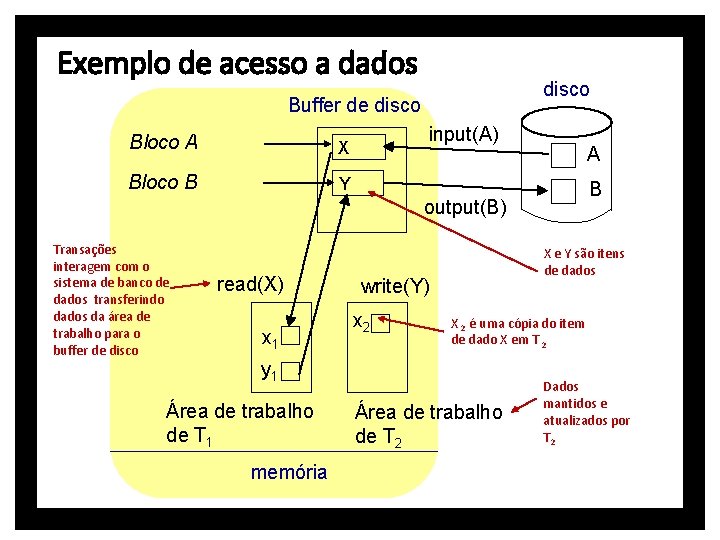
Exemplo de acesso a dados disco Buffer de disco Bloco A X Bloco B Y input(A) A B output(B) Transações interagem com o sistema de banco de dados transferindo dados da área de trabalho para o buffer de disco read(X) x 1 X e Y são itens de dados write(Y) x 2 X 2 é uma cópia do item de dado X em T 2 y 1 Área de trabalho de T 1 memória Área de trabalho de T 2 Dados mantidos e atualizados por T 2
Gravação no armazenamento não-volátil Quando um bloco de buffer é gravado em disco? Quando o gerenciador de buffer precisar do espaço da memória para outras finalidades Quando o SGBD decide refletir a mudança feita em B no disco Diz-se que o SGBD realiza uma saída forçada do buffer B se emitir um output(B) Nem sempre o output(Bx) ocorre imediatamente depois de um write(X). Então, se o sistema falhar, o valor escrito em B por uma transação pode se perder.
Acesso aos dados Para acessar um item de dado X pela primeira vez, uma transação Ti precisa executar read(X) Atualizações são feitas sobre Xi (cópia da área de trabalho local de Ti ) Depois de acessar X pela última vez, ela precisa executar write(X) para refletir no BD as mudanças feitas por Ti em X
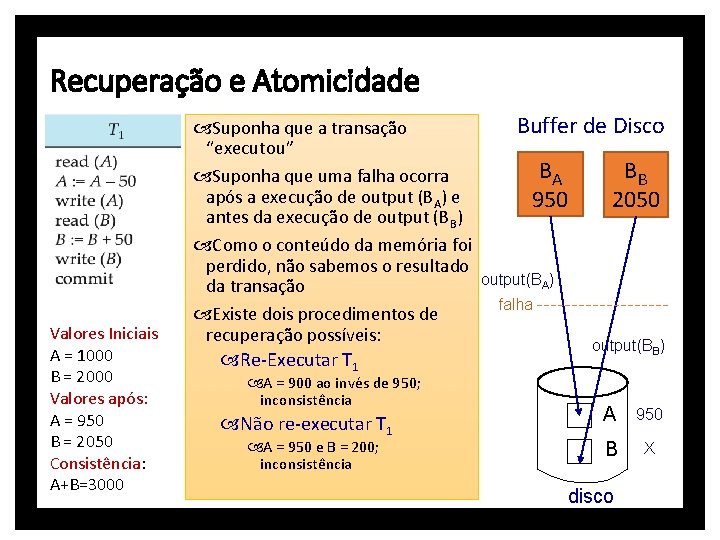
Recuperação e Atomicidade Valores Iniciais A = 1000 B = 2000 Valores após: A = 950 B = 2050 Consistência: A+B=3000 Buffer de Disco Suponha que a transação “executou” BA BB Suponha que uma falha ocorra após a execução de output (BA) e 950 2050 antes da execução de output (BB) Como o conteúdo da memória foi perdido, não sabemos o resultado output(BA) da transação falha Existe dois procedimentos de recuperação possíveis: output(BB) Re-Executar T 1 A = 900 ao invés de 950; inconsistência Não re-executar T 1 A = 950 e B = 200; inconsistência A 950 B X disco
Recuperação e Atomicidade O problema ocorreu porque modificou-se o banco de dados sem se ter certeza de que a transação seria efetivada de fato Nos dois casos o BD fica em estados inconsistente Abordagens de recuperação não funcionam O objetivo é executar todas ou nenhuma das modificações feitas por T 1 no BD Se T 1 realizou várias modificações no BD, várias operações de saída (output) podem ser necessárias e uma falha pode ocorrer após a realização de alguma delas e antes que todas sejam feitas Para garantir a atomicidade, precisaremos primeiro enviar as informações sobre as modificações para um meio estável, sem modificar o BD propriamente dito Solução: registrar histórico em arquivo (LOG)
Recuperação baseada em log (para execuções seriais) A estrutura mais utilizada para se registrar as modificações de um banco dados é um log. O LOG uma seqüência de registros de log que mantém um arquivo atualizado sobre as atividades realizadas com os dados de um banco de dados.
Registros de LOG Um registro de atualização de log descreve uma única operação (de escrita) com um dado e possui os seguintes campos: <Ti, Xj, V 1, V 2> Onde: Ti: Identificador único da transação que realizou uma operação e write Xi: Identificador único do item de dados escrito V 1: Valor antigo: valor do item de dados antes da escrita V 2: Valor novo: valor que o item de dado terá após a escrita
Tipos de Registro de Log Quando uma transação Ti inicia, ela se registra escrevendo <Ti start> Antes de Ti executar write(X), é escrito um log record <Ti, X, V 1, V 2> Update log record onde V 1 é o valor de X antes do write (valor anterior) V 2 é o valor a ser escrito em X (novo valor). Quando Ti termina é escrito o último statement <Ti commit> Quando Ti é abortada é escrito <Ti abort>
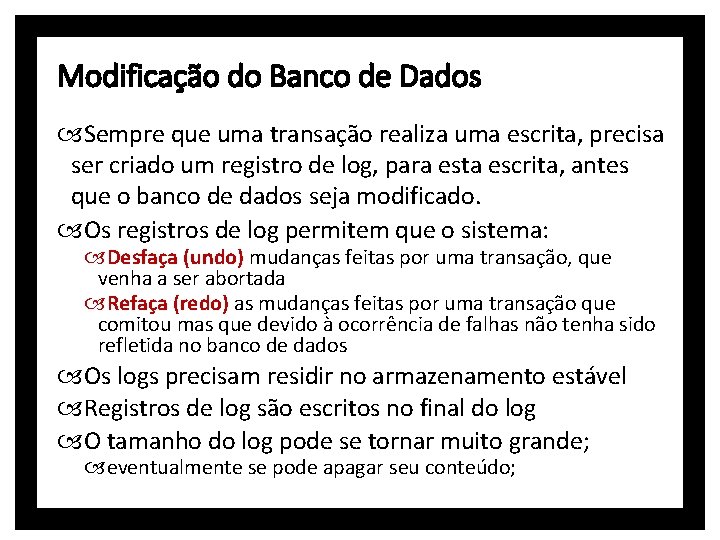
Modificação do Banco de Dados Sempre que uma transação realiza uma escrita, precisa ser criado um registro de log, para esta escrita, antes que o banco de dados seja modificado. Os registros de log permitem que o sistema: Desfaça (undo) mudanças feitas por uma transação, que venha a ser abortada Refaça (redo) as mudanças feitas por uma transação que comitou mas que devido à ocorrência de falhas não tenha sido refletida no banco de dados Os logs precisam residir no armazenamento estável Registros de log são escritos no final do log O tamanho do log pode se tornar muito grande; eventualmente se pode apagar seu conteúdo;
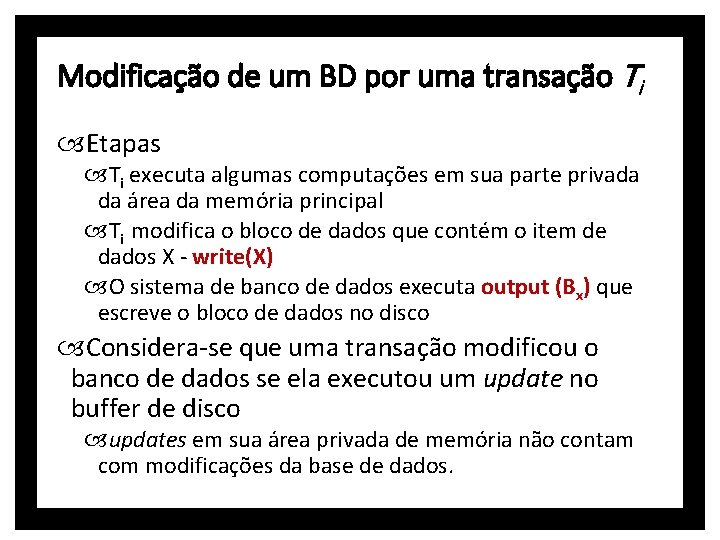
Modificação de um BD por uma transação Ti Etapas Ti executa algumas computações em sua parte privada da área da memória principal Ti modifica o bloco de dados que contém o item de dados X - write(X) O sistema de banco de dados executa output (Bx) que escreve o bloco de dados no disco Considera-se que uma transação modificou o banco de dados se ela executou um update no buffer de disco updates em sua área privada de memória não contam com modificações da base de dados.
2. Técnicas de Recuperação
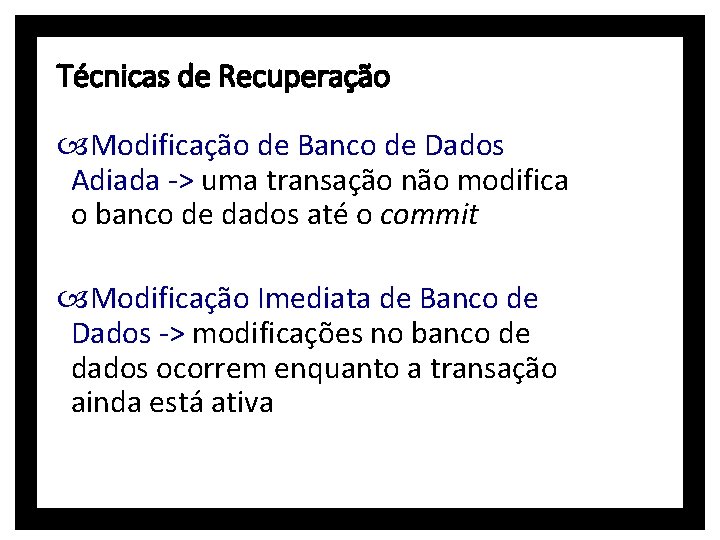
Técnicas de Recuperação Modificação de Banco de Dados Adiada -> uma transação não modifica o banco de dados até o commit Modificação Imediata de Banco de Dados -> modificações no banco de dados ocorrem enquanto a transação ainda está ativa
Modificação de BD adiada Registra todas as modificações do BD no log Adia a execução de todas as operações write() de uma transação até esta seja parcialmente comitada Parcialmente comitado é o estado de uma transação que executou sua ação final
Como funciona a execução da transação? Antes do início da execução de Ti, registro <Ti start> é escrito no log Quando Ti executa a operação write(X), um novo registro é escrito no log Quando Ti é confirmada parcialmente, um registro <Ti commit> é escrito no log Notas: Quando uma transação está parcialmente comitada a informação no log é usada na execução das escritas adiadas Como falhas podem ocorrer durante esta atualização, os registros de log precisam estar no armazenamento estável Então a atualização real ocorre e a transação entra num estado confiável
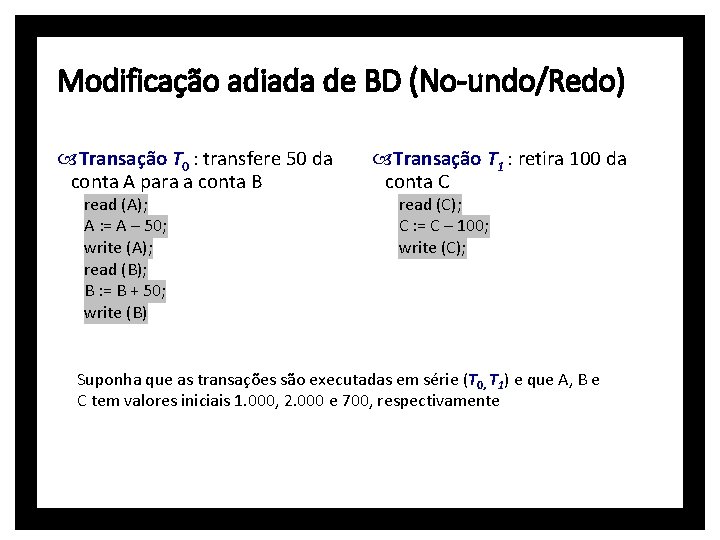
Modificação adiada de BD (No-undo/Redo) Transação T 0 : transfere 50 da conta A para a conta B read (A); A : = A – 50; write (A); read (B); B : = B + 50; write (B) Transação T 1 : retira 100 da conta C read (C); C : = C – 100; write (C); Suponha que as transações são executadas em série (T 0, T 1) e que A, B e C tem valores iniciais 1. 000, 2. 000 e 700, respectivamente
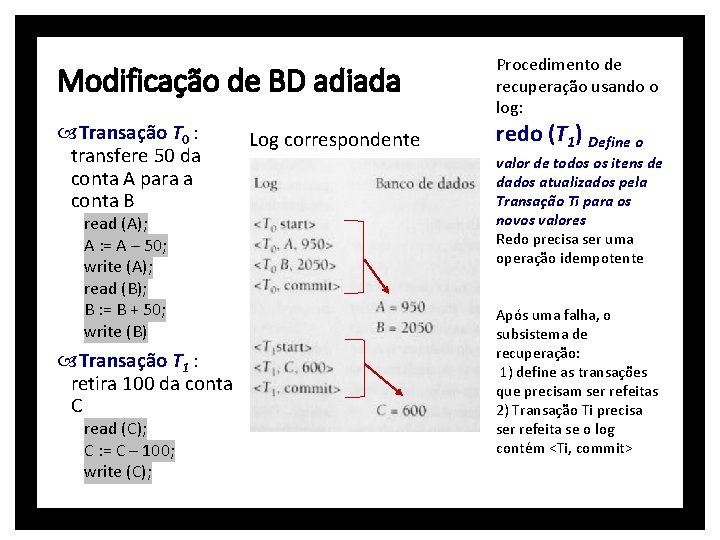
Modificação de BD adiada Transação T 0 : transfere 50 da conta A para a conta B read (A); A : = A – 50; write (A); read (B); B : = B + 50; write (B) Transação T 1 : retira 100 da conta C read (C); C : = C – 100; write (C); Log correspondente (parte relevante) Procedimento de recuperação usando o log: redo (T 1) Define o valor de todos os itens de dados atualizados pela Transação Ti para os novos valores Redo precisa ser uma operação idempotente Após uma falha, o subsistema de recuperação: 1) define as transações que precisam ser refeitas 2) Transação Ti precisa ser refeita se o log contém <Ti, commit>
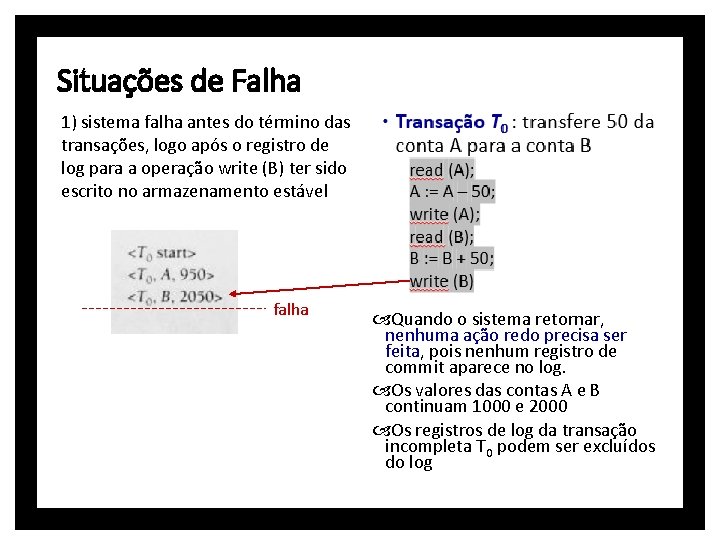
Situações de Falha 1) sistema falha antes do término das transações, logo após o registro de log para a operação write (B) ter sido escrito no armazenamento estável falha Quando o sistema retornar, nenhuma ação redo precisa ser feita, pois nenhum registro de commit aparece no log. Os valores das contas A e B continuam 1000 e 2000 Os registros de log da transação incompleta T 0 podem ser excluídos do log
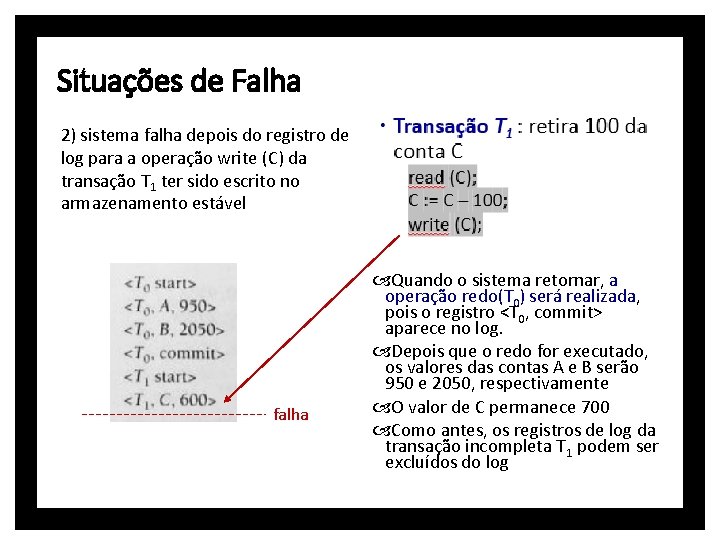
Situações de Falha 2) sistema falha depois do registro de log para a operação write (C) da transação T 1 ter sido escrito no armazenamento estável falha Quando o sistema retornar, a operação redo(T 0) será realizada, pois o registro <T 0, commit> aparece no log. Depois que o redo for executado, os valores das contas A e B serão 950 e 2050, respectivamente O valor de C permanece 700 Como antes, os registros de log da transação incompleta T 1 podem ser excluídos do log
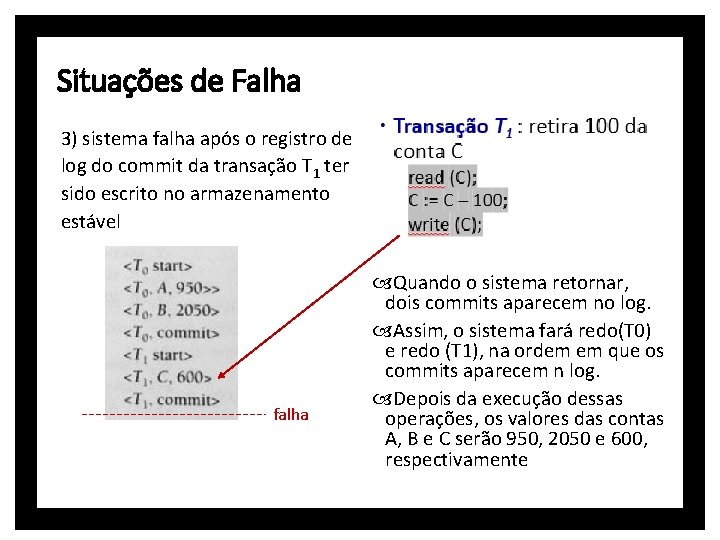
Situações de Falha 3) sistema falha após o registro de log do commit da transação T 1 ter sido escrito no armazenamento estável falha Quando o sistema retornar, dois commits aparecem no log. Assim, o sistema fará redo(T 0) e redo (T 1), na ordem em que os commits aparecem n log. Depois da execução dessas operações, os valores das contas A, B e C serão 950, 2050 e 600, respectivamente
Modificação Imediata de BD Permite que as operações write() possam ser enviadas ao banco enquanto uma transação ainda está ativa Modificações de dados escritas por transações ativas são chamadas “modificações não confirmadas” Neste esquema de modificação de BD, o log deverá armazenar o valor antigo e o valor novo oriundos das operações de write()
Como funciona a execução da transação? Antes do início da execução de Ti: registro <Ti start> é escrito no log Durante sua execução, qualquer operação de Ti de write(X) é precedida pela escrita do novo registro de atualização no log Quando Ti é confirmada parcialmente: registro <Ti commit> é escrito no log Para que a recuperação funcione, as informações podem ser atualizadas no BD assim que o log esteja salvo em um armazenamento estável. Antes de output(B), os registros de log correspondentes a B devem ser escritos no log
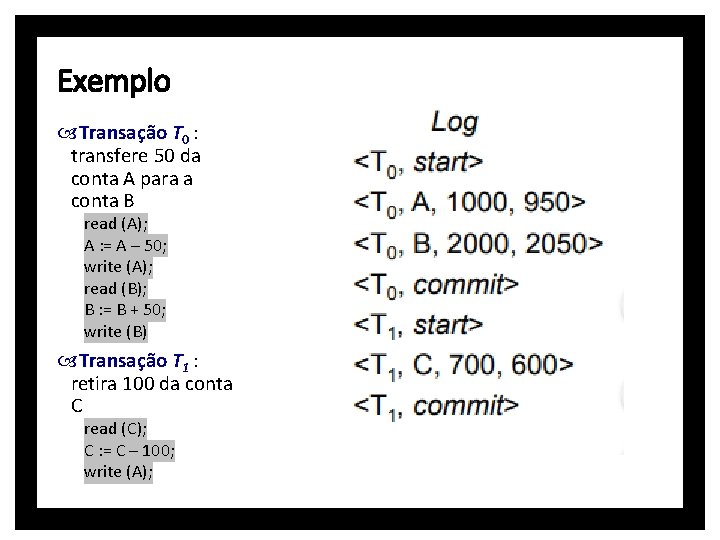
Exemplo Transação T 0 : transfere 50 da conta A para a conta B read (A); A : = A – 50; write (A); read (B); B : = B + 50; write (B) Transação T 1 : retira 100 da conta C read (C); C : = C – 100; write (A);
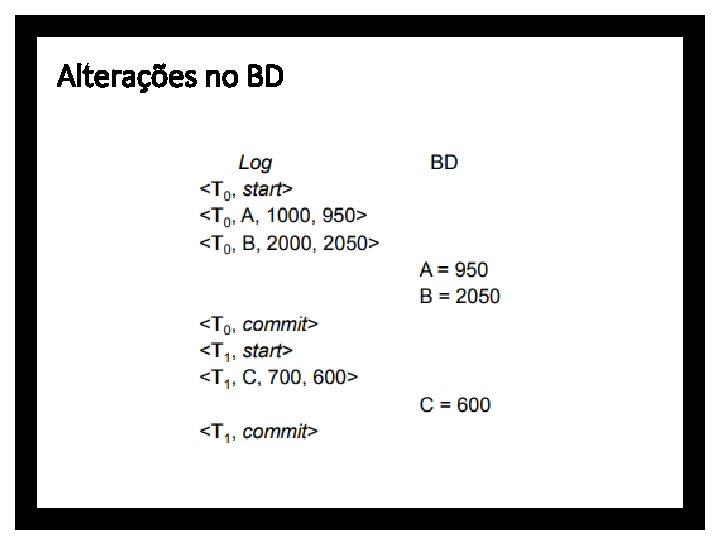
Alterações no BD
Recuperação Procedimentos de recuperação em caso de falhas que resultem em perda de informação no armazenamento volátil: Undo(Ti)/Desfazer Ti retorna aos valores antigos todos os itens de dados atualizados pela transação Ti. Redo(Ti)/Refazer Ti ajusta os valores de todos os itens de dados atualizados pela transação Ti para os novos valores.
Operações Undo e Redo Undo de um registro de log <Ti, X, V 1, V 2> escreve o valor antigo V 1 to X Redo de um registro de log <Ti, X, V 1, V 2> escreve o novo valor V 2 to X Undo e Redo de transações undo(Ti) restabelece o valor anterior de todos os itens de dados atualizados por Ti, começando pelo ultimo registro de log de Ti (backward) Quando o undo de uma transação é completado, um registro de log <Ti abort> é escrito redo(Ti) atualiza o valor de todos os itens de dados atualizados por Ti, começando pelo primeiro registro de log para Ti Nenhum registro de log é feito neste caso
Recuperação Após a falha, o sistema de recuperação consulta o log para determinar quais transações precisam ser desfeitas e quais precisam ser refeitas: A transação Ti tem que ser desfeita se o log contiver o registro <Ti, start>, mas não possuir o registro <Ti, commit>. A transação Ti tem que ser refeita se o log contiver tanto o registro <Ti, start> quando o registro <Ti, commit> ou <Ti, abort>.
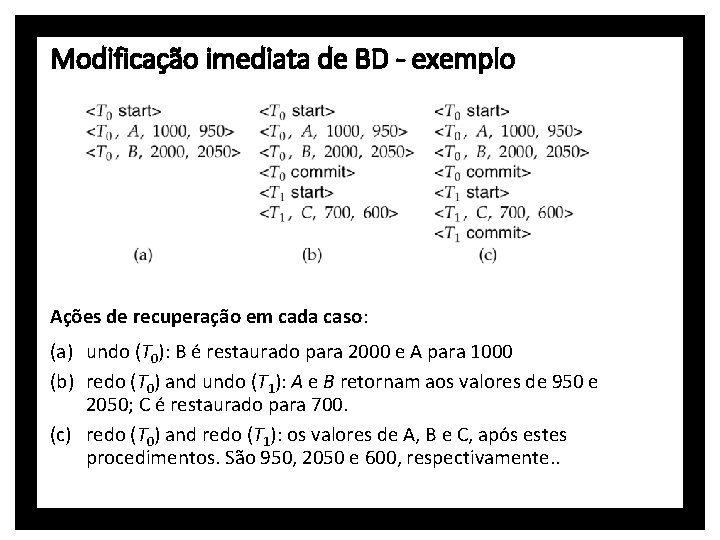
Modificação imediata de BD - exemplo Ações de recuperação em cada caso: (a) undo (T 0): B é restaurado para 2000 e A para 1000 (b) redo (T 0) and undo (T 1): A e B retornam aos valores de 950 e 2050; C é restaurado para 700. (c) redo (T 0) and redo (T 1): os valores de A, B e C, após estes procedimentos. São 950, 2050 e 600, respectivamente. .
Checkpoints Na existência de uma falha, o sistema de recuperação deve, a princípio, percorrer todo o log para saber quais transações devem ser desfeitas. Dificuldades: O processo de pesquisa consome tempo; Muitas das transações que necessitam ser refeitas já escreveram suas atualizações no BD. Embora refazê-las não cause dano algum, a recuperação se tornará mais onerosa.
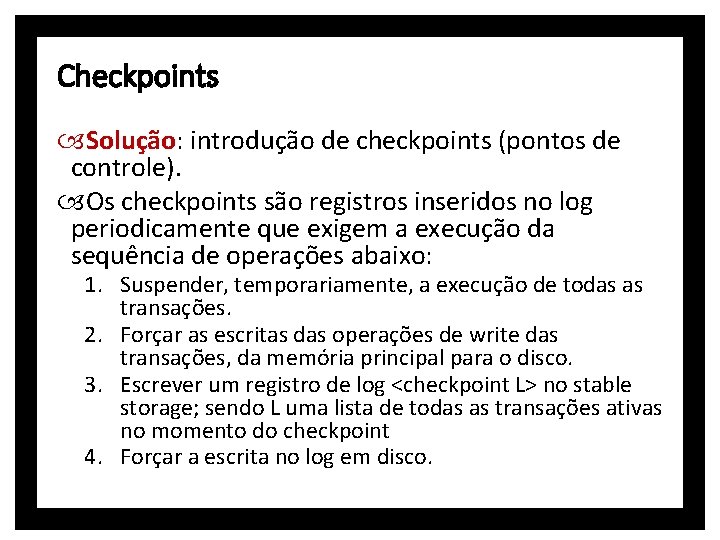
Checkpoints Solução: introdução de checkpoints (pontos de controle). Os checkpoints são registros inseridos no log periodicamente que exigem a execução da sequência de operações abaixo: 1. Suspender, temporariamente, a execução de todas as transações. 2. Forçar as escritas das operações de write das transações, da memória principal para o disco. 3. Escrever um registro de log <checkpoint L> no stable storage; sendo L uma lista de todas as transações ativas no momento do checkpoint 4. Forçar a escrita no log em disco.
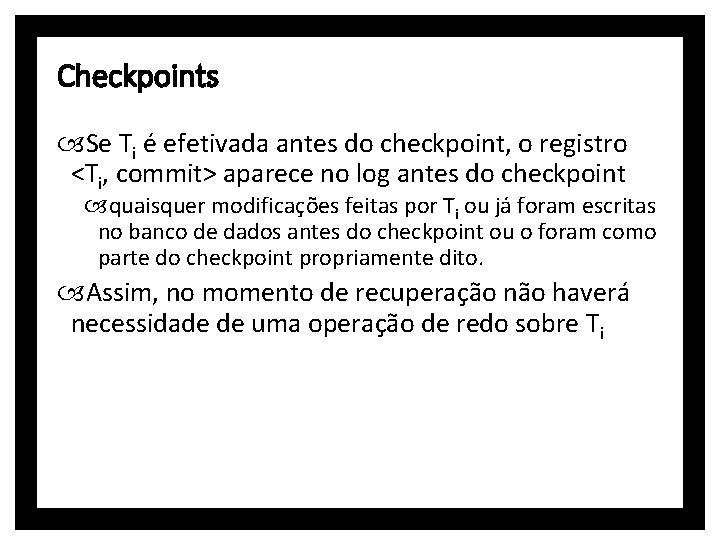
Checkpoints Se Ti é efetivada antes do checkpoint, o registro <Ti, commit> aparece no log antes do checkpoint quaisquer modificações feitas por Ti ou já foram escritas no banco de dados antes do checkpoint ou o foram como parte do checkpoint propriamente dito. Assim, no momento de recuperação não haverá necessidade de uma operação de redo sobre Ti
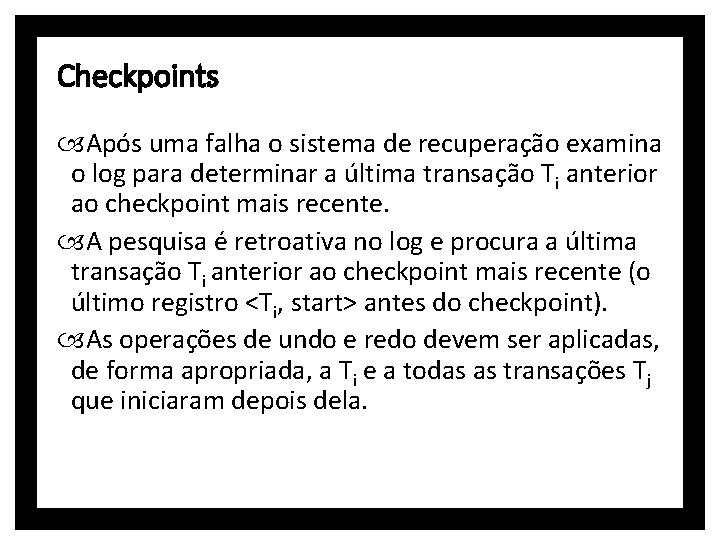
Checkpoints Após uma falha o sistema de recuperação examina o log para determinar a última transação Ti anterior ao checkpoint mais recente. A pesquisa é retroativa no log e procura a última transação Ti anterior ao checkpoint mais recente (o último registro <Ti, start> antes do checkpoint). As operações de undo e redo devem ser aplicadas, de forma apropriada, a Ti e a todas as transações Tj que iniciaram depois dela.
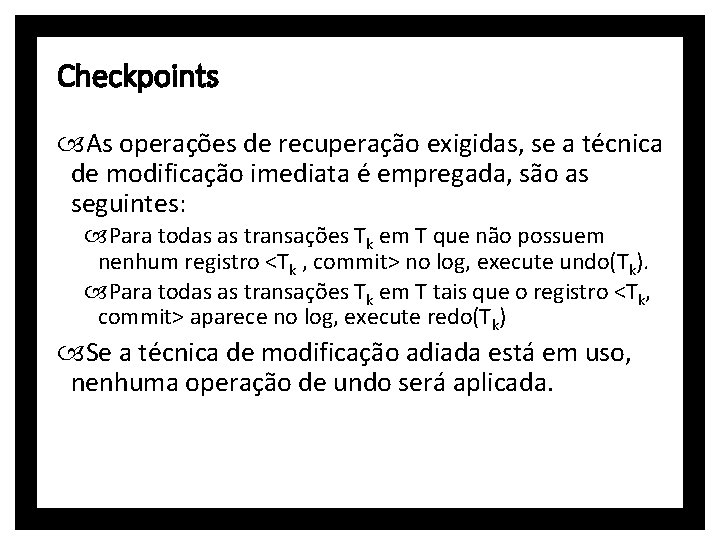
Checkpoints As operações de recuperação exigidas, se a técnica de modificação imediata é empregada, são as seguintes: Para todas as transações Tk em T que não possuem nenhum registro <Tk , commit> no log, execute undo(Tk). Para todas as transações Tk em T tais que o registro <Tk, commit> aparece no log, execute redo(Tk) Se a técnica de modificação adiada está em uso, nenhuma operação de undo será aplicada.
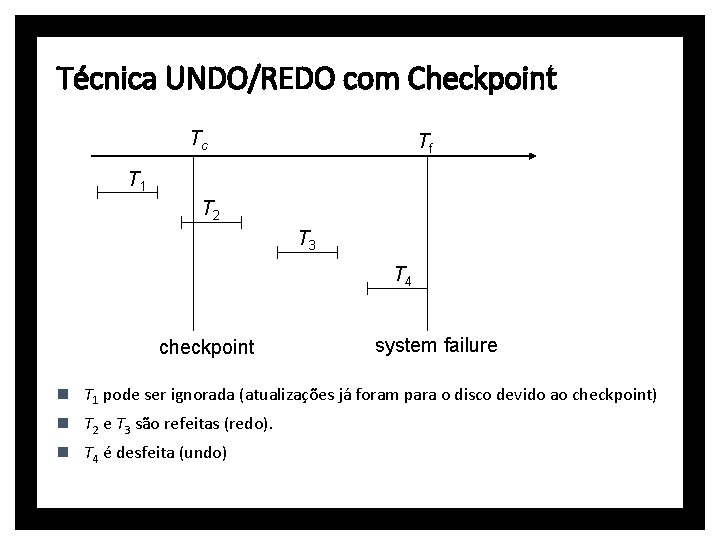
Técnica UNDO/REDO com Checkpoint Tc Tf T 1 T 2 T 3 T 4 checkpoint system failure n T 1 pode ser ignorada (atualizações já foram para o disco devido ao checkpoint) n T 2 e T 3 são refeitas (redo). n T 4 é desfeita (undo)
Exemplo (UNDO/REDO) Considere as transações {T 0, T 1, . . . T 100} executadas nesta ordem. Suponha que o checkpoint mais recente tenha ocorrido durante a execução da transação T 67. Então somente as transações T 67 até T 100 necessitam ser consideradas durante o esquema de recuperação. Cada uma delas será refeita se tiver sido efetivada. Caso contrário, será desfeita.
3. Recuperação com transações concorrentes
Interação com o controle de concorrência Suponha que uma transação T 0 tenha que ser desfeita e um item de dado Q, atualizado por T 0, tenha que recuperar seu valor antigo. Para isso, utiliza-se as informações registradas no log e a operação undo. Suponha ainda que uma segunda transação T 1 também tenha realizado uma atualização sobre Q antes de T 0 ser desfeita. Esta atualização, processada por T 1, será perdida quando T 0 for revertida. Para evitar esta situação, usa-se o bloqueio em duas fases (lock/unlock) que mantém os bloqueios de escrita até o final da transação.
Rollback da transação Reverte-se uma transação Ti que falhou usando o log da seguinte forma: 1. O log é percorrido do fim para o início; 2. Para cada registro da forma <Ti, Xj, V 1, V 2>, o item de dados Xj é restaurado para seu valor antigo V 1 X; 3. O trabalho termina quando o registro <Ti, start> é encontrado. Varredura do log ao contrário é importante pelo fato de que uma transação pode ter atualizado um item de dados mais de uma vez.
Rollback da transação Por que percorrer o log de trás para frente? Considere o exemplo: < Ti, A, 10, 20> < Ti, A, 20, 30> Os registros de log representam uma modificação do item de dados A por Ti seguida por outra modificação de Ti. A varredura do log ao contrário define A corretamente para 10. Se o log fosse varrido na direção normal, A seria definido como 20, o que seria incorreto.
Protocolo bloqueio x reversão Quando se está revertendo uma transação, o protocolo de bloqueio deve manter os bloqueios de escrita da transação, até que o trabalho de reversão seja concluído. Como se está supondo o uso do protocolo de bloqueio em duas fases estrito (lock/unlock exclusivo), nenhuma outra transação terá que ser revertida por ocasião da reversão de outra transação.
Checkpoints Para situações onde a concorrência não existe, o uso dos checkpoints faz com que na recuperação se considere: As transações que iniciaram após o checkpoint mais recente; A transação, se houver alguma, que estava ativa no momento da escrita do checkpoint mais recente. Quando existe concorrência, várias transações podem estar ativas no momento em que o checkpoint for inserido no log. Assim, o registro de log referente ao checkpoint será da forma <checkpoint L>, onde L é a lista de transações ativas no momento de inserção do checkpoint
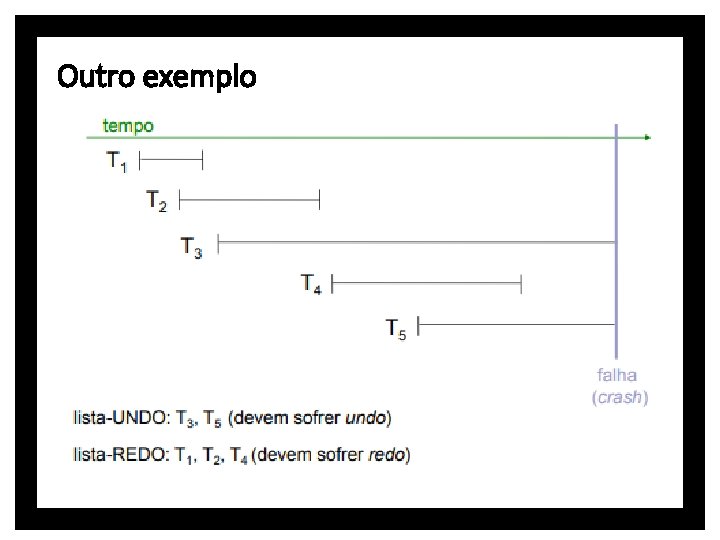
Recuperação na partida Para a recuperação com transações concorrentes, o sistema deverá construir duas listas: Lista desfazer (undo-list): composta por transações que devem ser inutilizadas. Lista refazer (redo-list): composta por transações que devem ser refeitas.
Construção das listas Inicialmente, ambas as listas estão vazias; Examina-se o log, de trás pra frente, até o primeiro checkpoint: Para cada registro <Ti, commit>, adiciona-se Ti à lista refazer (redo). Para cada registro <Ti, start>, se Ti não está na lista refazer, adiciona-se Ti na lista desfazer (undo). Verifica-se a lista L no registro do checkpoint em questão. Para cada transação Ti em L, se Ti não estiver da lista refazer, então será adicionada à lista desfazer.
Recuperação na partida Log é varrido em ordem cronológica decrescente para undo Reexaminar o log a partir do registro mais recente e processar um UNDO para cada registro de log pertencente à transação Ti na lista desfazer. O exame pára quando os registros <Ti start>, para cada transação Ti da lista desfazer, são encontrados; Localizar o registro <checkpoint L> mais recente; Examinar o log a partir do registro <checkpoint L> encontrado, até o final do log e executar um REDO para cada registro de log pertencente a uma transação Ti que está na lista refazer. Log é varrido em ordem cronológica crescente para undo
Por que desfazer antes de refazer? Suponha que o item de dado A tenha inicialmente o valor 10 e que uma transação Ti tenha atualizado o item de dado A para 20 e depois foi abortada. A reversão da transação restauraria o valor de A para 10. Suponha que outra transação Tj tenha atualizado o item de dado A para 30 e tenha sido efetivada. Em seguida o sistema cai e o estado do log é: <Ti, A, 10, 20> <Tj, A, 10, 30> <Tj, commit> Se o passo REDO for processado primeiro, A será ajustado para 30 e, no passo UNDO, será ajustado para 10, sendo que o valor que deve permanecer em A é 30.
Outro exemplo
4. Gerenciamento de Buffer
Buffering de registro de log Registros de logs são buferizados na memória principal ao invés de serem enviados diretamente ao stable storage. Registros de logs são armazenados no stable storage quando um bloco de registros de log no buffer está cheio ou quando log force é executada. Log force é executada para confirmar uma transação, forçando o envoi de todos seus log records (incluindo o registro de commit) ao stable storage. Para reduzir os custos de I/O, vários registros de log podem ser enviados ao stable storage em uma única operação de output.
Buffering de registro de log As seguintes regras devem ser seguidas se registros de log estão buferizados: 1. Registros de log são enviado ao stable storage na ordem em que foram criados; 2. Transação Ti passa para o estado “confirmada” somente quando o registro de log <Ti commit> foi enviado ao stable storage; 3. Antes que um bloco de dados na memória principal seja enviado ao stable storage, todos registros de log associados ao dado contido no bloco precisam ter sido enviados ao stable storage. Esta regra é chamada write-ahead logging ou regra WAL
Buffering de banco de dados Como parte do BD está na memória principal, quando um novo bloco é necessário, se o buffer estiver cheio então um bloco existente precisa ser removido do buffer Se o bloco escolhido para ser removido foi atualizado, então ele deve ser enviado ao stable storage (output deve ser executado) Sequência de ações: 1. Enviar registros de log ao stable storage até que todos os registros de log pertencentes ao bloco B 1 tenham sido enviados 2. Enviar bloco B 1 para o disco 3. Trazer o bloco B 2 do disco para a memória principal
Buffering de banco de dados Enquanto as ações anteriores são executadas: Nenhuma escrita no bloco B 1 pode estar em andamento Antes que a transação realize uma escrita sobre um item de dado, ela precisa de um bloqueio exclusivo sobre o bloco no qual o item de dado reside Bloqueio é liberado imediatamente após a realização da atualização Antes que o sistema envie um bloco para stable storage, ele também precisa de um bloqueio exclusivo sobre o bloco para garantir que nenhuma transação o está atualizado Bloqueio liberado quando a saída do bloco for completada Bloqueios exclusivos (latches) protegem estrutura de dados na memória enquanto locks protegem conteúdo de banco de dados
Buffering de banco de dados Ações para enviar um bloco ao stable storage 1. Obter um latch exclusive sobre o bloco Garante que nenhuma atualização esteja ocorrendo no bloco 2. Executar um log flush 3. Enviar o bloco ao disco 4. Liberar o latch sobre o bloco
Falhas com perda no armazenamento não-volátil Para lidar com a perda de dados no armazenamento não volátil, pode-se usar uma técnica similar ao checkpointing Periodicamente realizer um dump do banco de dados no stable storage Nenhuma transação pode estar ativa durante o dump Ações similares às de checkpointing precisarão ser executadas: Enviar todos os registros de log do buffer para o stable storage. Enviar todos os buffer blocks ao disco. Copiar o conteúdo do database para o stable storage. Enviar um registro de log <dump> ao stable storage. Para recuperar-se de falhas de disco Recuperar o banco de dados do dump mais recente. Consultar o log e refazer todas as transações que foram confirmadas após o dump Dumps difusos – permitem que transações estejam ativas mesmo quando dumps estão sendo feitos
5. Sistemas de backup remoto
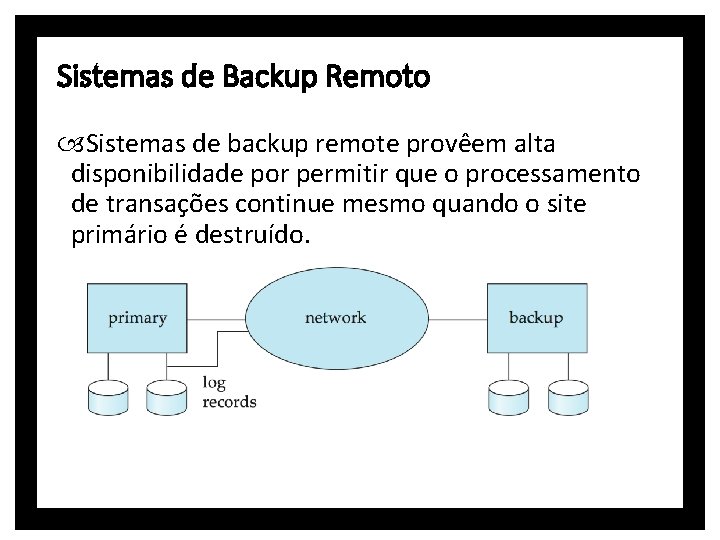
Sistemas de Backup Remoto Sistemas de backup remote provêem alta disponibilidade por permitir que o processamento de transações continue mesmo quando o site primário é destruído.
Sistemas de Backup Remoto Detecção de falha: site backup deve detectar quando o site primário falha Para distinguir falha do site primário de falha de link são mantidos vários links entre o site primário e o backup remoto. Heart-beat messages Transferência de controle: Para tomar o controle, o site backup primeiro executa a reuperação usando sua cópia do BD e todos os registros de log que ele recebeu do primário. Assim, transações completes são refeitas e transações incompletas são desfeitas. Quando o site backup toma o controle ele se torna o novo primário Para que o controle seja transferido de volta para o primário anterior quando ele se recuperar, o nterior deve receber o log de redos e aplicar todas as atualizações localmente.
6. ARIES
ARIES Algorithms for Recovery and Isolation Exploiting Semantics (ARIES) é um algoritmo de recuperação para: melhorar a concorrência; reduzir a sobrecarga de logging reduzir o tempo de recuperação Características: Usa técnicas de redução do tempo gasto para recuperação Reduz overheads de checkpoints Evita refazer muitas operações em log que já foram aplicadas Reduz a quantidade de informações registrada em log Preço: complexidade
Trabalho para compor N 1 Escrever um artigo Algorithms for Recovery and Isolation Exploiting Semantics (ARIES) 5 páginas, no máximo Pode haver até 2 autores Entrega: até às 23: 59 do dia 02/09/2018 Template do artigo será disponibilizado na página da disciplina http: //ericagallindo. com. br/doku. php? id=disciplinas: bdii-20181: inicio Forma de envio: enviar um arquivo no formato pdf para erica. gallindo@ifce. edu. br com o assunto “BDII – Artigo ARIES” Peso: 30% da nota N 1
FIM
- Slides: 75