
Architectures Matrielles Spcialises pour la Bioinformatique Dominique Lavenier
Architectures Matérielles Spécialisées pour la Bioinformatique Dominique Lavenier CNRS / IRISA
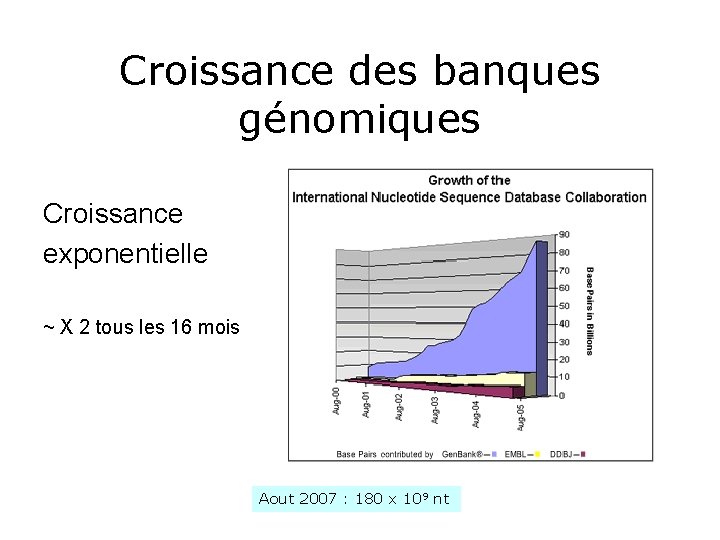
Croissance des banques génomiques Croissance exponentielle ~ X 2 tous les 16 mois Aout 2007 : 180 x 109 nt
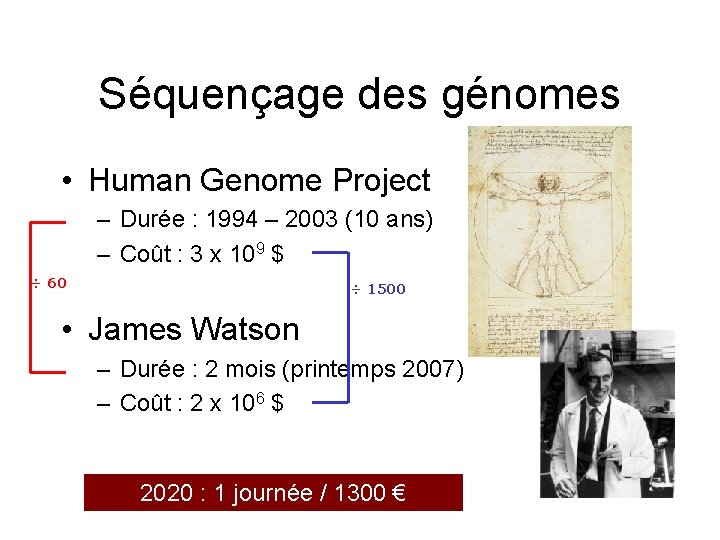
Séquençage des génomes • Human Genome Project – Durée : 1994 – 2003 (10 ans) – Coût : 3 x 10⁹ $ ÷ 60 ÷ 1500 • James Watson – Durée : 2 mois (printemps 2007) – Coût : 2 x 10⁶ $ 2020 : 1 journée / 1300 €
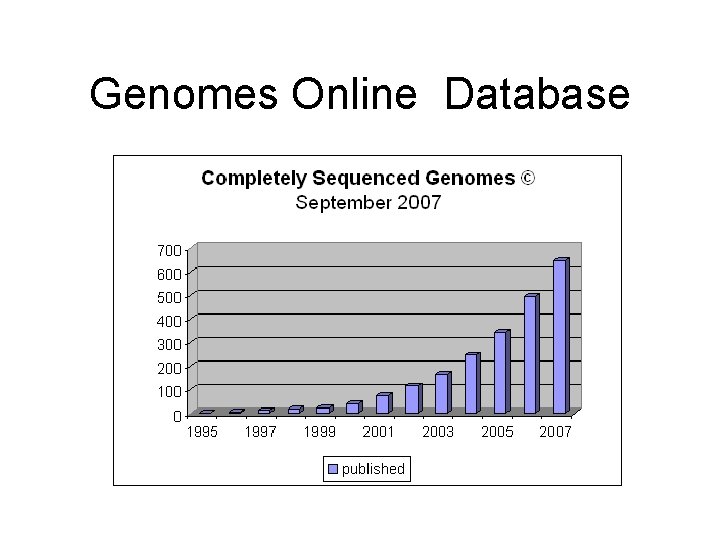
Genomes Online Database
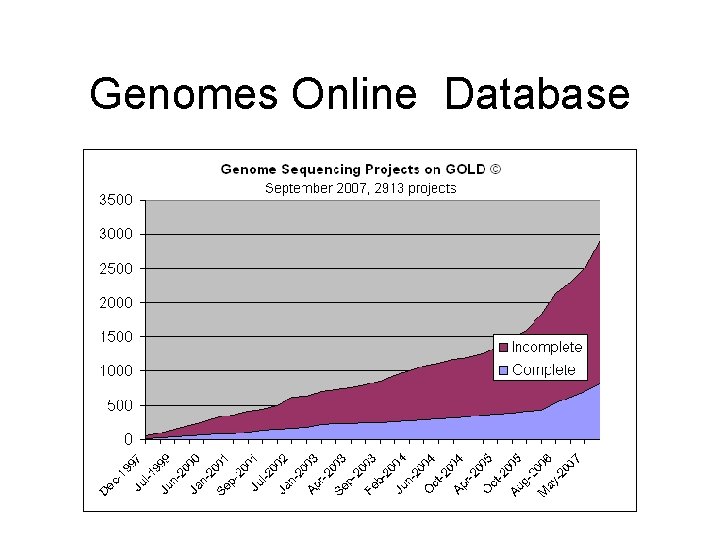
Genomes Online Database
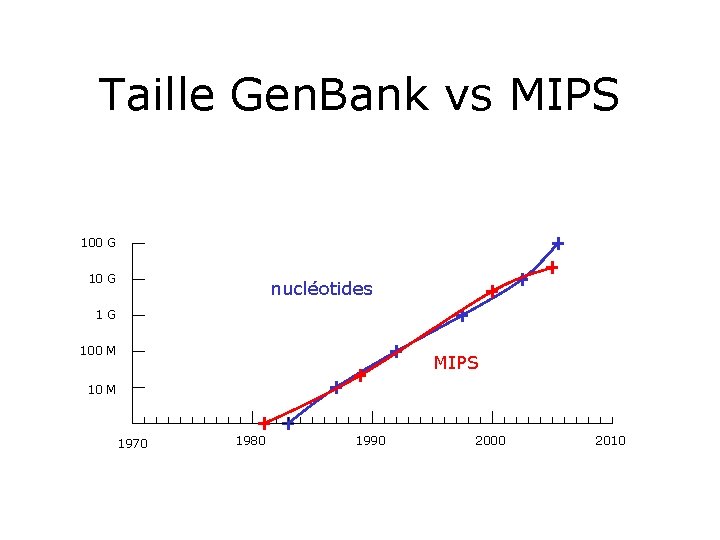
Taille Gen. Bank vs MIPS 100 G 10 G nucléotides 1 G 100 M MIPS 10 M 1970 1980 1990 2000 2010
Comparaison de séquences génomiques • Opération de base de la bioinformatique – représente 70 % des calculs des serveurs bioinformatique • Recherche par le contenu – annotations : peu fiables, pas à jour • Traitement basé sur le calcul d’une similarité entre séquences – concept de distance
Comparaison de séquences génomiques • 2 grandes familles de traitement – Recherche dans les banques • Effectuée des millions de fois chaque jours par des milliers de chercheurs – Comparaison intensive • Constitue la première étape de filtrage de la plupart des traitements bioinformatiques
Challenge Comparer des Séquences génomiques quelques secondes Requête
Plan de la présentation • Contexte – Génome, ADN, gènes, comparaison de séquences, … • Algorithme de base – Principe – Parallélisation – Accélérateur systolique • Heuristique – Principe – Mise en œuvre matérielle • Projet RDISK • Projet Re. MIX • Les recherches actuelles – Parallélisation des algorithmes sur cartes graphiques
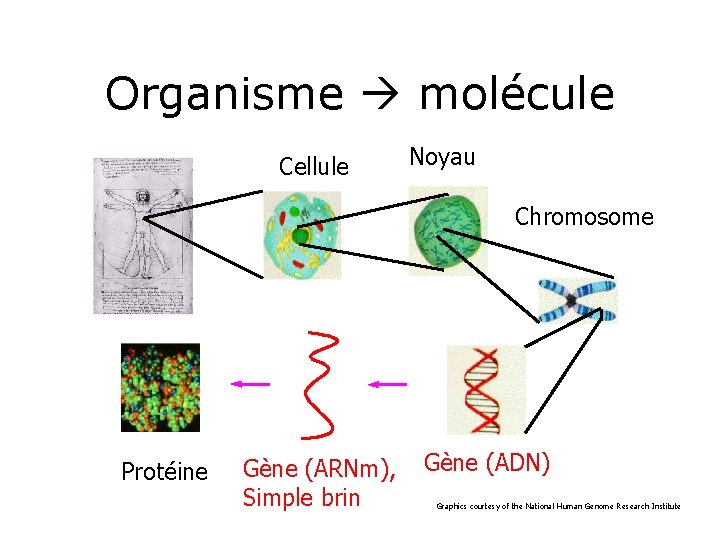
Organisme molécule Cellule Noyau Chromosome Protéine Gène (ARNm), Simple brin Gène (ADN) Graphics courtesy of the National Human Genome Research Institute
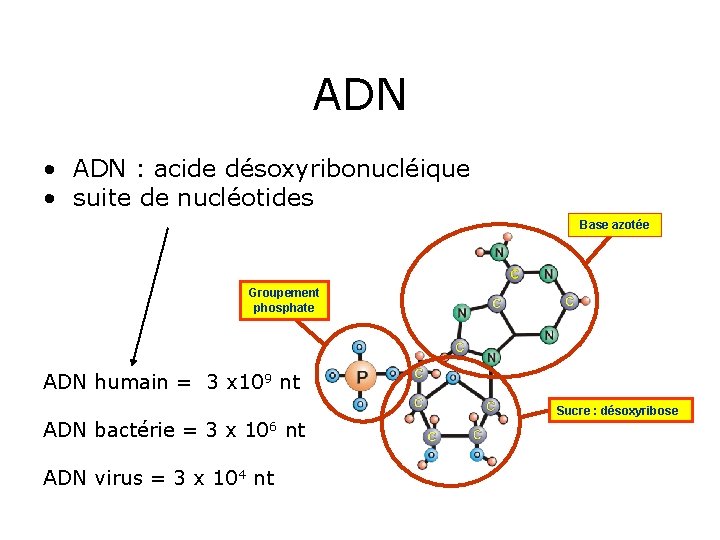
ADN • ADN : acide désoxyribonucléique • suite de nucléotides Base azotée Groupement phosphate ADN humain = 3 x 10⁹ nt ADN bactérie = 3 x 10⁶ nt ADN virus = 3 x 10⁴ nt Sucre : désoxyribose
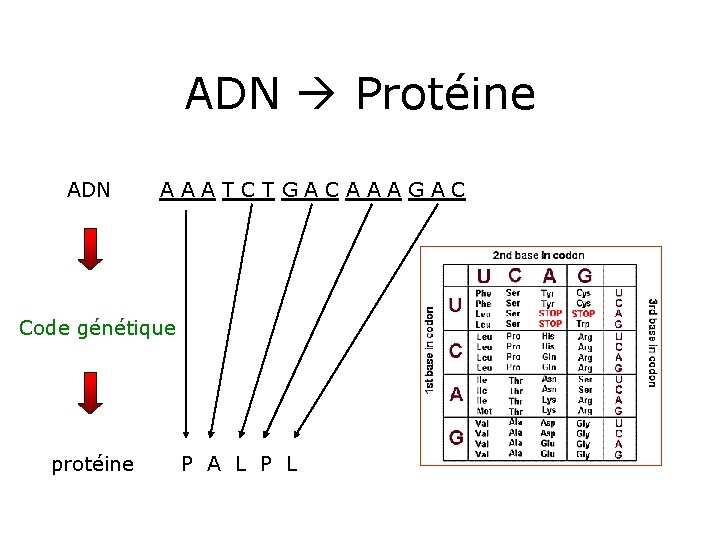
ADN Protéine ADN A A A T C T G A C A A A G A C Code génétique protéine P A L P L
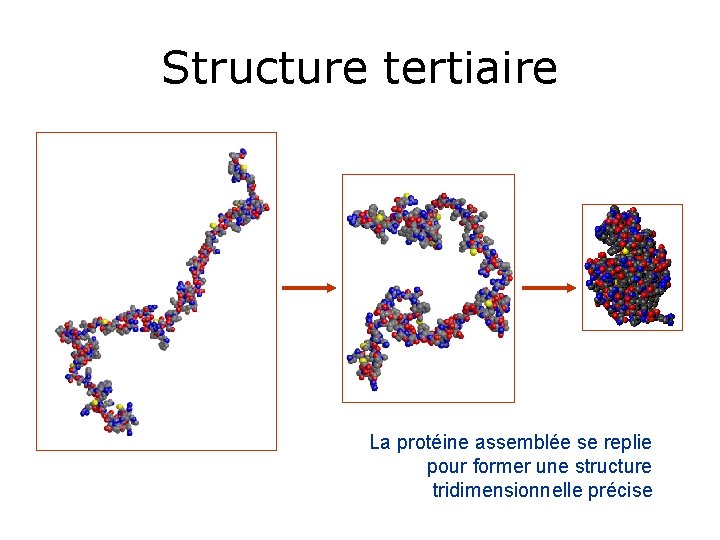
Structure tertiaire La protéine assemblée se replie pour former une structure tridimensionnelle précise
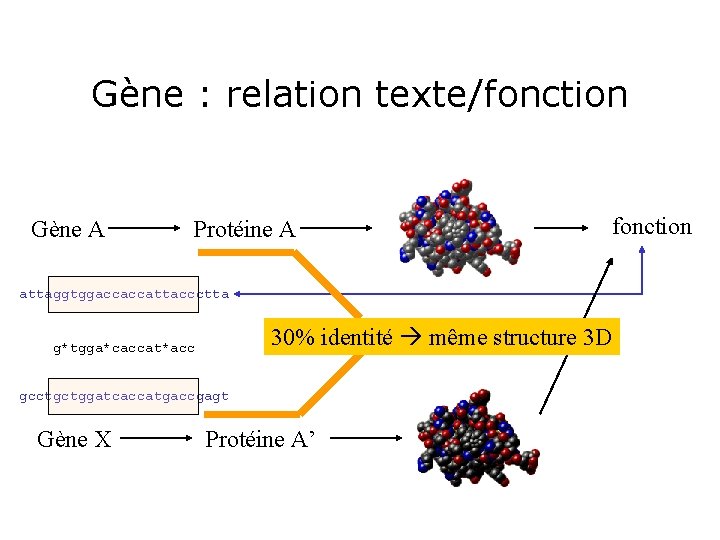
Gène : relation texte/fonction Gène A Protéine A fonction attaggtggaccaccattaccctta 30% identité même structure 3 D g*tgga*caccat*acc gcctgctggatcaccatgaccgagt Gène X Protéine A’
Plan de la présentation • Contexte – Génome, ADN, gènes, comparaison de séquences, … • Algorithme de base – Principe – Parallélisation – Accélérateur systolique • Heuristique – Principe – Mise en œuvre matérielle • Projet RDISK • Projet Re. MIX • GPU – Parallélisation des algorithmes sur cartes graphiques
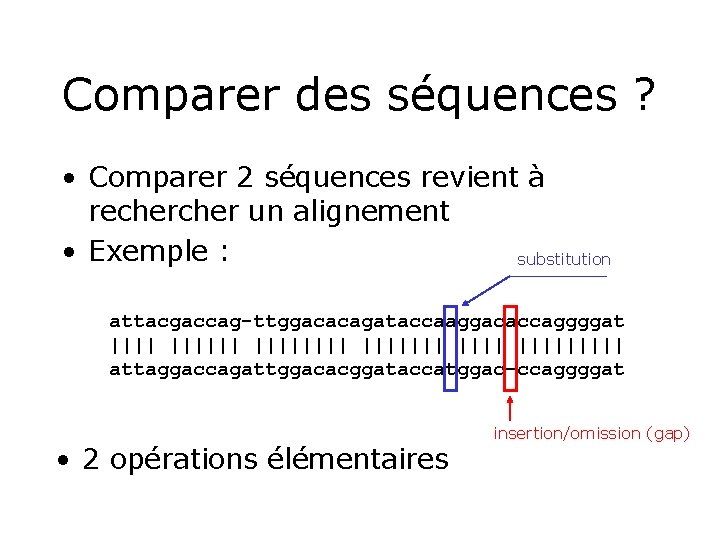
Comparer des séquences ? • Comparer 2 séquences revient à recher un alignement • Exemple : substitution attacgaccag-ttggacacagataccaaggacaccaggggat ||||||| ||||||||| attaggaccagattggacacggataccatggac-ccaggggat • 2 opérations élémentaires insertion/omission (gap)
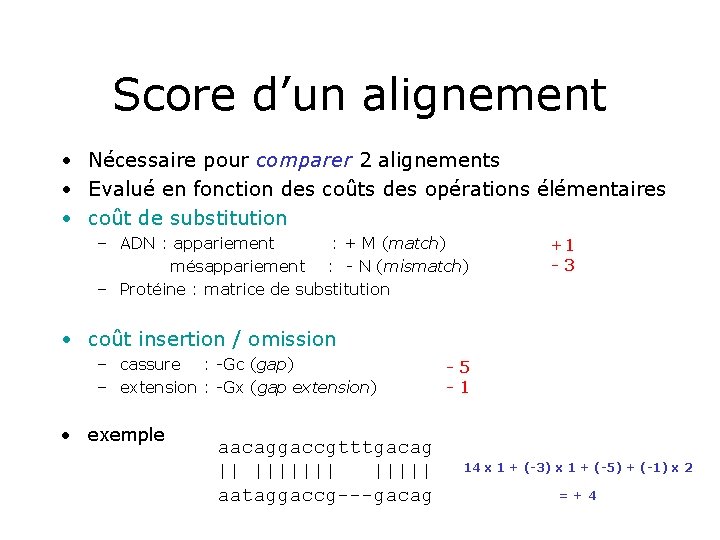
Score d’un alignement • Nécessaire pour comparer 2 alignements • Evalué en fonction des coûts des opérations élémentaires • coût de substitution – ADN : appariement : + M (match) mésappariement : - N (mismatch) – Protéine : matrice de substitution +1 -3 • coût insertion / omission – cassure : -Gc (gap) – extension : -Gx (gap extension) • exemple aacaggaccgtttgacag || ||||| aataggaccg---gacag -5 -1 14 x 1 + (-3) x 1 + (-5) + (-1) x 2 =+4
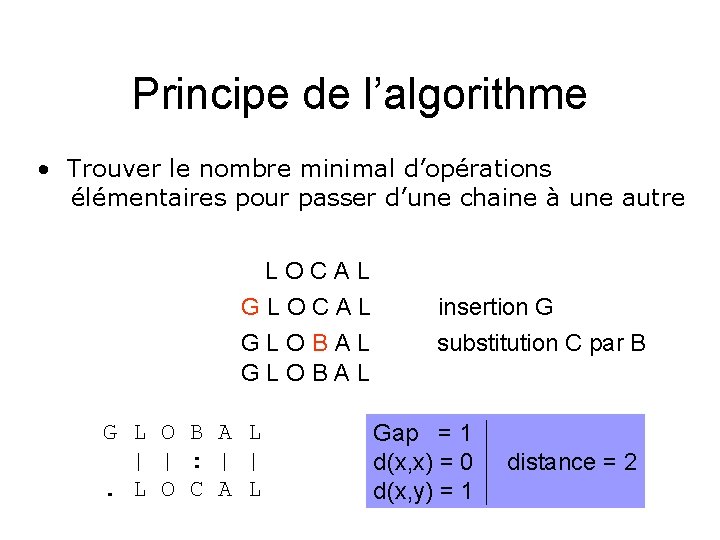
Principe de l’algorithme • Trouver le nombre minimal d’opérations élémentaires pour passer d’une chaine à une autre L O C A L G L O C A L insertion G G L O B A L substitution C par B G L O B A L | | : | |. L O C A L Gap = 1 d(x, x) = 0 distance = 2 d(x, y) = 1
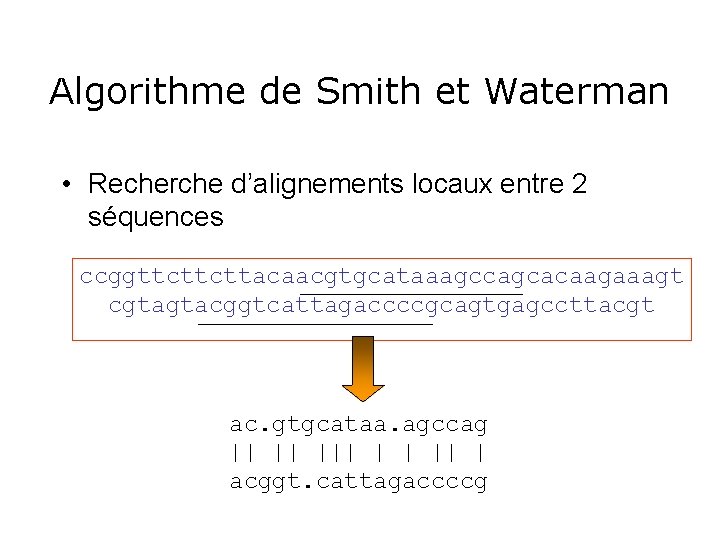
Algorithme de Smith et Waterman • Recherche d’alignements locaux entre 2 séquences ccggttcttcttacaacgtgcataaagccagcacaagaaagt cgtagtacggtcattagaccccgcagtgagccttacgt ac. gtgcataa. agccag || || | acggt. cattagaccccg
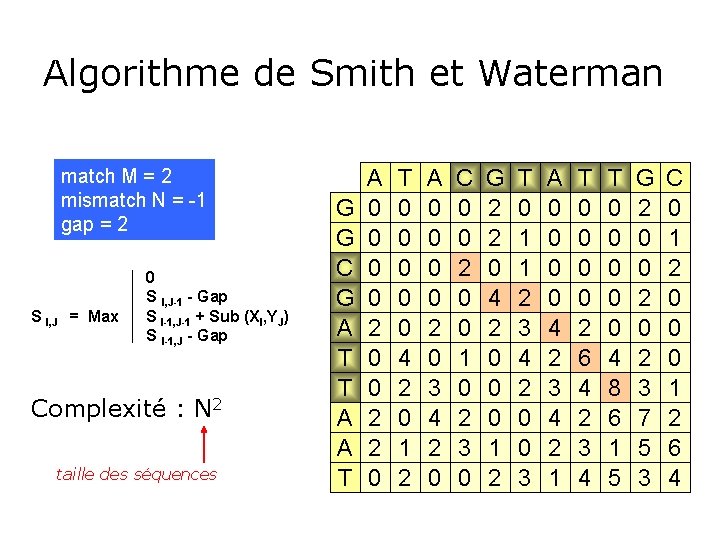
Algorithme de Smith et Waterman match M = 2 mismatch N = -1 gap = 2 S I, J = Max 0 S I, J-1 - Gap S I-1, J-1 + Sub (XI, YJ) S I-1, J - Gap Complexité : N 2 taille des séquences G G C G A T T A A T A 0 0 2 2 0 T 0 0 0 4 2 0 1 2 A 0 0 2 0 3 4 2 0 C 0 0 2 0 0 1 0 2 3 0 G 2 2 0 4 2 0 0 0 1 2 T 0 1 1 2 3 4 2 0 0 3 A 0 0 4 2 3 4 2 1 T 0 0 2 6 4 2 3 4 T 0 0 0 4 8 6 1 5 G 2 0 0 2 3 7 5 3 C 0 1 2 0 0 0 1 2 6 4
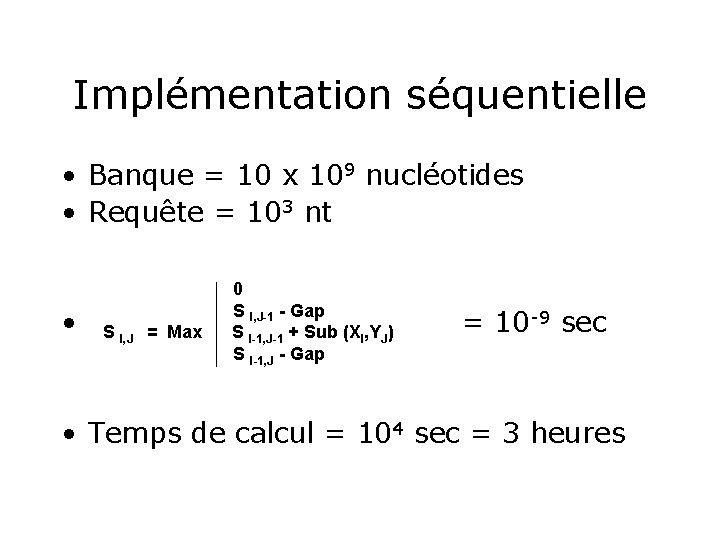
Implémentation séquentielle • Banque = 10 x 109 nucléotides • Requête = 103 nt • 0 S I, J-1 - Gap -9 sec = 10 S I, J = Max S I-1, J-1 + Sub (XI, YJ) S I-1, J - Gap • Temps de calcul = 104 sec = 3 heures
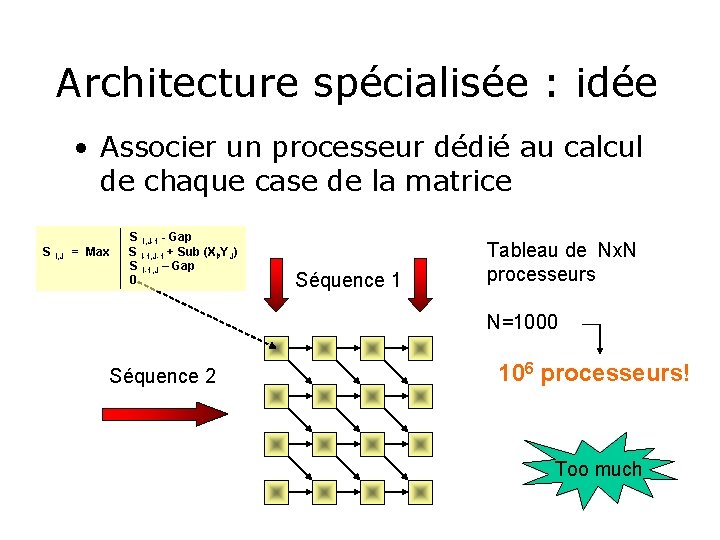
Architecture spécialisée : idée • Associer un processeur dédié au calcul de chaque case de la matrice S I, J = Max S I, J-1 - Gap S I-1, J-1 + Sub (XI, YJ) S I-1, J – Gap 0 Séquence 1 Tableau de Nx. N processeurs N=1000 Séquence 2 106 processeurs! Too much
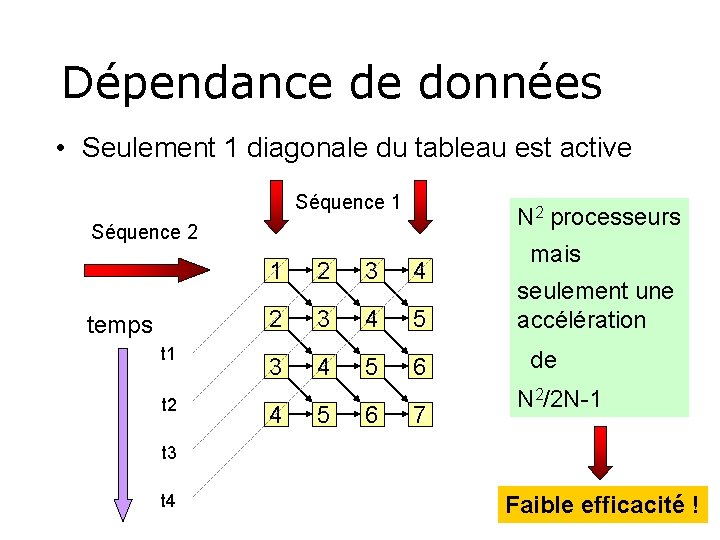
Dépendance de données • Seulement 1 diagonale du tableau est active Séquence 1 N 2 processeurs Séquence 2 temps t 1 t 2 mais 1 2 3 4 5 seulement une accélération 3 4 5 6 de 4 5 6 7 N 2/2 N-1 t 3 t 4 Faible efficacité !
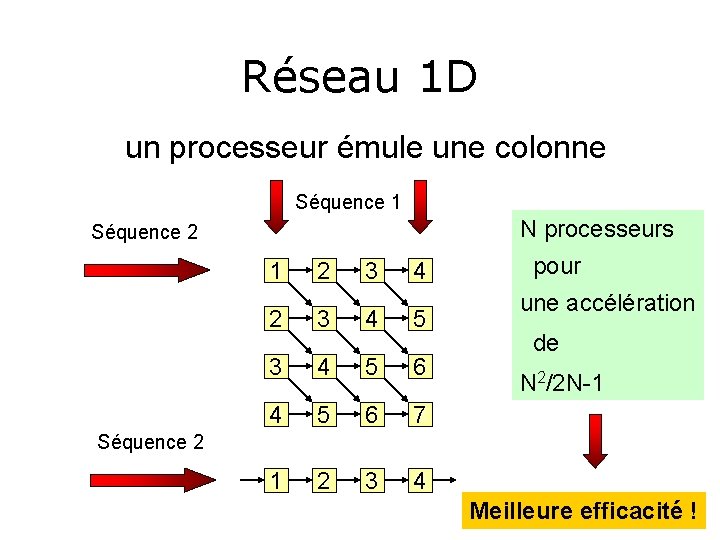
Réseau 1 D un processeur émule une colonne Séquence 1 N processeurs Séquence 2 1 2 3 4 5 6 7 1 2 3 4 pour une accélération de N 2/2 N-1 Séquence 2 Meilleure efficacité !
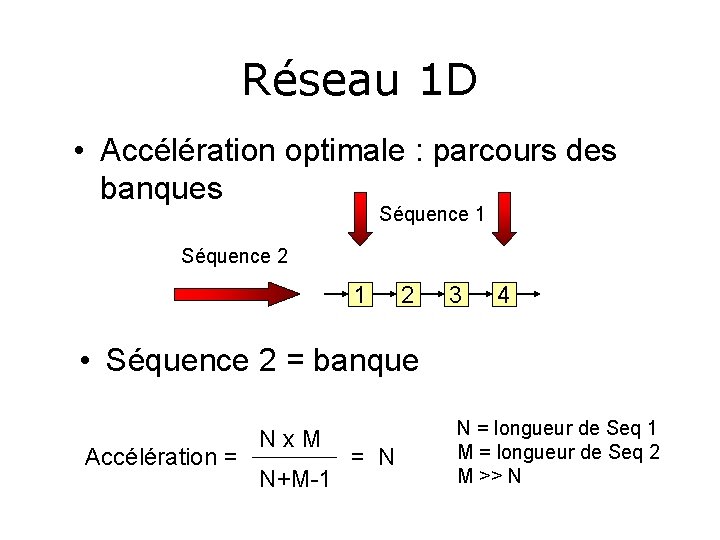
Réseau 1 D • Accélération optimale : parcours des banques Séquence 1 Séquence 2 1 2 3 4 • Séquence 2 = banque N x M Accélération = = N N+M-1 N = longueur de Seq 1 M = longueur de Seq 2 M >> N
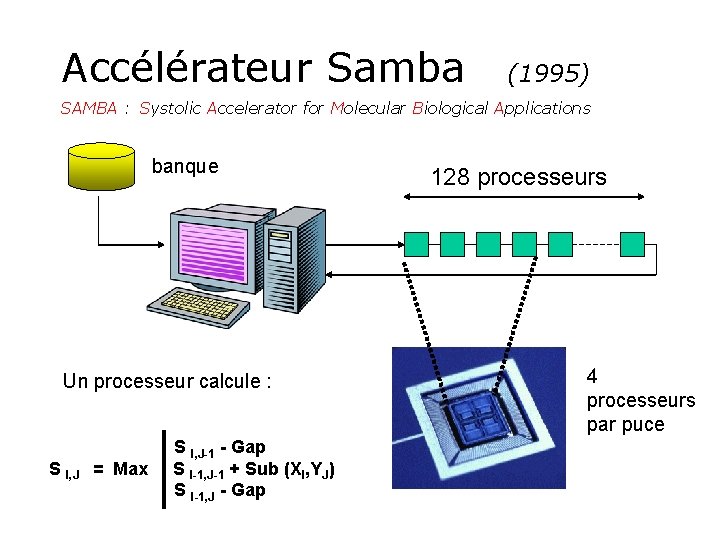
Accélérateur Samba (1995) SAMBA : Systolic Accelerator for Molecular Biological Applications banque Un processeur calcule : S I, J = Max S I, J-1 - Gap S I-1, J-1 + Sub (XI, YJ) S I-1, J - Gap 128 processeurs 4 processeurs par puce
Accélérateurs commerciaux Time Logic : De. Cypher accelerator - Technologie FPGA - parallel “reconfigurable” computer Paracel : Gene. Matcher - Technologie ASIC - Réseau 1 D de quelques milliers de processeurs CLC Cube - Technologie FPGA + USB
Plan de la présentation • Contexte – Génome, ADN, gènes, comparaison de séquences, … • Algorithme de base – Principe – Parallélisation – Accélérateur systolique • Heuristique – Principe – Mise en œuvre matérielle • Projet RDISK • Projet Re. MIX • GPU – Parallélisation des algorithmes sur cartes graphiques
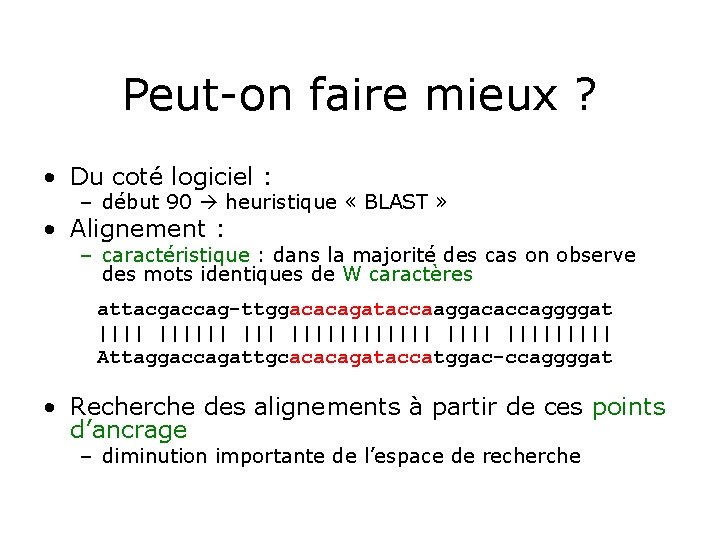
Peut-on faire mieux ? • Du coté logiciel : – début 90 heuristique « BLAST » • Alignement : – caractéristique : dans la majorité des cas on observe des mots identiques de W caractères attacgaccag-ttggacacagataccaaggacaccaggggat ||||||| ||||||||| Attaggaccagattgcacacagataccatggac-ccaggggat • Recherche des alignements à partir de ces points d’ancrage – diminution importante de l’espace de recherche
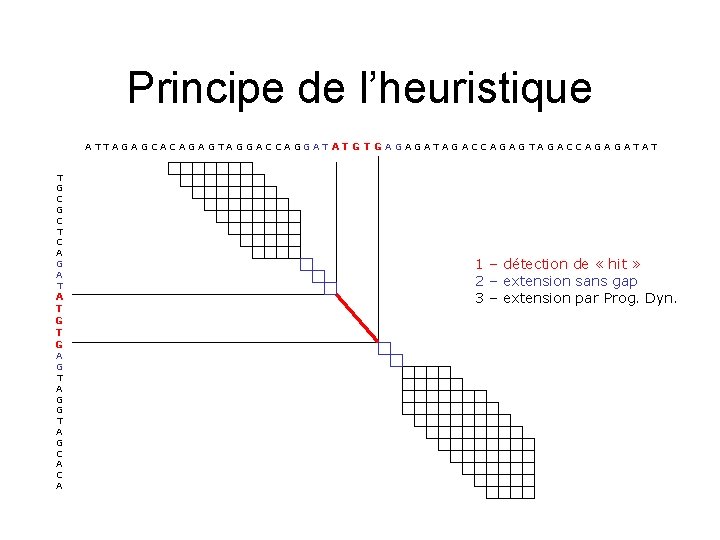
Principe de l’heuristique A T T A G C A G A G T A G G A C C A G G A T G T G A G A T A G A C C A G A G A T T G C T C A G A T G T G A G T A G C A 1 – détection de « hit » 2 – extension sans gap 3 – extension par Prog. Dyn.
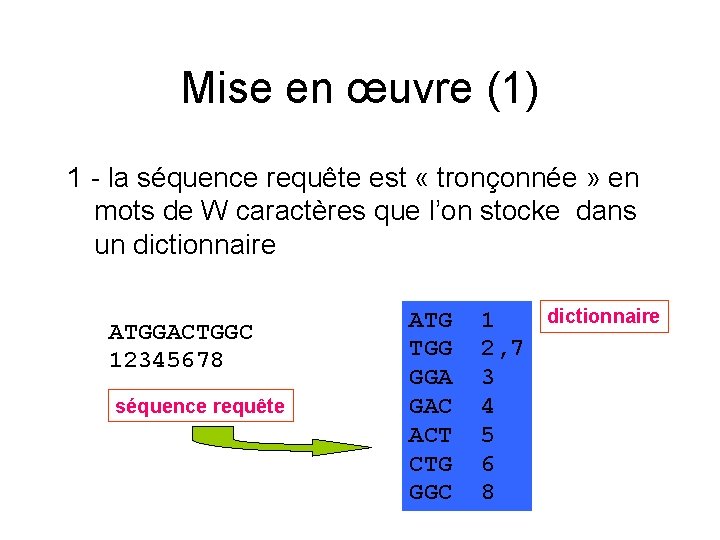
Mise en œuvre (1) 1 - la séquence requête est « tronçonnée » en mots de W caractères que l’on stocke dans un dictionnaire ATGGACTGGC 12345678 séquence requête ATG TGG GGA GAC ACT CTG GGC dictionnaire 1 2, 7 3 4 5 6 8
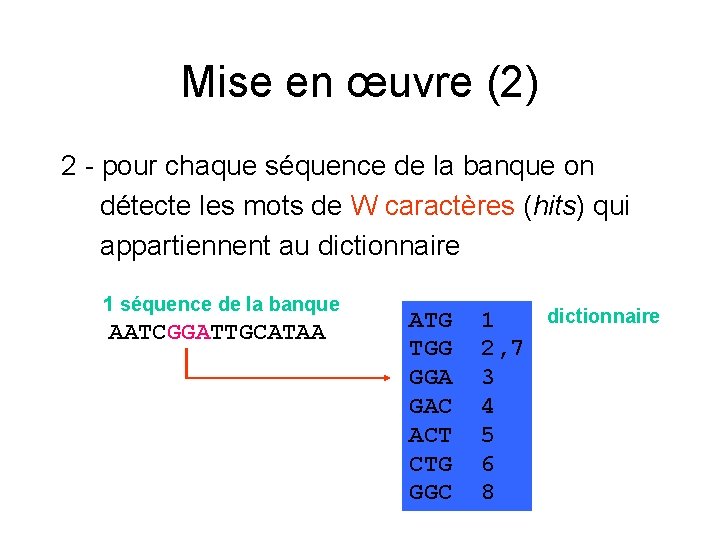
Mise en œuvre (2) 2 - pour chaque séquence de la banque on détecte les mots de W caractères (hits) qui appartiennent au dictionnaire 1 séquence de la banque AATCGGATTGCATAA ATG TGG GGA GAC ACT CTG GGC dictionnaire 1 2, 7 3 4 5 6 8
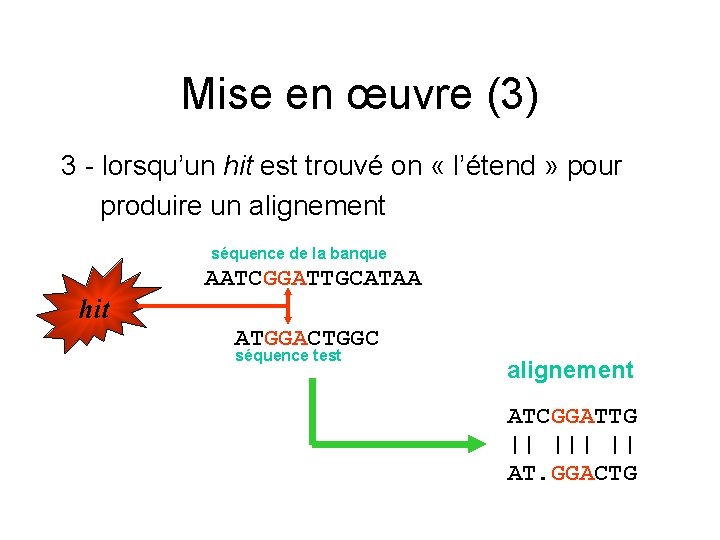
Mise en œuvre (3) 3 - lorsqu’un hit est trouvé on « l’étend » pour produire un alignement séquence de la banque AATCGGATTGCATAA hit ATGGACTGGC séquence test alignement ATCGGATTG || || AT. GGACTG
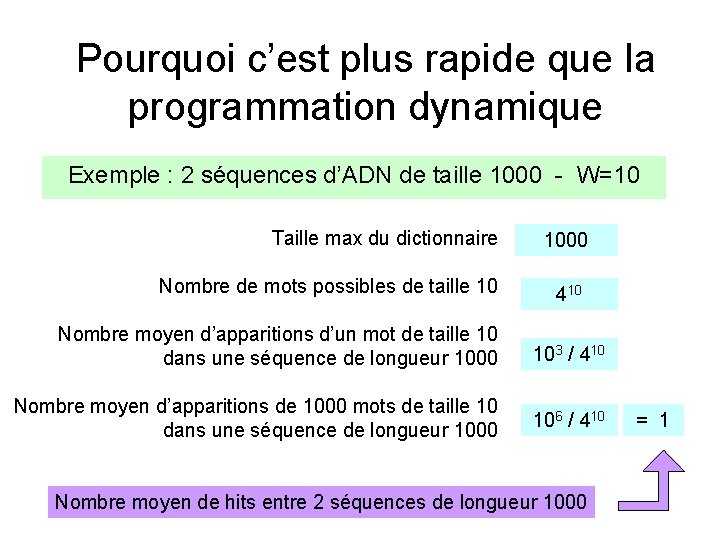
Pourquoi c’est plus rapide que la programmation dynamique Exemple : 2 séquences d’ADN de taille 1000 - W=10 Taille max du dictionnaire Nombre de mots possibles de taille 10 1000 410 Nombre moyen d’apparitions d’un mot de taille 10 dans une séquence de longueur 1000 103 / 410 Nombre moyen d’apparitions de 1000 mots de taille 10 dans une séquence de longueur 1000 106 / 410 Nombre moyen de hits entre 2 séquences de longueur 1000 = 1
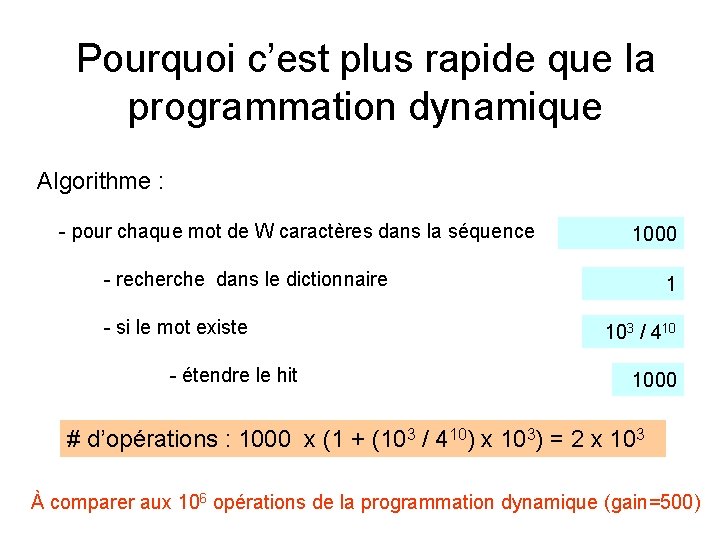
Pourquoi c’est plus rapide que la programmation dynamique Algorithme : - pour chaque mot de W caractères dans la séquence - recherche dans le dictionnaire - si le mot existe - étendre le hit 1000 1 103 / 410 1000 # d’opérations : 1000 x (1 + (103 / 410) x 103) = 2 x 10³ À comparer aux 106 opérations de la programmation dynamique (gain=500)
BLAST • Le programme le plus utilisé en bioinformatique • Avantages – Donne des résultats satisfaisants – Rapide • Inconvénients – Sensibilité dépend du paramètre W – Parcours systématique de la banque
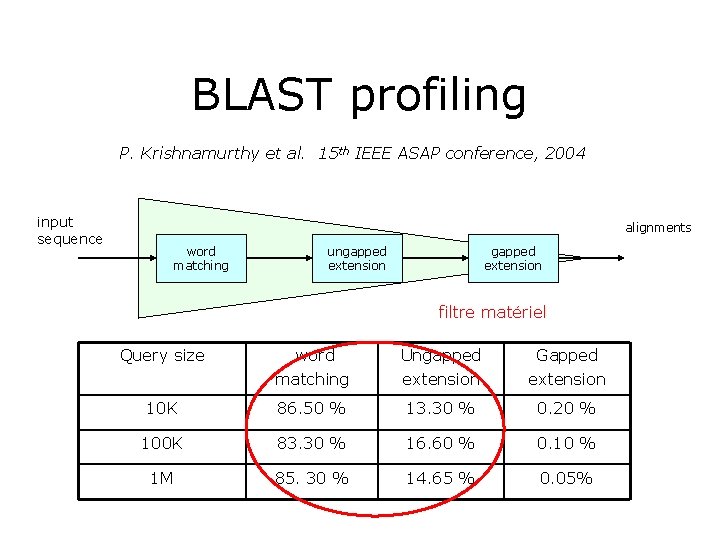
BLAST profiling P. Krishnamurthy et al. 15 th IEEE ASAP conference, 2004 input sequence alignments word matching ungapped extension filtre matériel Query size word matching Ungapped extension Gapped extension 10 K 86. 50 % 13. 30 % 0. 20 % 100 K 83. 30 % 16. 60 % 0. 10 % 1 M 85. 30 % 14. 65 % 0. 05%
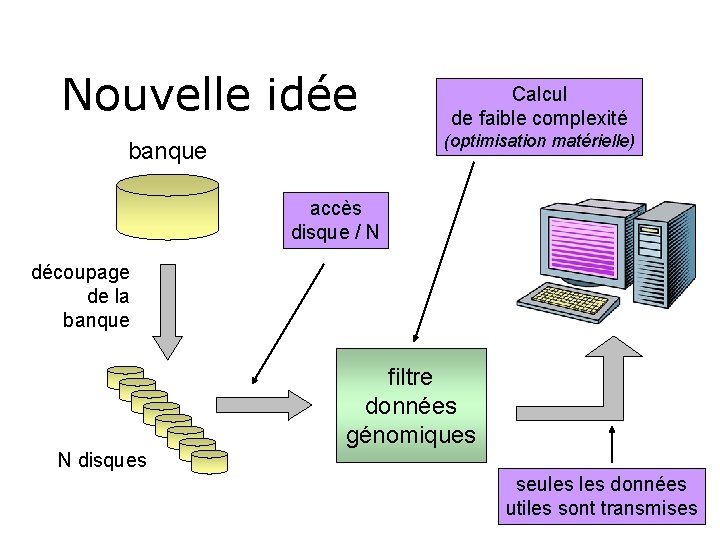
Nouvelle idée Calcul de faible complexité (optimisation matérielle) banque accès disque / N découpage de la banque filtre données génomiques N disques seules données utiles sont transmises
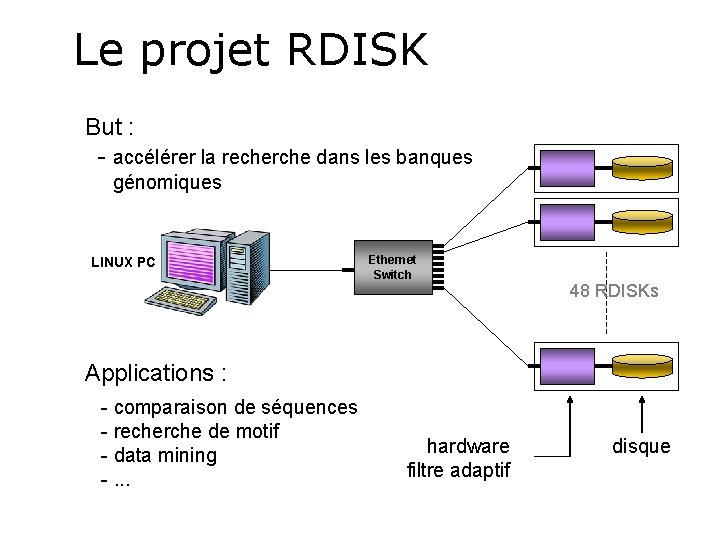
Le projet RDISK But : - accélérer la recherche dans les banques génomiques LINUX PC Ethernet Switch 48 RDISKs Applications : - comparaison de séquences - recherche de motif - data mining -. . . hardware filtre adaptif disque
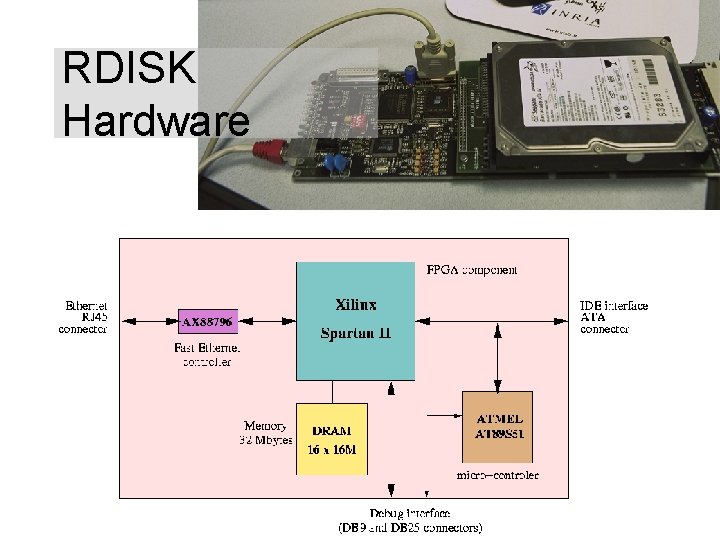
RDISK Hardware
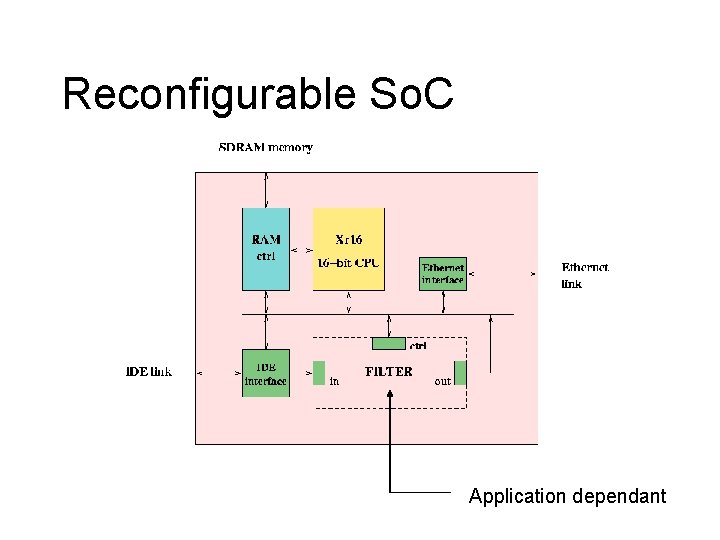
Reconfigurable So. C Application dependant
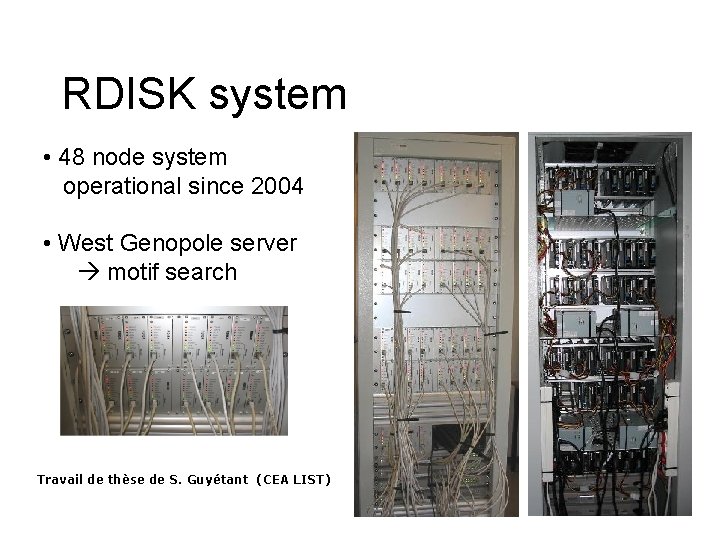
RDISK system • 48 node system operational since 2004 • West Genopole server motif search Travail de thèse de S. Guyétant (CEA LIST)
Performances • Parcours des bases de données – Génome humain : ~3 s – Recherche par le contenu (Blast) – Recherche de motifs complexes • 1 système RDISK-48 – Equivalent à un Cluster de 192 PCs – 48 fois moins cher (1 carte ~ 250 Euros) • 48 x 250 vs 192 x 3000
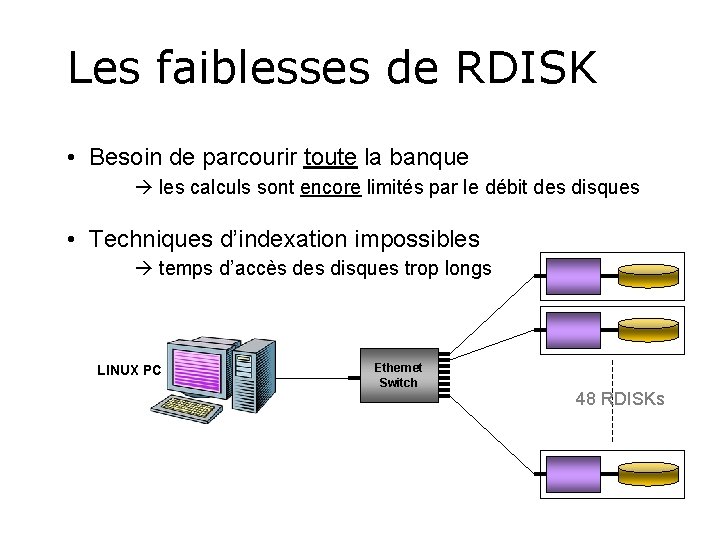
Les faiblesses de RDISK • Besoin de parcourir toute la banque les calculs sont encore limités par le débit des disques • Techniques d’indexation impossibles temps d’accès des disques trop longs LINUX PC Ethernet Switch 48 RDISKs
Indexation : i. BLAST • Idée : – Plutôt que d’indexer la requête, on indexe la banque! • Avantage – Parcours de la requête • Inconvénient – Taille de l’index – Disques trop lents
La taille de l’index • Exemple Gen. Bank – version 147 – avril 2005 – 48 x 109 nucléotides (codage sur 5 octets) Taille index = 48 x 109 x 5 = 240 Goctets Solution : concevoir une architecture matérielle spécialisée avec une grande mémoire à accès rapide
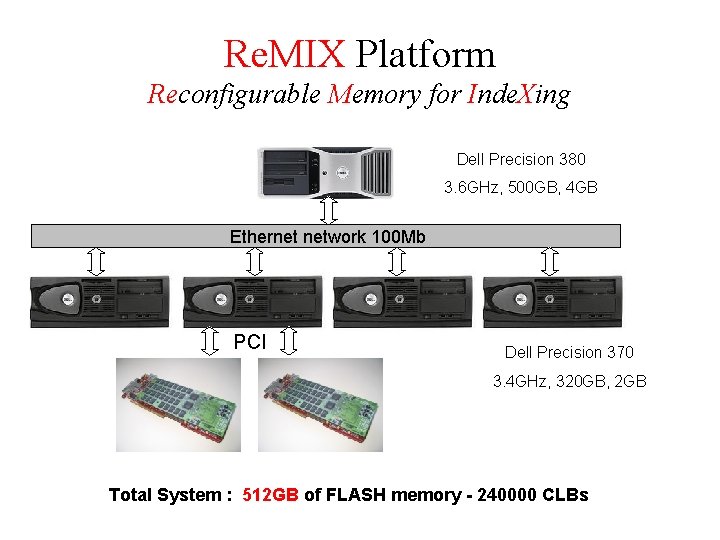
Re. MIX Platform Reconfigurable Memory for Inde. Xing Dell Precision 380 3. 6 GHz, 500 GB, 4 GB Ethernet network 100 Mb PCI Dell Precision 370 3. 4 GHz, 320 GB, 2 GB Total System : 512 GB of FLASH memory - 240000 CLBs
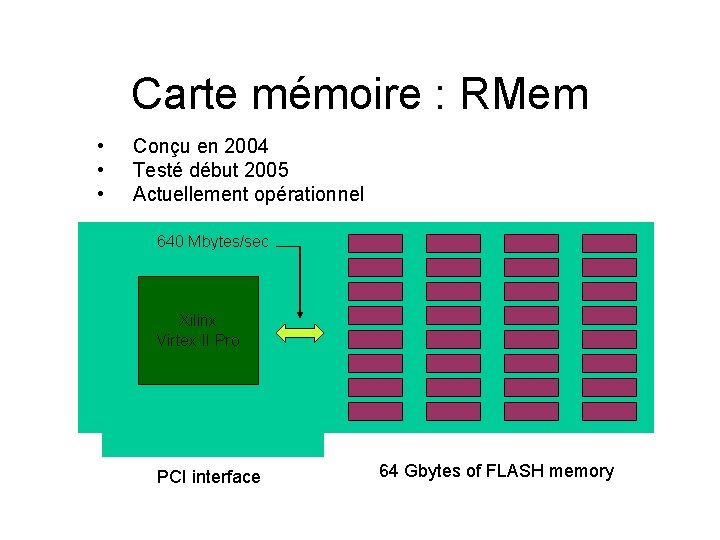
Carte mémoire : RMem • • • Conçu en 2004 Testé début 2005 Actuellement opérationnel 640 Mbytes/sec Xilinx Virtex II Pro PCI interface 64 Gbytes of FLASH memory
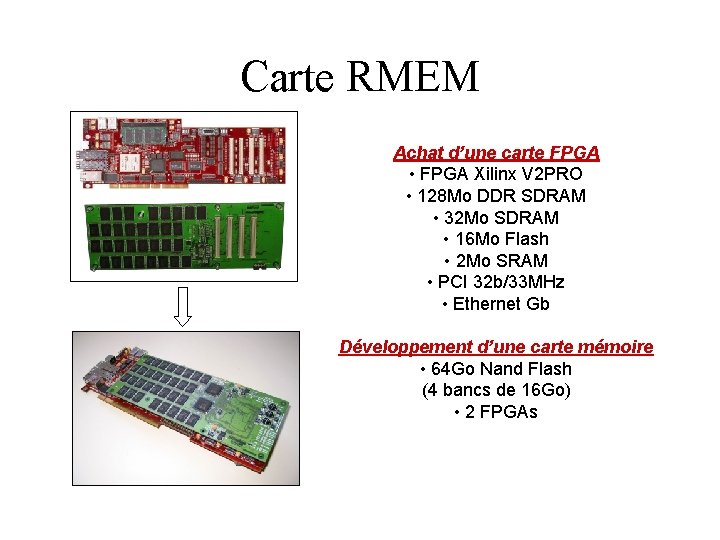
Carte RMEM Achat d’une carte FPGA • FPGA Xilinx V 2 PRO • 128 Mo DDR SDRAM • 32 Mo SDRAM • 16 Mo Flash • 2 Mo SRAM • PCI 32 b/33 MHz • Ethernet Gb Développement d’une carte mémoire • 64 Go Nand Flash (4 bancs de 16 Go) • 2 FPGAs
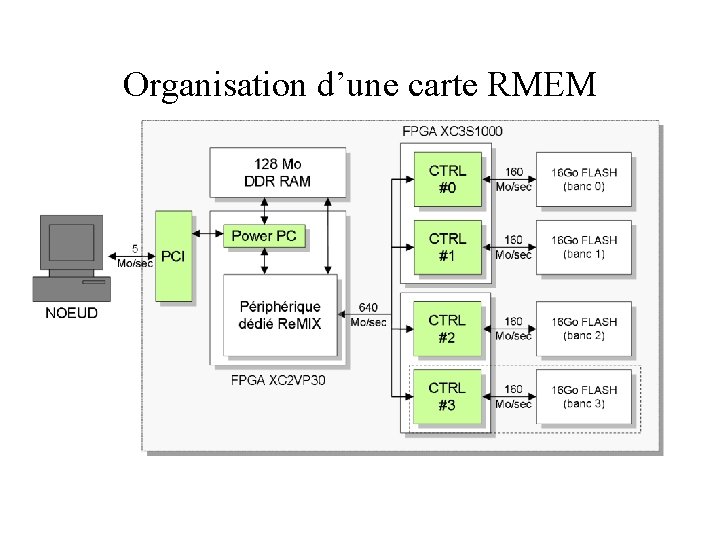
Organisation d’une carte RMEM
Re. MIX Performances - intensive sequence comparison - • Test on real bioinformatics applications • Example: Mitochondrial disease – Compare all known bacterial proteomes vs Human genome 700 000 proteins vs 3 x 10⁹ nt – Dual core processor 2. 6 GHz, 4 GBytes 16 000 hours of computation (666 days) – Re. MIX (1 board) 352 hours ( ~ 15 days) Speed-up = 44
Plan de la présentation • Contexte – Génome, ADN, gènes, comparaison de séquences, … • Algorithme de base – Principe – Parallélisation – Accélérateur systolique • Heuristique – Principe – Mise en œuvre matérielle • Projet RDISK • Projet Re. MIX • GPU – Parallélisation des algorithmes sur cartes graphiques
Pourquoi s’intéresser aux GPU ?
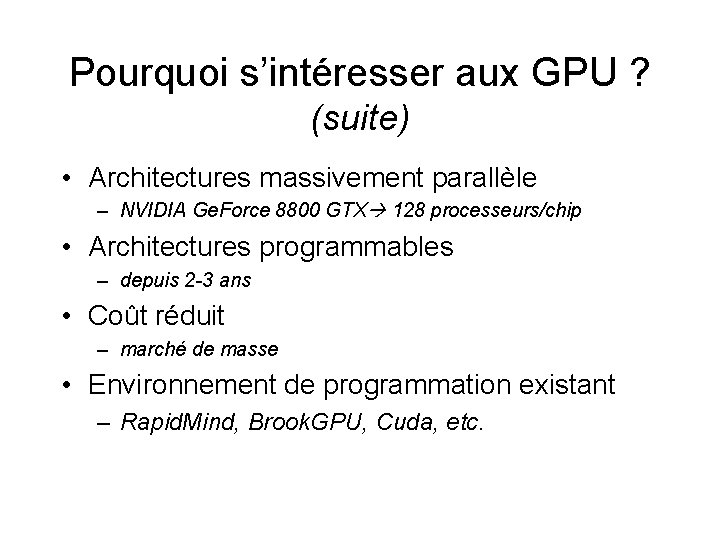
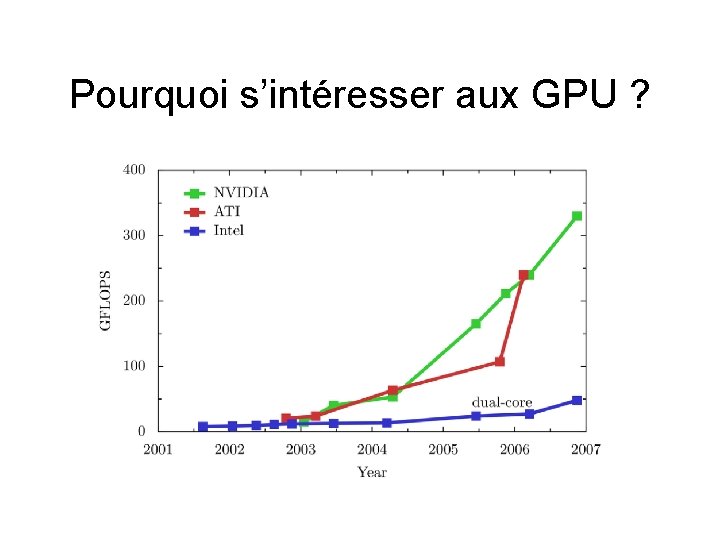
Pourquoi s’intéresser aux GPU ? (suite) • Architectures massivement parallèle – NVIDIA Ge. Force 8800 GTX 128 processeurs/chip • Architectures programmables – depuis 2 -3 ans • Coût réduit – marché de masse • Environnement de programmation existant – Rapid. Mind, Brook. GPU, Cuda, etc.
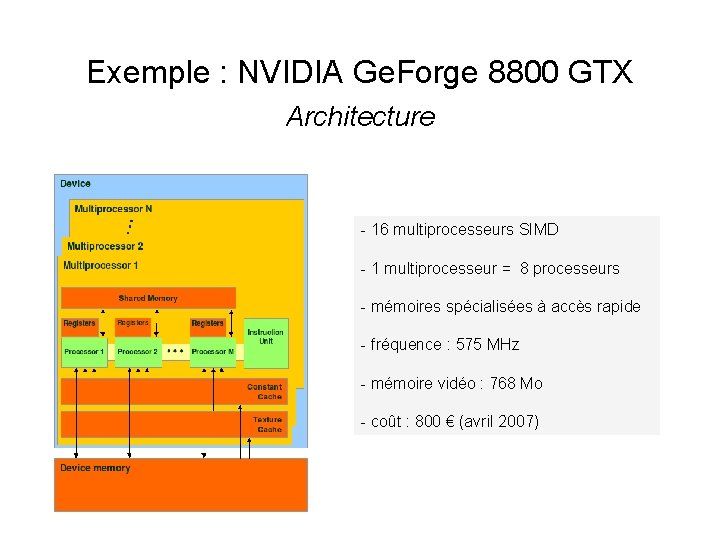
Exemple : NVIDIA Ge. Forge 8800 GTX Architecture - 16 multiprocesseurs SIMD - 1 multiprocesseur = 8 processeurs - mémoires spécialisées à accès rapide - fréquence : 575 MHz - mémoire vidéo : 768 Mo - coût : 800 € (avril 2007)
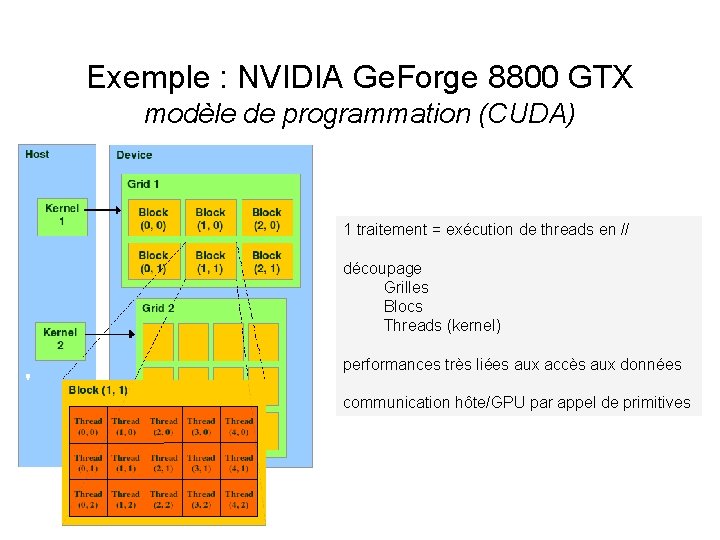
Exemple : NVIDIA Ge. Forge 8800 GTX modèle de programmation (CUDA) 1 traitement = exécution de threads en // découpage Grilles Blocs Threads (kernel) performances très liées aux accès aux données communication hôte/GPU par appel de primitives
GPU & bioinformatique • Peu d’études jusqu’à présent dans ce domaine – S&W (prog. Dyn. ) accélération X 10 – BLAST-IRISA accélération X 5 à 10 (en cours) • Calcul d’hybridation accélération X 15 • Challenge • Paralléliser les algorithmes sous une forme adaptée au modèle de programmation et à l’architecture
- Slides: 58