
ALPHA BOUBACAR DIALLO tudiant au Doctorat en Informatique
ALPHA BOUBACAR DIALLO Étudiant au Doctorat en Informatique diallo. alphaboubacar@gmail. com
Problématique et quelques définitions Architectures parallèles Environnements parallèles Programmes parallélisés Futures avenues
Taille des problèmes à résoudre Accélération de la résolution Prix…
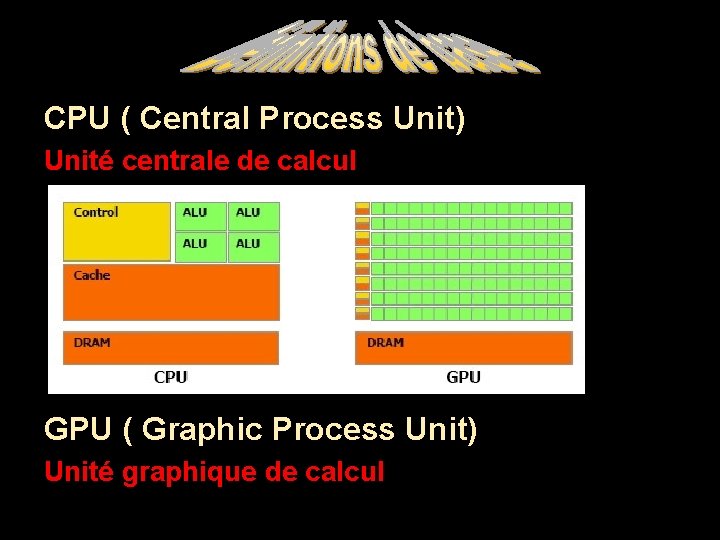
CPU ( Central Process Unit) Unité centrale de calcul GPU ( Graphic Process Unit) Unité graphique de calcul
Programme séquentiel: définit une séquence d’actions ( instructions) Programme parallèle: contient plusieurs processus qui coopèrent Système parallèle: dispose d’au moins 2 CPU ( Unité de calcul)
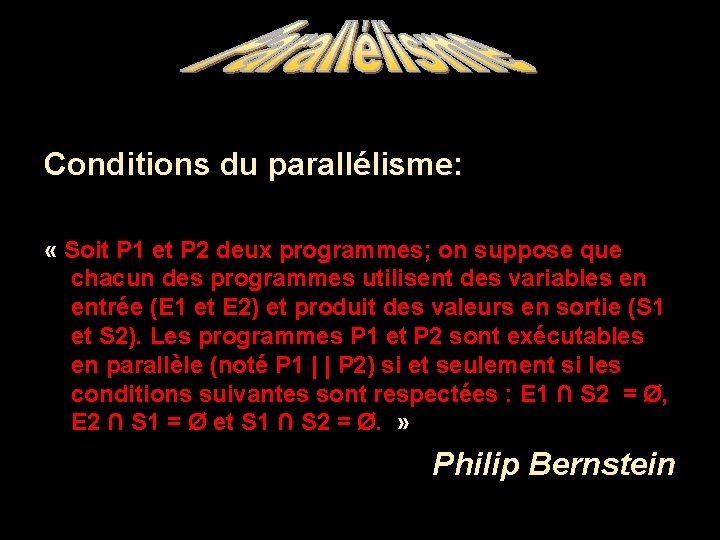
Conditions du parallélisme: « Soit P 1 et P 2 deux programmes; on suppose que chacun des programmes utilisent des variables en entrée (E 1 et E 2) et produit des valeurs en sortie (S 1 et S 2). Les programmes P 1 et P 2 sont exécutables en parallèle (noté P 1 | | P 2) si et seulement si les conditions suivantes sont respectées : E 1 ∩ S 2 = Ø, E 2 ∩ S 1 = Ø et S 1 ∩ S 2 = Ø. » Philip Bernstein
Parallélisme de données même opération effectuée par des processeurs différents sur des ensembles disjoints de données Parallélisme de contrôle différentes opérations indépendantes sont réalisées simultanément Parallélisme de flux l’opération suivante est amorcée avant que la précédente ne soit terminée
La classification de Flynn en 1972 La classification de Hockney en 1987 La classification de Treleaven en 1988 La classification de Skillicorn en 1988 La classification de Krishnamurthy en 1989 La classification de Duncan en 1990 La classification de Germain-Renaud en 1991 La classification d’Ibett en 1992 La classification d’Esclangon en 1992
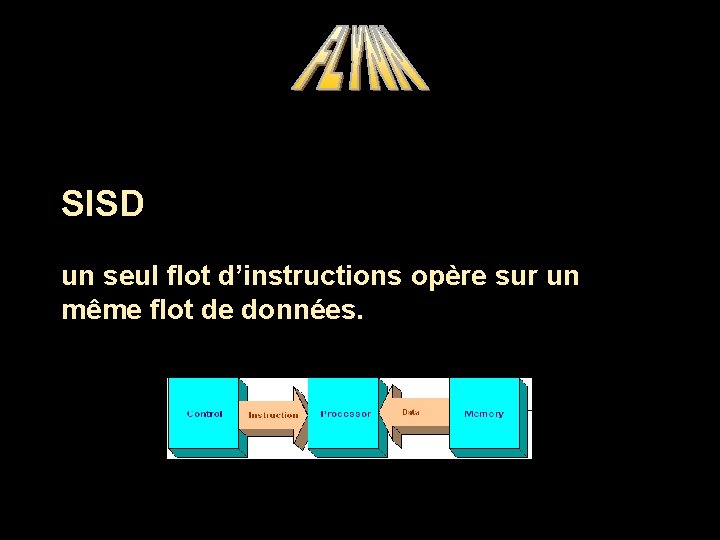
SISD un seul flot d’instructions opère sur un même flot de données.
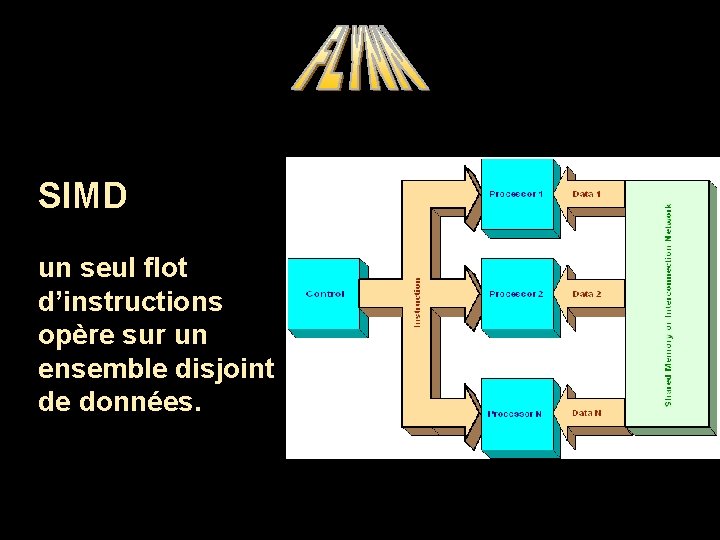
SIMD un seul flot d’instructions opère sur un ensemble disjoint de données.
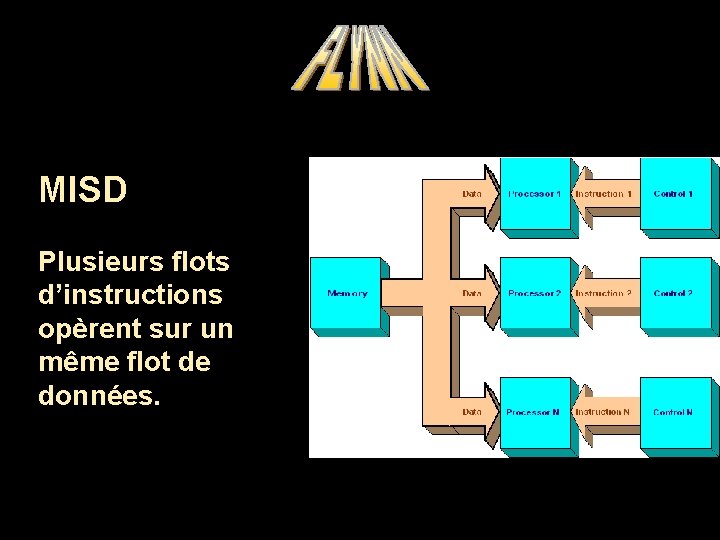
MISD Plusieurs flots d’instructions opèrent sur un même flot de données.
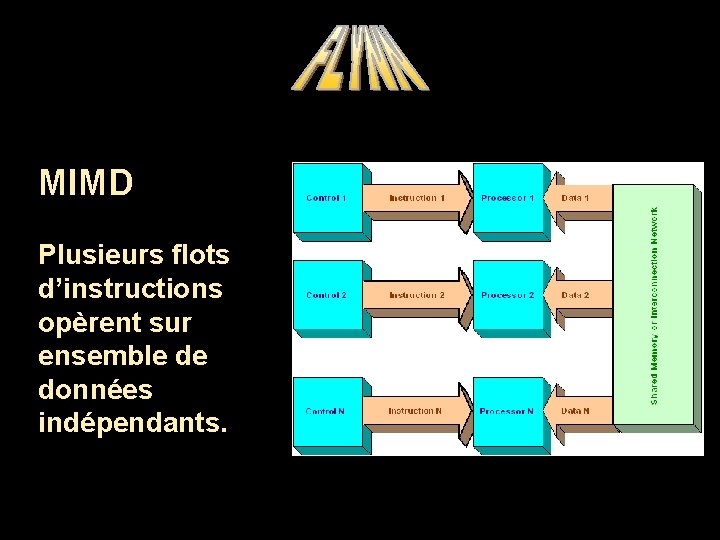
MIMD Plusieurs flots d’instructions opèrent sur ensemble de données indépendants.
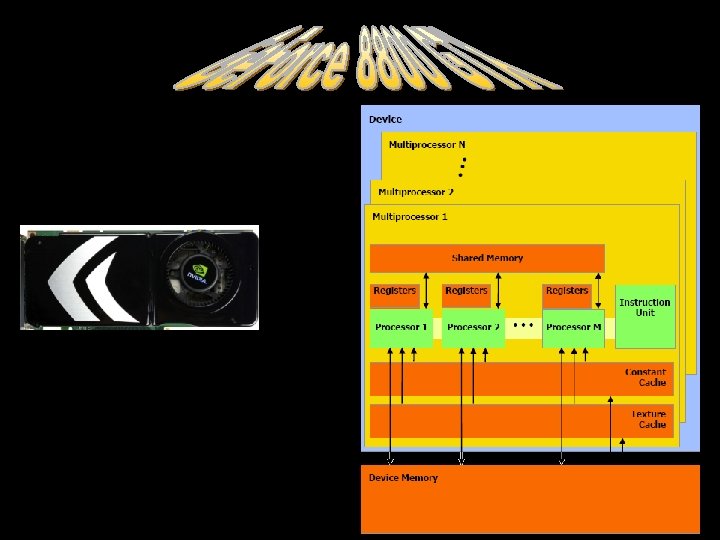
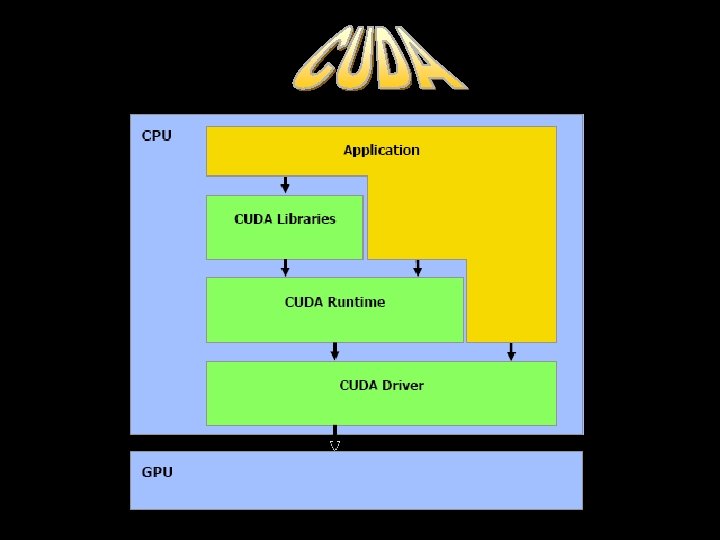
MPI (Message Passing Interface) Librairie standard de passage de messages par e d o Méth e les ll laque es de é donn oire m la mé PU C d’un es é i p o c sont la dans re oi mém tre au n u ’ d CPU CUDA (Compute Unified Device Arch. ) nouvelle architecture (logicielle et matérielle) pour la mise en œuvre et la gestion des opérations exécutées sur le GPU
MPI résulte des efforts de nombreux groupes d’individus entre les années 1992 et 1994. En avril 1992, sponsorisation d’un atelier sur les standards de passage de messages. En novembre 1992, présentation de la version MPI-1 et création du premier forum MPI. En novembre 1993 MPI standard fut dévoilé. En mai 1994 une version finale disponible.
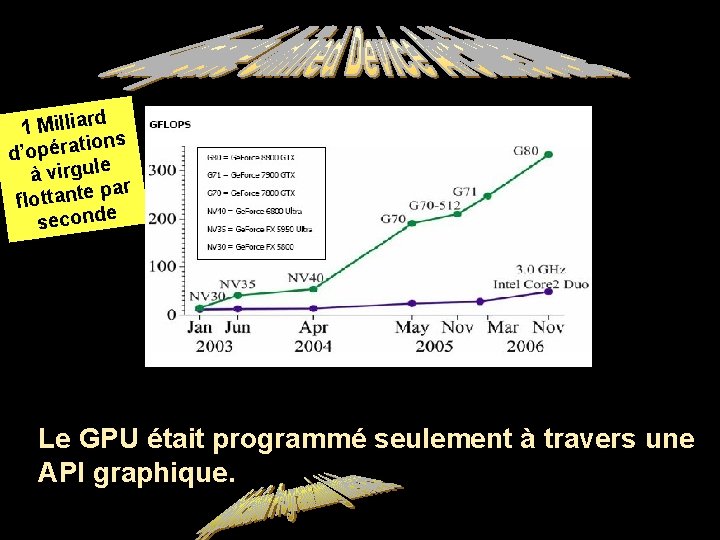
d 1 Milliar tions a r é p o ’ d à virgule par e t n a t t o l f seconde Le GPU était programmé seulement à travers une API graphique.
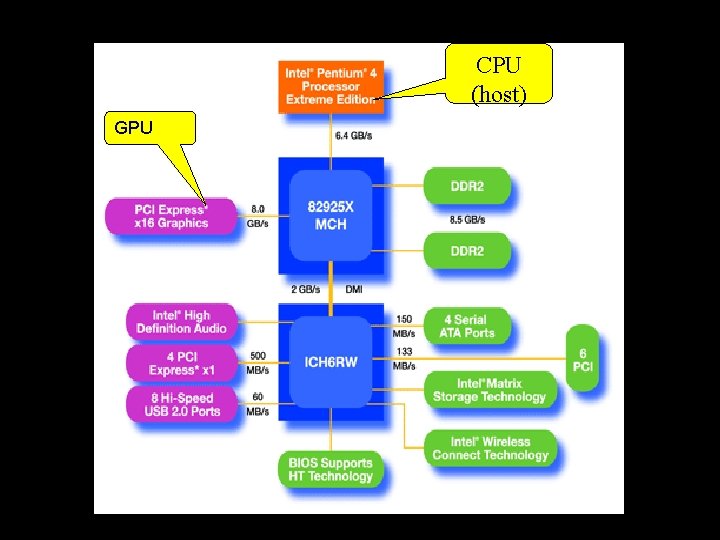
CPU (host) GPU
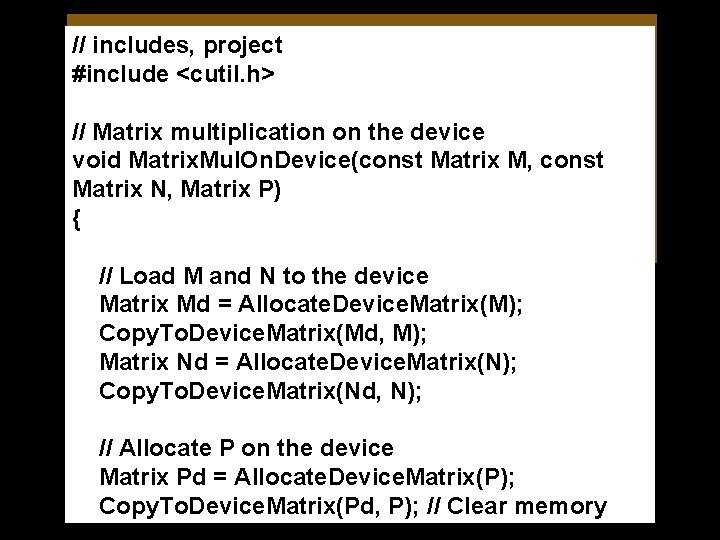
// includes, project #include <cutil. h> // Matrix multiplication on the device void Matrix. Mul. On. Device(const Matrix M, const Matrix N, Matrix P) { // Load M and N to the device Matrix Md = Allocate. Device. Matrix(M); Copy. To. Device. Matrix(Md, M); Matrix Nd = Allocate. Device. Matrix(N); Copy. To. Device. Matrix(Nd, N); // Allocate P on the device Matrix Pd = Allocate. Device. Matrix(P); Copy. To. Device. Matrix(Pd, P); // Clear memory
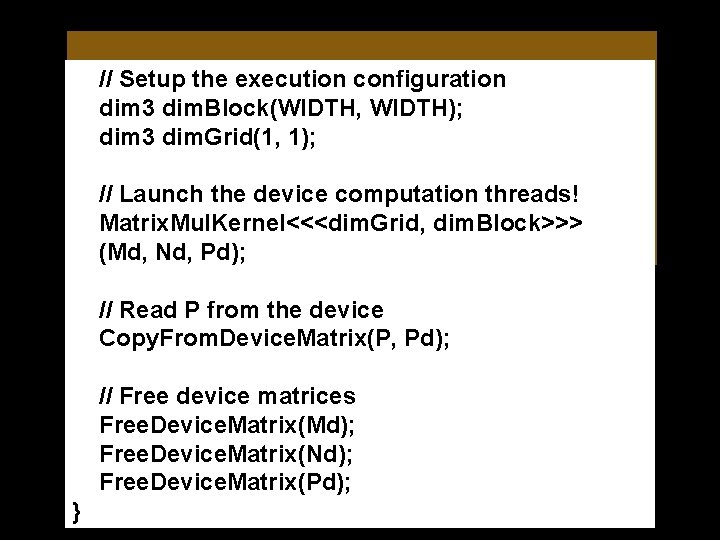
// Setup the execution configuration dim 3 dim. Block(WIDTH, WIDTH); dim 3 dim. Grid(1, 1); // Launch the device computation threads! Matrix. Mul. Kernel<<<dim. Grid, dim. Block>>> (Md, Nd, Pd); // Read P from the device Copy. From. Device. Matrix(P, Pd); // Free device matrices Free. Device. Matrix(Md); Free. Device. Matrix(Nd); Free. Device. Matrix(Pd); }
m. ca . uqa x e r t. w ww
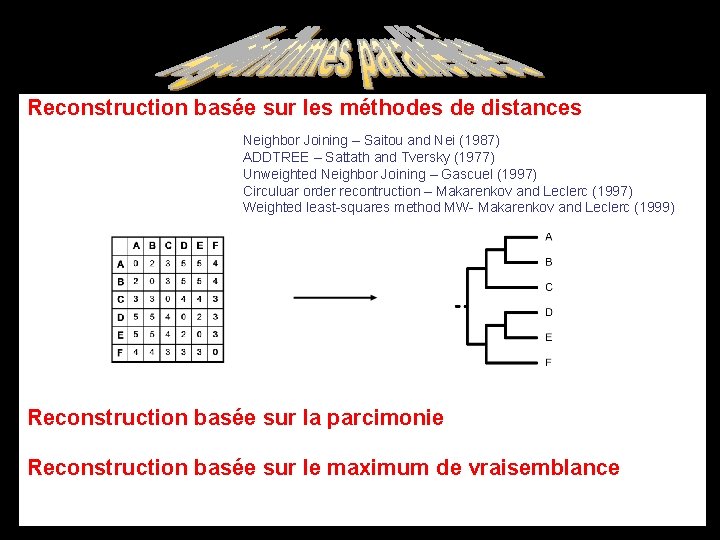
Reconstruction basée sur les méthodes de distances Neighbor Joining – Saitou and Nei (1987) ADDTREE – Sattath and Tversky (1977) Unweighted Neighbor Joining – Gascuel (1997) Circuluar order recontruction – Makarenkov and Leclerc (1997) Weighted least-squares method MW- Makarenkov and Leclerc (1999) Reconstruction basée sur la parcimonie Reconstruction basée sur le maximum de vraisemblance
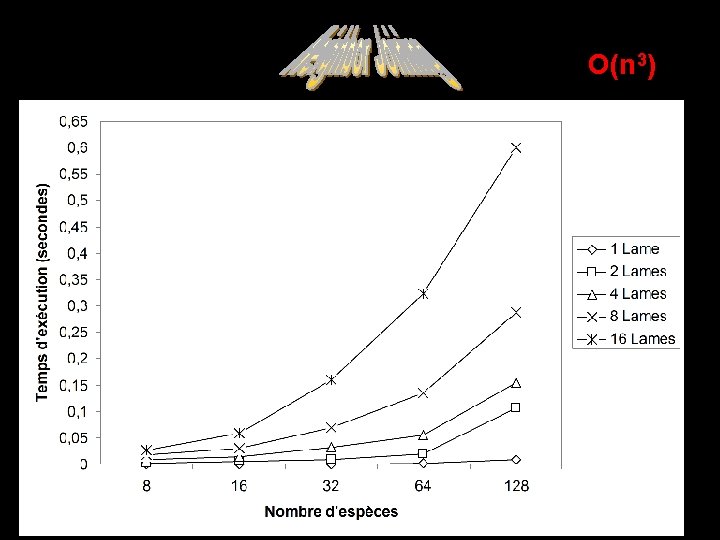
O(n 3)
O(n 5)
MPI un standard ? ? ? Clustal. W-MPI, MPI-Blast, … Automatisation du processus de parallélisation Projet de doctorat… AMD-ATI AMD Fire. Stream 9170 (Stream Processor)
- Slides: 26