
Algbre Relationnelle Implmentation w Rappel de lalgbre w
Algèbre Relationnelle : Implémentation w Rappel de l'algèbre w Structures d'indexation et placement w Algorithme de sélection w Algorithme de jointure 1
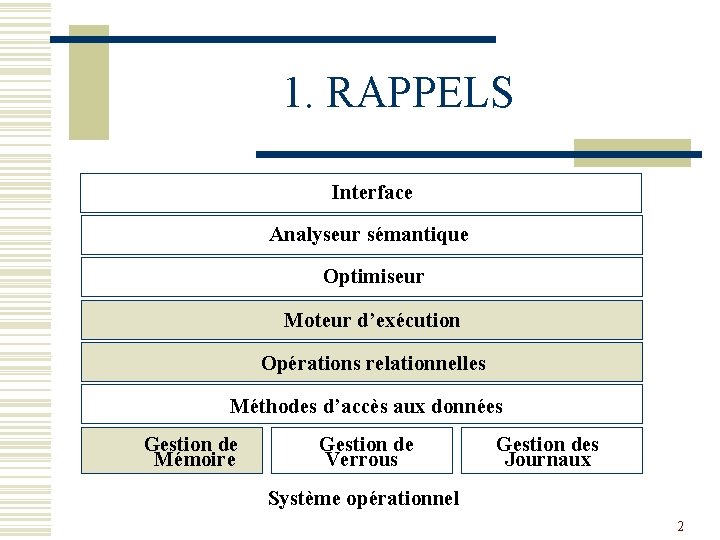
1. RAPPELS Interface Analyseur sémantique Optimiseur Moteur d’exécution Opérations relationnelles Méthodes d’accès aux données Gestion de Mémoire Gestion de Verrous Gestion des Journaux Système opérationnel 2
Langages de requêtes w Deux langages de requêtes à fondements mathématiques sont à la base de SQL : n Calcul relationnel: l n Permet aux utilisateurs de décrire ce qu’ils veulent, plutôt que la manière dont ce qu’ils veulent doit être calculé. (Non opérationnel, déclaratif. ) Algèbre relationnelle: l Plus opérationnelle, très utile pour représenter les plans d’exécution. 3
Calcul Relationnel w Dérivé de la logique w Requêtes de la forme n n {X | Formule(X, Y) } X est un vecteur de variables non quantifiées (x 1, x 2, …) Y est un vecteur de variables quantifiées (( / ) y 1, y 2, …) Chaque variable représente une colonne de table w {(x 1, x 2) | y 1 (Vins(x 1, x 2, . , y 1) AND y 1 = 1999) } 4
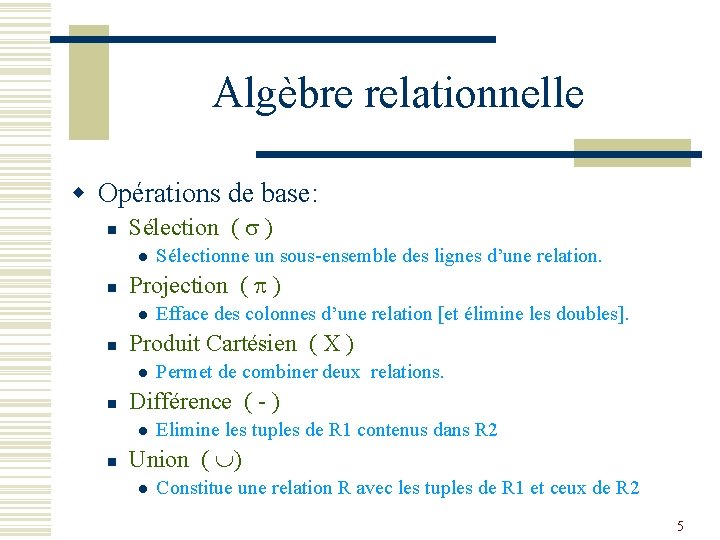
Algèbre relationnelle w Opérations de base: n Sélection ( ) l n Projection ( ) l n Permet de combiner deux relations. Différence ( - ) l n Efface des colonnes d’une relation [et élimine les doubles]. Produit Cartésien ( X ) l n Sélectionne un sous-ensemble des lignes d’une relation. Elimine les tuples de R 1 contenus dans R 2 Union ( ) l Constitue une relation R avec les tuples de R 1 et ceux de R 2 5
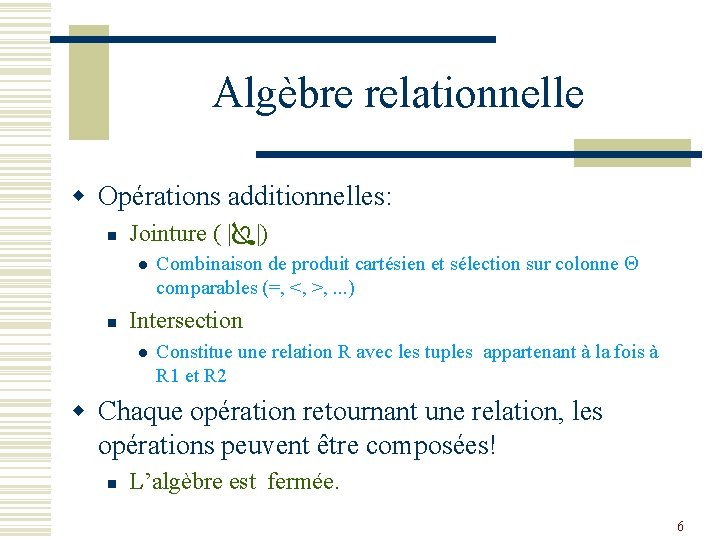
Algèbre relationnelle w Opérations additionnelles: n Jointure ( | |) l n Combinaison de produit cartésien et sélection sur colonne comparables (=, <, >, . . . ) Intersection l Constitue une relation R avec les tuples appartenant à la fois à R 1 et R 2 w Chaque opération retournant une relation, les opérations peuvent être composées! n L’algèbre est fermée. 6
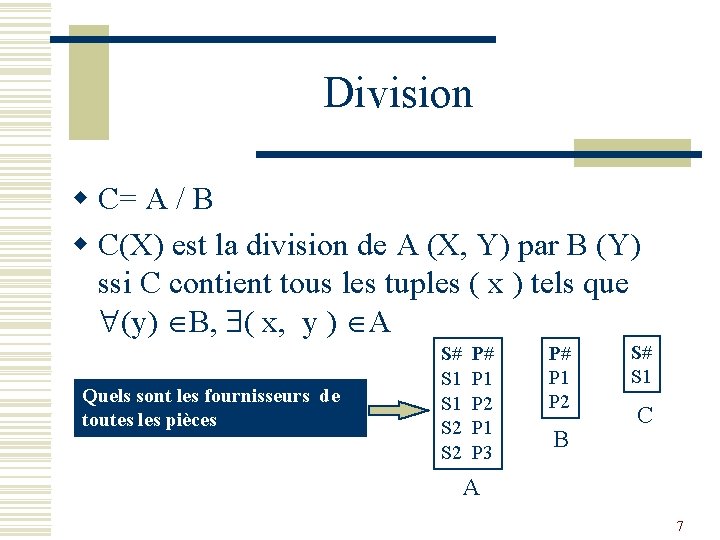
Division w C= A / B w C(X) est la division de A (X, Y) par B (Y) ssi C contient tous les tuples ( x ) tels que (y) B, ( x, y ) A Quels sont les fournisseurs de toutes les pièces S# S 1 S 2 P# P 1 P 2 P 1 P 3 P# P 1 P 2 B S# S 1 C A 7
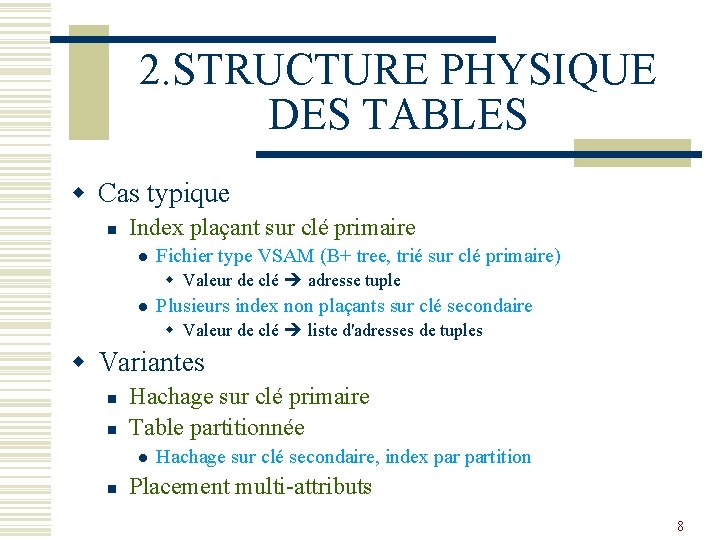
2. STRUCTURE PHYSIQUE DES TABLES w Cas typique n Index plaçant sur clé primaire l Fichier type VSAM (B+ tree, trié sur clé primaire) w Valeur de clé adresse tuple l Plusieurs index non plaçants sur clé secondaire w Valeur de clé liste d'adresses de tuples w Variantes n n Hachage sur clé primaire Table partitionnée l n Hachage sur clé secondaire, index partition Placement multi-attributs 8
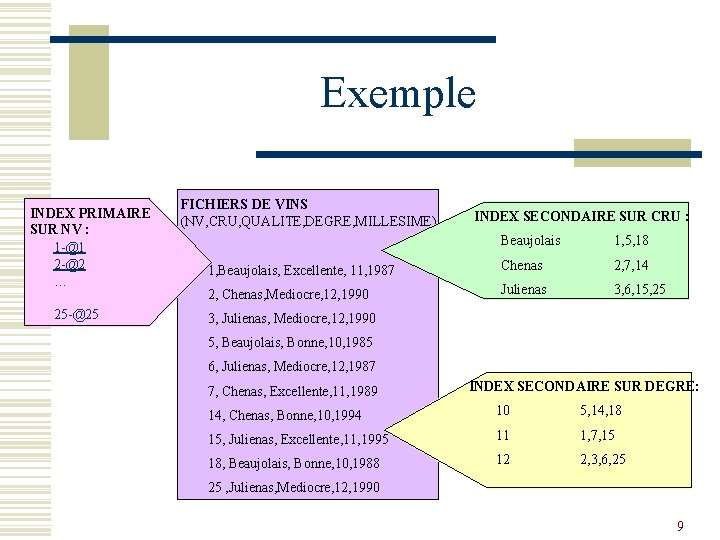
Exemple INDEX PRIMAIRE SUR NV : 1 -@1 2 -@2 … 25 -@25 FICHIERS DE VINS (NV, CRU, QUALITE, DEGRE, MILLESIME) INDEX SECONDAIRE SUR CRU : Beaujolais 1, 5, 18 1, Beaujolais, Excellente, 11, 1987 Chenas 2, 7, 14 2, Chenas, Mediocre, 12, 1990 Julienas 3, 6, 15, 25 3, Julienas, Mediocre, 12, 1990 5, Beaujolais, Bonne, 10, 1985 6, Julienas, Mediocre, 12, 1987 7, Chenas, Excellente, 11, 1989 INDEX SECONDAIRE SUR DEGRE: 14, Chenas, Bonne, 10, 1994 10 5, 14, 18 15, Julienas, Excellente, 11, 1995 11 1, 7, 15 18, Beaujolais, Bonne, 10, 1988 12 2, 3, 6, 25 25 , Julienas, Mediocre, 12, 1990 9
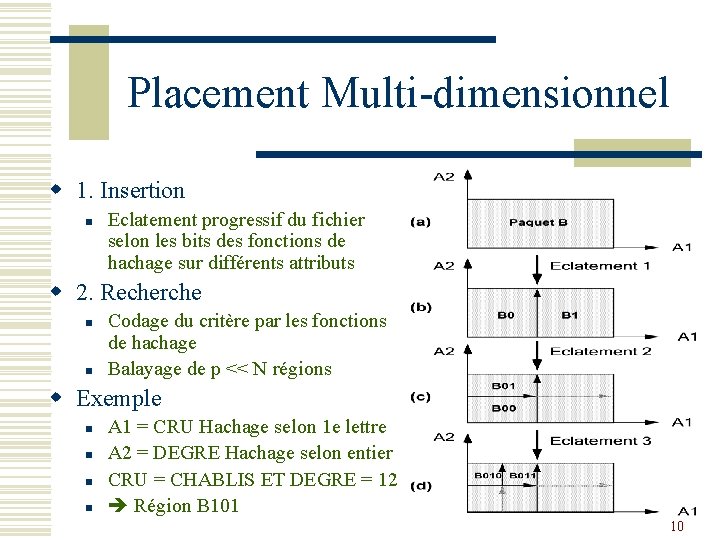
Placement Multi-dimensionnel w 1. Insertion n Eclatement progressif du fichier selon les bits des fonctions de hachage sur différents attributs w 2. Recherche n n Codage du critère par les fonctions de hachage Balayage de p << N régions w Exemple n n A 1 = CRU Hachage selon 1 e lettre A 2 = DEGRE Hachage selon entier CRU = CHABLIS ET DEGRE = 12 Région B 101 10
Index Bitmap w Cas des index peu discriminants w Exemple n n n 10**6 lignes de commandes 100 produits Index sur produit 10**4 adresses par entrées !! w Index lourd à manipuler ! w Variante : Index bitmap w Index bitmap n n Table de bits telle que Bit [i, j] = 1 si le ie tuple référence la valeur codée j w Accélérateur d'accès très utile et compacte pour attribut peu discriminant 11
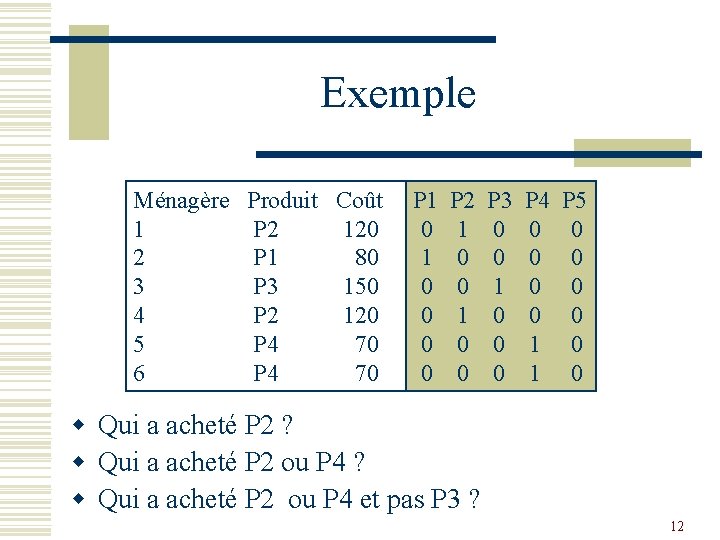
Exemple Ménagère Produit Coût 1 P 2 120 2 P 1 80 3 P 3 150 4 P 2 120 5 P 4 70 6 P 4 70 P 1 0 0 0 0 P 2 1 0 0 P 3 0 0 1 0 0 0 P 4 0 0 1 1 P 5 0 0 0 w Qui a acheté P 2 ? w Qui a acheté P 2 ou P 4 et pas P 3 ? 12
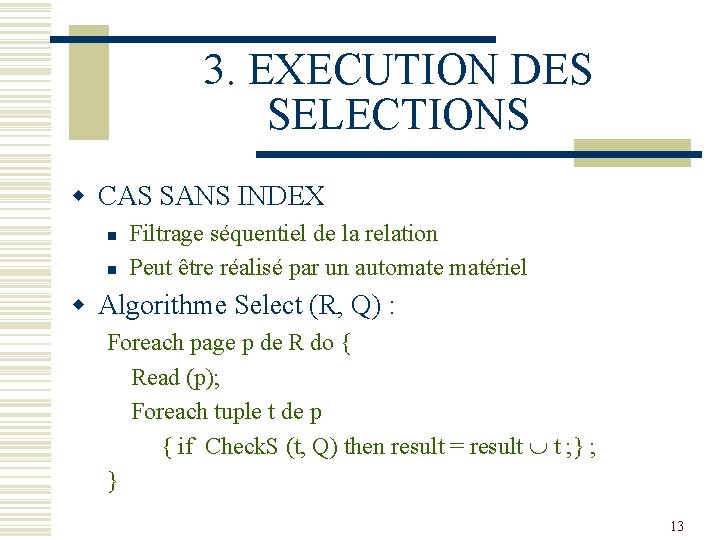
3. EXECUTION DES SELECTIONS w CAS SANS INDEX n n Filtrage séquentiel de la relation Peut être réalisé par un automate matériel w Algorithme Select (R, Q) : Foreach page p de R do { Read (p); Foreach tuple t de p { if Check. S (t, Q) then result = result t ; } 13
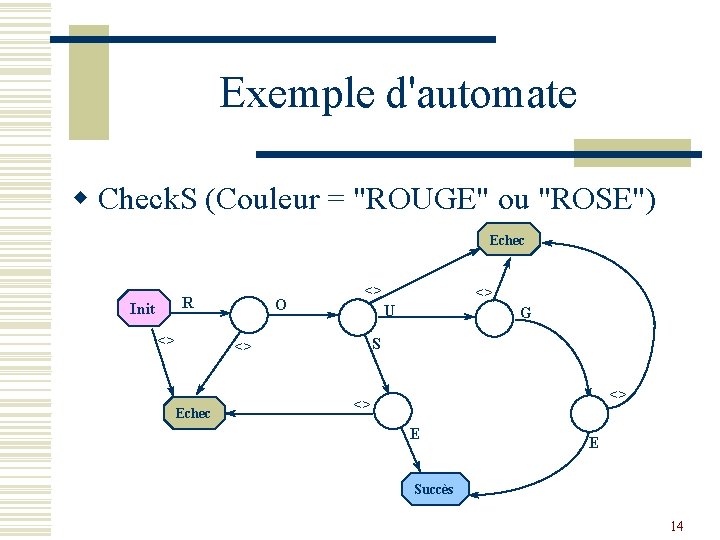
Exemple d'automate w Check. S (Couleur = "ROUGE" ou "ROSE") Echec R Init <> O <> U G S <> Echec <> <> <> E E Succès 14
Sélection via index w Cas avec index n n unidimensionnel (Isam, Arbre-B) multi-dimensionnel (Grid file, Arbre de prédicat) w Variante : Cas avec hachage n n unidimensionnel multi-dimensionnel (réduction du balayage) 15
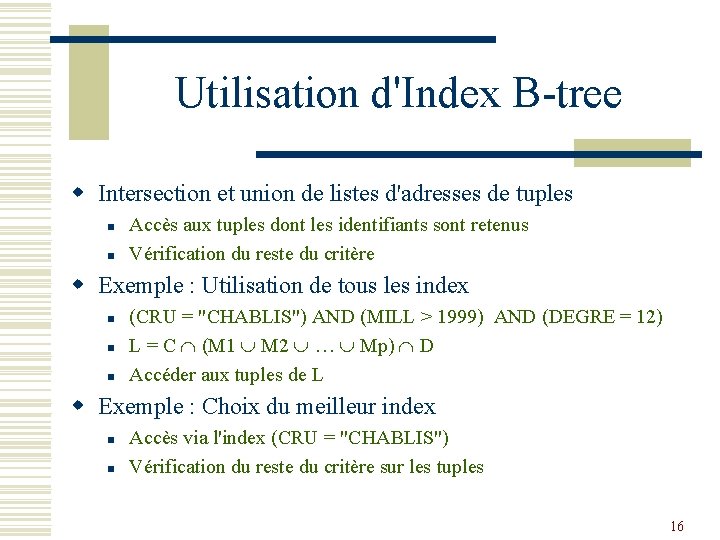
Utilisation d'Index B-tree w Intersection et union de listes d'adresses de tuples n n Accès aux tuples dont les identifiants sont retenus Vérification du reste du critère w Exemple : Utilisation de tous les index n n n (CRU = "CHABLIS") AND (MILL > 1999) AND (DEGRE = 12) L = C (M 1 M 2 … Mp) D Accéder aux tuples de L w Exemple : Choix du meilleur index n n Accès via l'index (CRU = "CHABLIS") Vérification du reste du critère sur les tuples 16
Utilisation d'index Bitmap w Détermination des adresses des tuples candidats w Possibilité de mixer avec des index B-Tree w Très utile pour les agrégats n Somme des coûts dépensés pour produit P 2 w Et le data mining … 17
4. EXECUTION DES JOINTURES w Opération essentielle des SGBDR w De multiples algorithmes n Sans index : réduire les balayages l Optimiser les comparaisons l Créer dynamiquement des index ou tables de hachage l n Avec index l n Profiter au mieux des index Toujours : Réduire I/O et temps CPU 18
Jointure et opérateurs similaires w Les mêmes types d’algorithmes peuvent êtres utilisés pour les autres opérateurs binaires w Variations : n n n n Nested Loop Join Block Nested Loop Join Index Join Sort Merge Join Hash Join Hybrid Hash Join Pipelined Hash Join 19
Évaluations avec Mémoire w w w On veut joindre les tables CLIent et COMmandes |CLI| = Nbre de pages occupées par CLI ||CLI|| = Nbre de tuples dans CLI |CLI| << |COM| M = Nbre de pages mémoires disponibles n (quelques approximations pour simplifier les formules) w Coût = Nbre d’I/O n (on ne distingue pas I/O séquentielle et aléatoire) 20
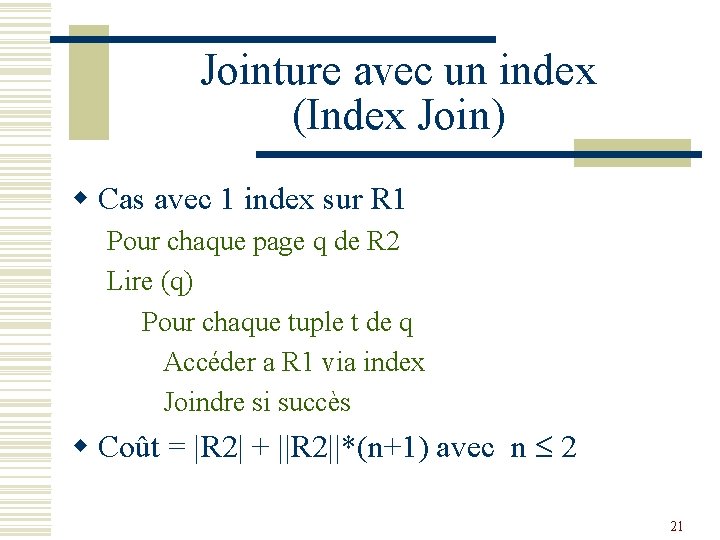
Jointure avec un index (Index Join) w Cas avec 1 index sur R 1 Pour chaque page q de R 2 Lire (q) Pour chaque tuple t de q Accéder a R 1 via index Joindre si succès w Coût = |R 2| + ||R 2||*(n+1) avec n 2 21
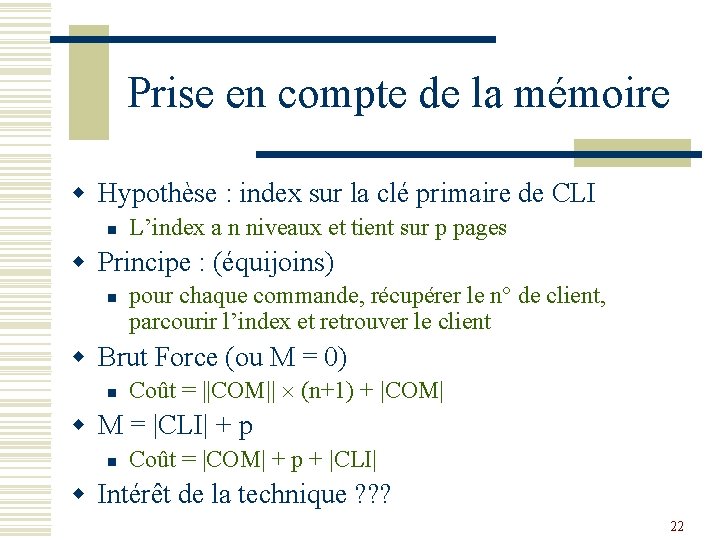
Prise en compte de la mémoire w Hypothèse : index sur la clé primaire de CLI n L’index a n niveaux et tient sur p pages w Principe : (équijoins) n pour chaque commande, récupérer le n° de client, parcourir l’index et retrouver le client w Brut Force (ou M = 0) n Coût = ||COM|| (n+1) + |COM| w M = |CLI| + p n Coût = |COM| + p + |CLI| w Intérêt de la technique ? ? ? 22
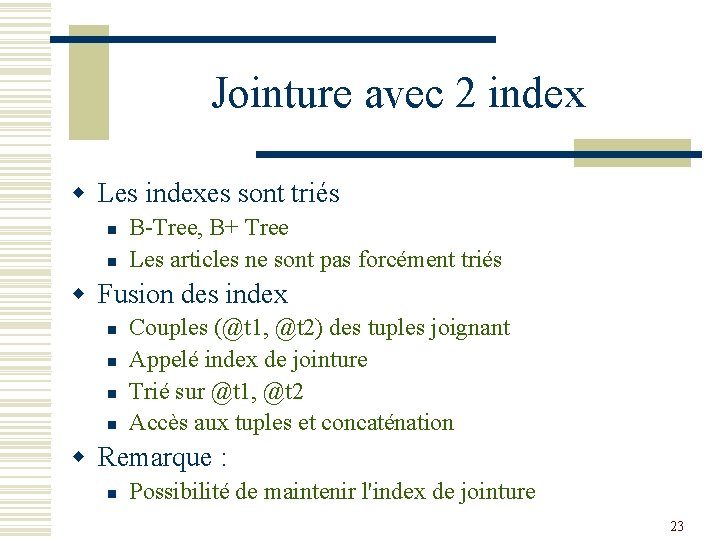
Jointure avec 2 index w Les indexes sont triés n n B-Tree, B+ Tree Les articles ne sont pas forcément triés w Fusion des index n n Couples (@t 1, @t 2) des tuples joignant Appelé index de jointure Trié sur @t 1, @t 2 Accès aux tuples et concaténation w Remarque : n Possibilité de maintenir l'index de jointure 23
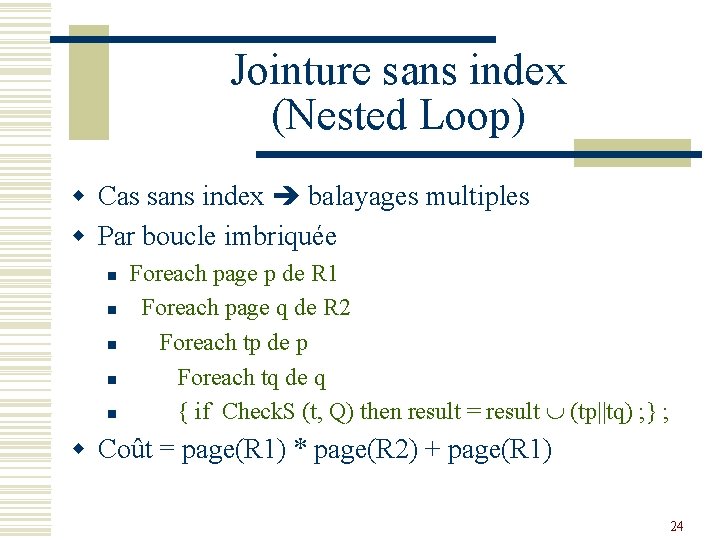
Jointure sans index (Nested Loop) w Cas sans index balayages multiples w Par boucle imbriquée n n n Foreach page p de R 1 Foreach page q de R 2 Foreach tp de p Foreach tq de q { if Check. S (t, Q) then result = result (tp||tq) ; } ; w Coût = page(R 1) * page(R 2) + page(R 1) 24
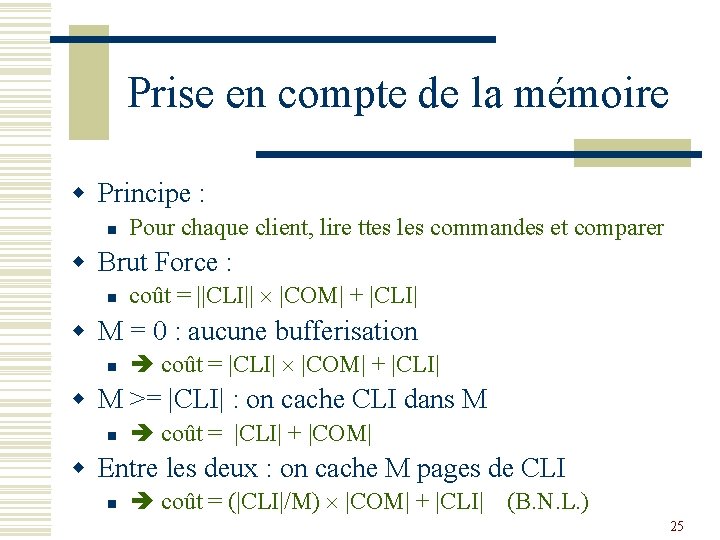
Prise en compte de la mémoire w Principe : n Pour chaque client, lire ttes les commandes et comparer w Brut Force : n coût = ||CLI|| |COM| + |CLI| w M = 0 : aucune bufferisation n coût = |CLI| |COM| + |CLI| w M >= |CLI| : on cache CLI dans M n coût = |CLI| + |COM| w Entre les deux : on cache M pages de CLI n coût = (|CLI|/M) |COM| + |CLI| (B. N. L. ) 25
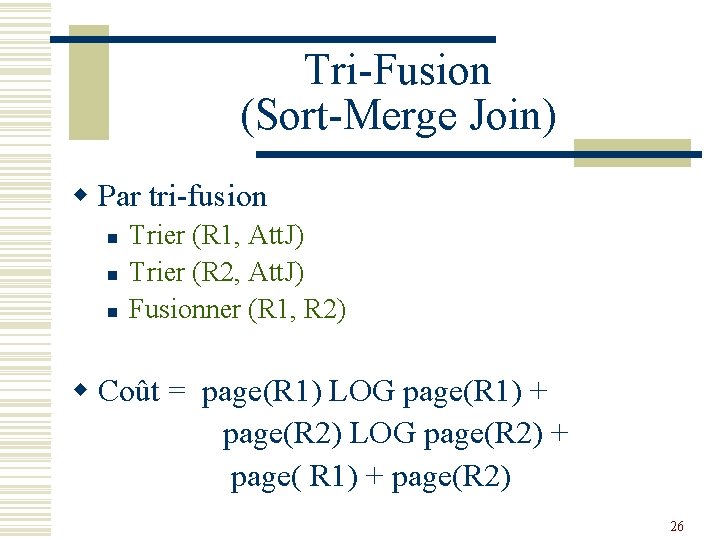
Tri-Fusion (Sort-Merge Join) w Par tri-fusion n Trier (R 1, Att. J) Trier (R 2, Att. J) Fusionner (R 1, R 2) w Coût = page(R 1) LOG page(R 1) + page(R 2) LOG page(R 2) + page( R 1) + page(R 2) 26
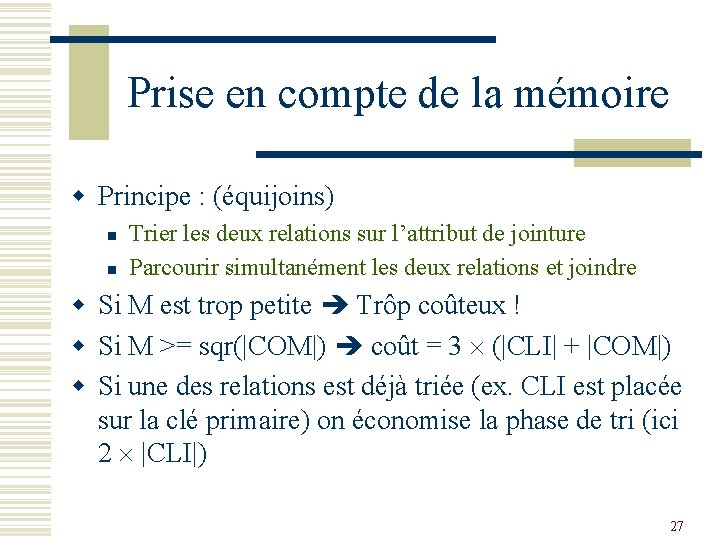
Prise en compte de la mémoire w Principe : (équijoins) n n Trier les deux relations sur l’attribut de jointure Parcourir simultanément les deux relations et joindre w Si M est trop petite Trôp coûteux ! w Si M >= sqr(|COM|) coût = 3 (|CLI| + |COM|) w Si une des relations est déjà triée (ex. CLI est placée sur la clé primaire) on économise la phase de tri (ici 2 |CLI|) 27
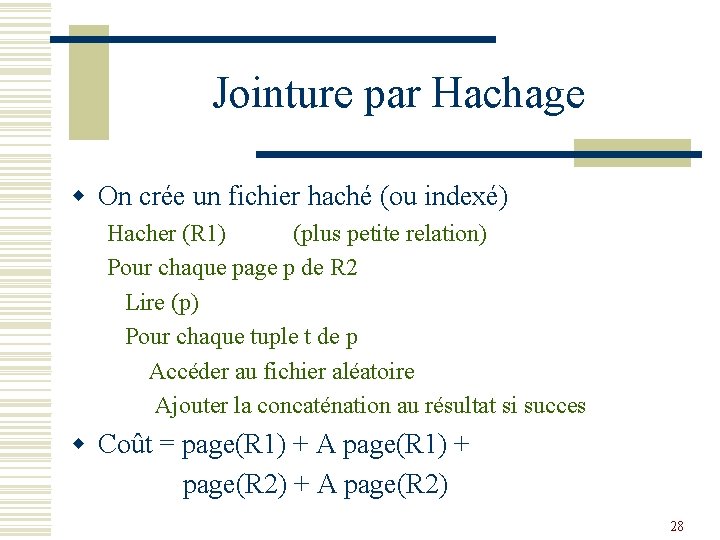
Jointure par Hachage w On crée un fichier haché (ou indexé) Hacher (R 1) (plus petite relation) Pour chaque page p de R 2 Lire (p) Pour chaque tuple t de p Accéder au fichier aléatoire Ajouter la concaténation au résultat si succes w Coût = page(R 1) + A page(R 1) + page(R 2) + A page(R 2) 28
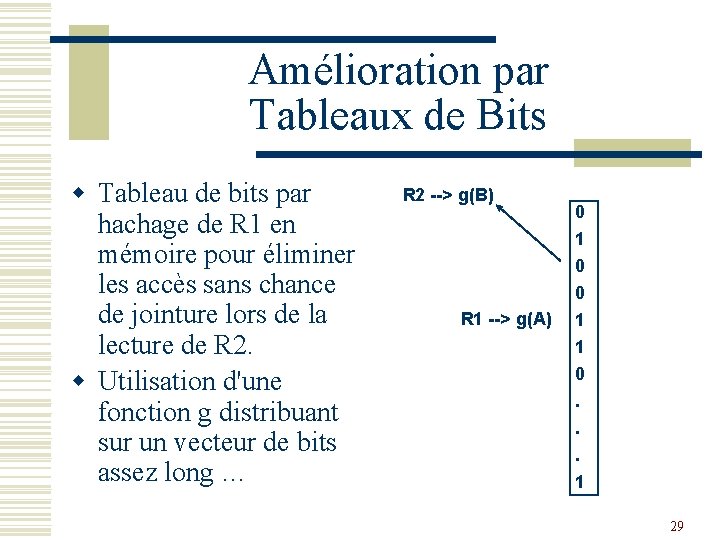
Amélioration par Tableaux de Bits w Tableau de bits par hachage de R 1 en mémoire pour éliminer les accès sans chance de jointure lors de la lecture de R 2. w Utilisation d'une fonction g distribuant sur un vecteur de bits assez long … R 2 --> g(B) R 1 --> g(A) 0 1 0 0 1 1 0. . . 1 29
Prise en compte de la mémoire w Hypothèse M >=|CLI| w Principe (équijoins) : n n Charger CLI et hacher la relation en mémoire en n paquets (n du même ordre que ||CLI||) Pour chaque tuple de COM, tester la table de hachage w Coût = |CLI| + |COM| w Différence avec le Nested Loop ? 30
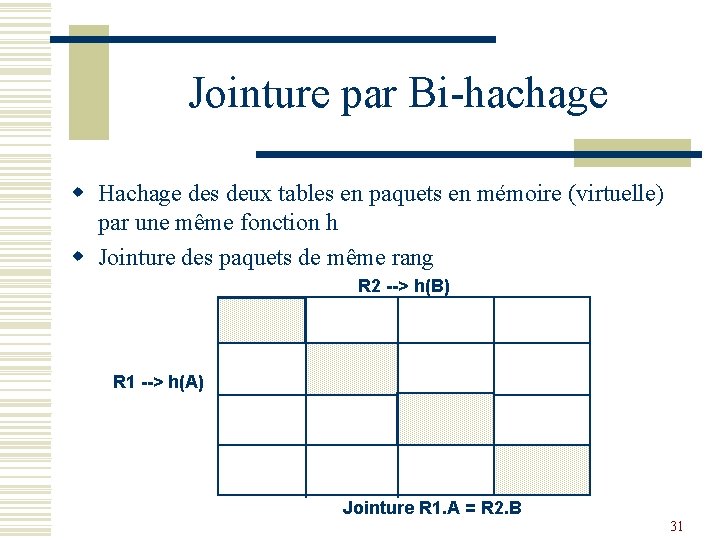
Jointure par Bi-hachage w Hachage des deux tables en paquets en mémoire (virtuelle) par une même fonction h w Jointure des paquets de même rang R 2 --> h(B) R 1 --> h(A) Jointure R 1. A = R 2. B 31
Grace Hash Join w Hypothèse : M >= sqr(|COM|) w Principe : n n n Hacher sur le disque CLI et COM en N paquets. N est calculé de façon à ce que |paquet| < M Joindre chaque paquet de CLI avec chaque paquet de COM coût = 3 (|CLI| + |COM|) 32
Hybrid Hash Join w Exemple M = |CLI|/n w Principe : n n Hacher CLI en n paquets. Le paquet 1 est conservé en mémoire les paquets 2 à n sont réécris sur disque. Hacher COM en n paquets. Le paquet 1 est testé immédiatement en mémoire avec le paquet 1 de CLI. Les autres sont réécris sur disque w Coût : (|CLI|+|COM|) ( 1 + 2(n-1)/n) w A. N. : n = 2 Coût = 2 (|CLI|+|COM|) 33
Mode pipeline ou bloquant w Le pipeline sort un tuple résultat dès qu'il est calculé w Pas nécessaire d'attendre le dernier tuple résultat pour débloquer l'utilisateur w Plus efficace vu de l'utilisateur w Opérateur bloquant n Tri w Opérateur non bloquant n Sélection, hachage 34
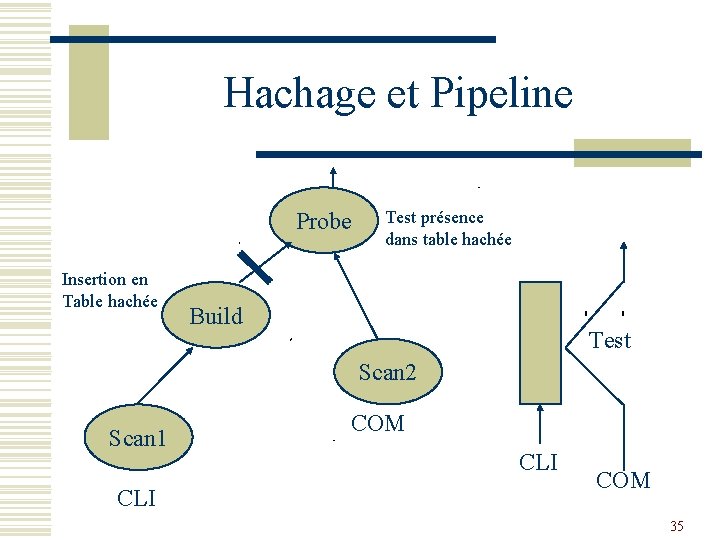
Hachage et Pipeline Probe Insertion en Table hachée Test présence dans table hachée Build Test Scan 2 Scan 1 CLI COM 35
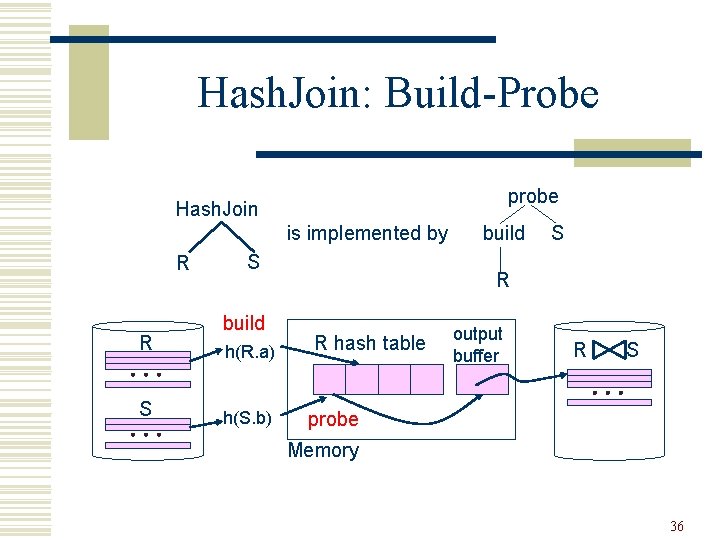
Hash. Join: Build-Probe probe Hash. Join is implemented by R R S S build h(R. a) h(S. b) build S R R hash table output buffer R S probe Memory 36
5. CONCLUSION w Problème essentiel des SGBD w De multiples algorithmes possibles w Pas d'algorithme toujours meilleur ! w Nécessite d'un modèle de coût pour choisir le meilleur algorithme w Choix souvent fait à la compilation 37
- Slides: 37