
Agentes Baseados em Utilidade Parte I Decises Simples
Agentes Baseados em Utilidade
Parte I: Decisões Simples “Como um agente deve tomar decisões de modo que, em média, ele consiga o quer”
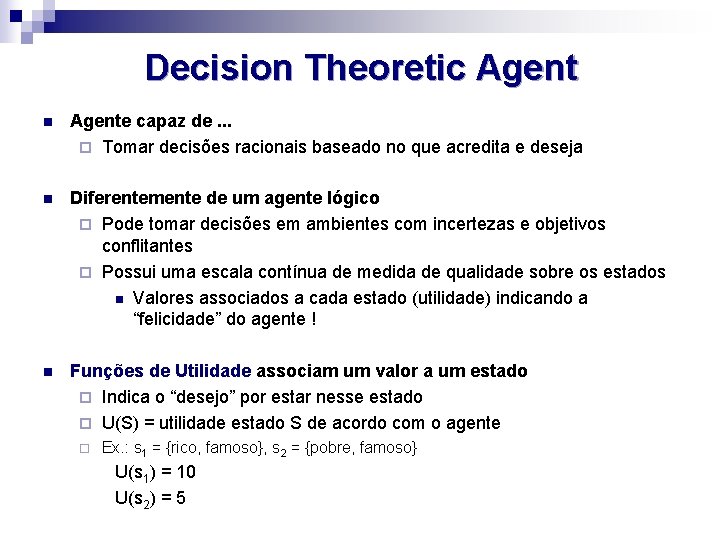
Decision Theoretic Agent n Agente capaz de. . . ¨ Tomar decisões racionais baseado no que acredita e deseja n Diferentemente de um agente lógico ¨ Pode tomar decisões em ambientes com incertezas e objetivos conflitantes ¨ Possui uma escala contínua de medida de qualidade sobre os estados n Valores associados a cada estado (utilidade) indicando a “felicidade” do agente ! n Funções de Utilidade associam um valor a um estado ¨ Indica o “desejo” por estar nesse estado ¨ U(S) = utilidade estado S de acordo com o agente ¨ Ex. : s 1 = {rico, famoso}, s 2 = {pobre, famoso} U(s 1) = 10 U(s 2) = 5
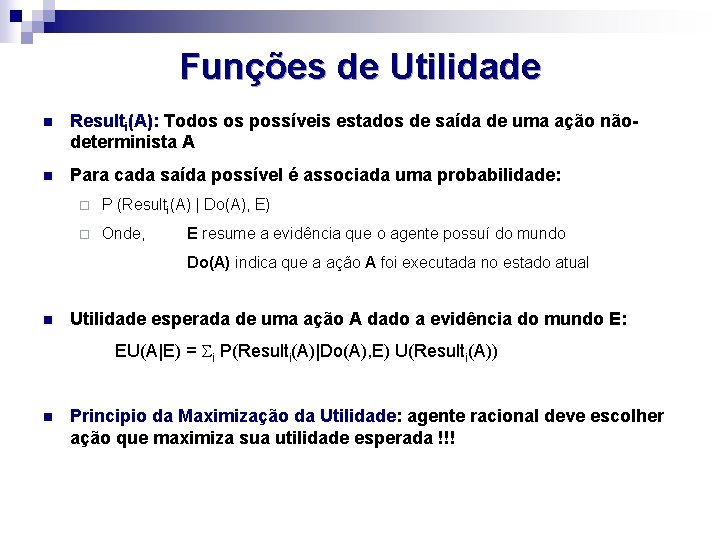
Funções de Utilidade n Resulti(A): Todos os possíveis estados de saída de uma ação nãodeterminista A n Para cada saída possível é associada uma probabilidade: ¨ P (Resulti(A) | Do(A), E) ¨ Onde, E resume a evidência que o agente possuí do mundo Do(A) indica que a ação A foi executada no estado atual n Utilidade esperada de uma ação A dado a evidência do mundo E: EU(A|E) = i P(Resulti(A)|Do(A), E) U(Resulti(A)) n Principio da Maximização da Utilidade: agente racional deve escolher ação que maximiza sua utilidade esperada !!!
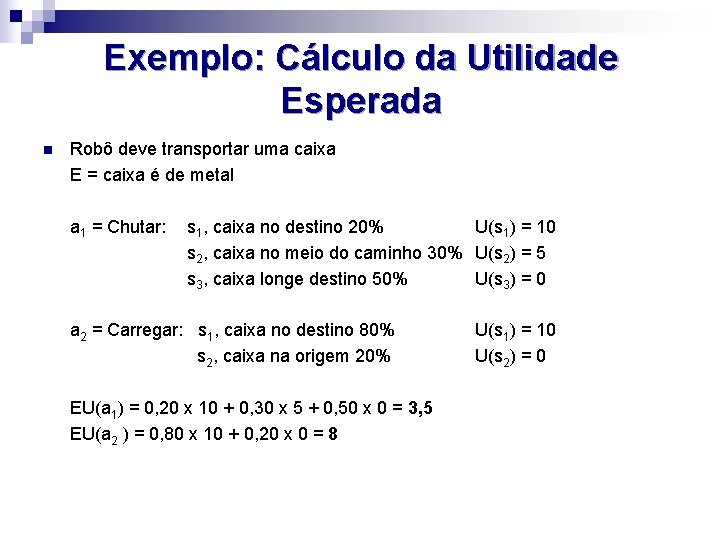
Exemplo: Cálculo da Utilidade Esperada n Robô deve transportar uma caixa E = caixa é de metal a 1 = Chutar: s 1, caixa no destino 20% U(s 1) = 10 s 2, caixa no meio do caminho 30% U(s 2) = 5 s 3, caixa longe destino 50% U(s 3) = 0 a 2 = Carregar: s 1, caixa no destino 80% s 2, caixa na origem 20% EU(a 1) = 0, 20 x 10 + 0, 30 x 5 + 0, 50 x 0 = 3, 5 EU(a 2 ) = 0, 80 x 10 + 0, 20 x 0 = 8 U(s 1) = 10 U(s 2) = 0
Preferências Racionais n Funções de Utilidade são, essencialmente, heurísticas! n Preferências racionais permitem descrever o melhor comportamento como aquele que maximiza EU ¨ A e B são loterias, i. e. , distribuições probabilísticas sobre um conjunto de estados de saída L = {p 1. S 1; p 2. S 2; . . . ; pn. Sn}
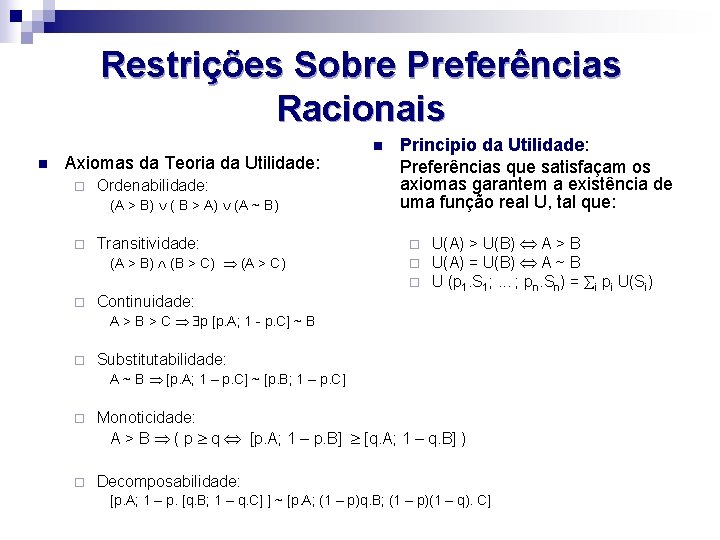
Restrições Sobre Preferências Racionais n Axiomas da Teoria da Utilidade: ¨ Ordenabilidade: (A > B) ( B > A) (A ~ B) ¨ Transitividade: (A > B) (B > C) (A > C) ¨ Continuidade: n Principio da Utilidade: Preferências que satisfaçam os axiomas garantem a existência de uma função real U, tal que: ¨ ¨ ¨ U(A) > U(B) A > B U(A) = U(B) A ~ B U (p 1. S 1; . . . ; pn. Sn) = i pi U(Si) A > B > C p [p. A; 1 - p. C] ~ B ¨ Substitutabilidade: A ~ B [p. A; 1 – p. C] ~ [p. B; 1 – p. C] ¨ Monoticidade: A > B ( p q [p. A; 1 – p. B] [q. A; 1 – q. B] ) ¨ Decomposabilidade: [p. A; 1 – p. [q. B; 1 – q. C] ] ~ [p. A; (1 – p)q. B; (1 – p)(1 – q). C]
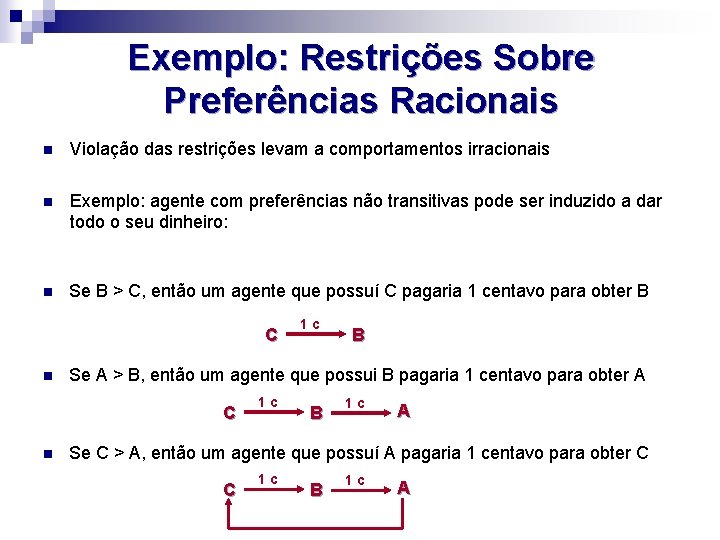
Exemplo: Restrições Sobre Preferências Racionais n Violação das restrições levam a comportamentos irracionais n Exemplo: agente com preferências não transitivas pode ser induzido a dar todo o seu dinheiro: n Se B > C, então um agente que possuí C pagaria 1 centavo para obter B C n B Se A > B, então um agente que possui B pagaria 1 centavo para obter A C n 1 c 1 c B 1 c A Se C > A, então um agente que possuí A pagaria 1 centavo para obter C C 1 c B 1 c A
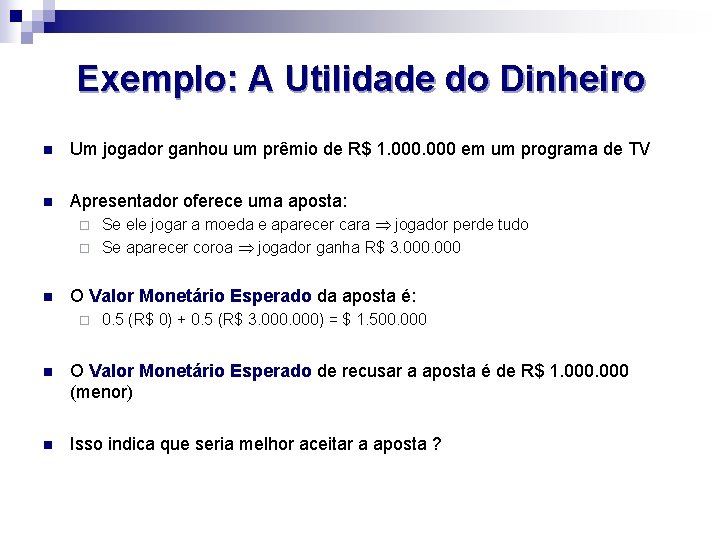
Exemplo: A Utilidade do Dinheiro n Um jogador ganhou um prêmio de R$ 1. 000 em um programa de TV n Apresentador oferece uma aposta: Se ele jogar a moeda e aparecer cara jogador perde tudo ¨ Se aparecer coroa jogador ganha R$ 3. 000 ¨ n O Valor Monetário Esperado da aposta é: ¨ 0. 5 (R$ 0) + 0. 5 (R$ 3. 000) = $ 1. 500. 000 n O Valor Monetário Esperado de recusar a aposta é de R$ 1. 000 (menor) n Isso indica que seria melhor aceitar a aposta ?
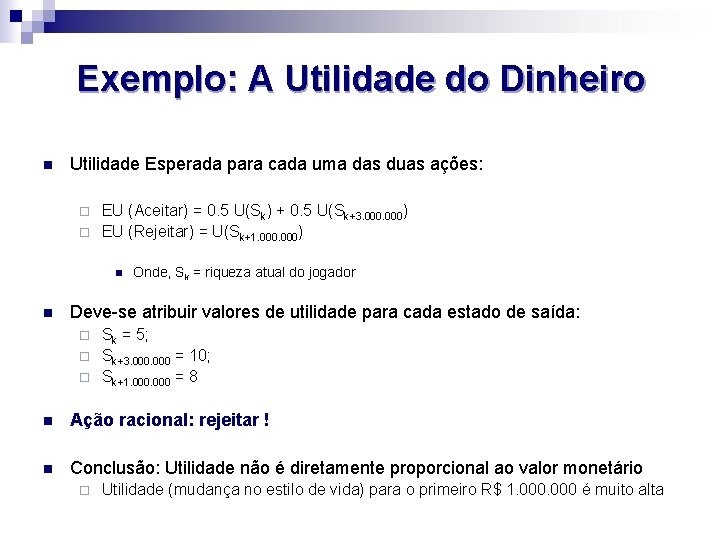
Exemplo: A Utilidade do Dinheiro n Utilidade Esperada para cada uma das duas ações: EU (Aceitar) = 0. 5 U(Sk) + 0. 5 U(Sk+3. 000) ¨ EU (Rejeitar) = U(Sk+1. 000) ¨ n n Onde, Sk = riqueza atual do jogador Deve-se atribuir valores de utilidade para cada estado de saída: Sk = 5; ¨ Sk+3. 000 = 10; ¨ Sk+1. 000 = 8 ¨ n Ação racional: rejeitar ! n Conclusão: Utilidade não é diretamente proporcional ao valor monetário ¨ Utilidade (mudança no estilo de vida) para o primeiro R$ 1. 000 é muito alta
Funções de Utilidade Multi-Atributo n Como tratar funções de utilidades com várias variáveis X 1, . . . , Xn ? ¨ Ex. : Construir aeroporto, n n n Variáveis: Segurança, Custo, Poluição sonora U (Segurança, Custo, Poluição sonora) = ? Existem basicamente dois casos: ¨ Dominância: decisões podem ser tomadas sem combinar os valores dos atributos em um único valor da utilidade ¨ Estrutura de Preferência e Utilidade Multi-atributo: utilidade resultante da combinação dos valores dos atributos pode ser especificada concisamente
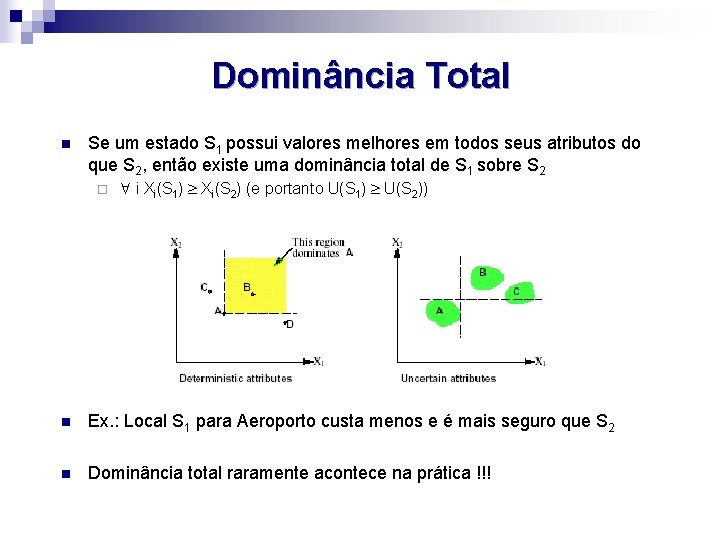
Dominância Total n Se um estado S 1 possui valores melhores em todos seus atributos do que S 2, então existe uma dominância total de S 1 sobre S 2 ¨ i Xi(S 1) Xi(S 2) (e portanto U(S 1) U(S 2)) n Ex. : Local S 1 para Aeroporto custa menos e é mais seguro que S 2 n Dominância total raramente acontece na prática !!!
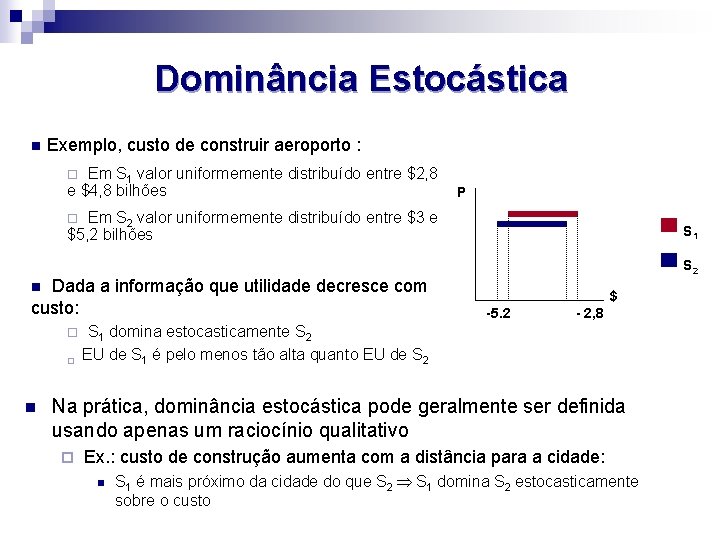
Dominância Estocástica n Exemplo, custo de construir aeroporto : Em S 1 valor uniformemente distribuído entre $2, 8 e $4, 8 bilhões ¨ P Em S 2 valor uniformemente distribuído entre $3 e $5, 2 bilhões ¨ S 1 S 2 Dada a informação que utilidade decresce com custo: n ¨ ¨ n $ -5. 2 - 2, 8 S 1 domina estocasticamente S 2 EU de S 1 é pelo menos tão alta quanto EU de S 2 Na prática, dominância estocástica pode geralmente ser definida usando apenas um raciocínio qualitativo ¨ Ex. : custo de construção aumenta com a distância para a cidade: n S 1 é mais próximo da cidade do que S 2 S 1 domina S 2 estocasticamente sobre o custo
Estrutura de Preferência e Utilidade Multi-Atributo n Supondo que existem n atributos com d possíveis valores: ¨ n A Teoria da Utilidade Multi-atributo assume que preferências de agentes possuem certa regularidade (estrutura) ¨ n No pior caso, serão necessários dn valores (preferência sem regularidade!) Abordagem básica é tentar identificar essas regularidades! Agentes com uma certa estrutura em suas preferências terá uma função: U(x 1. . . Xn) = f[ f 1(x 1). . . f 2(x 2) ] Onde espera-se que f seja uma função simples!
Estrutura de Preferência (Situação Determinista) n X 1 e X 2 são preferencialmente independente de X 3 se, e somente se: ¨ n Independência preferencial mútua (MPI): todos os pares de atributos são preferencialmente independente com relação aos demais ¨ n Preferência entre {x 1, x 2, x 3} e {x 1’, x 2’, x 3} não depende em x 3 Ex. : Segurança, Custo, Poluição sonora Com MPI, o comportamento preferencial do agente pode ser descrito como uma maximização da função: ¨ V (x 1. . . xn) = i Vi(xi)
Redes de Decisões n Formalismo para expressar e resolver problemas de decisão: estende Redes Bayesianas adicionando ações e utilidades n Composto de: Nós de Chance (ovais): representam variáveis como nas redes Bayesianas ¨ Nós de Decisão (retângulo): pontos onde agente deve escolher uma ação ¨ Nós de Utilidade (diamantes): representam as funções de utilidade do agente ¨ n Algoritmo de avaliação: Atribuir os valores das variáveis para o estado corrente; 2. Calcular o valor esperado do nó de utilidade dado a ação e os valores das variáveis; 3. Retornar a ação com maior Utilidade Máxima Esperada 1.
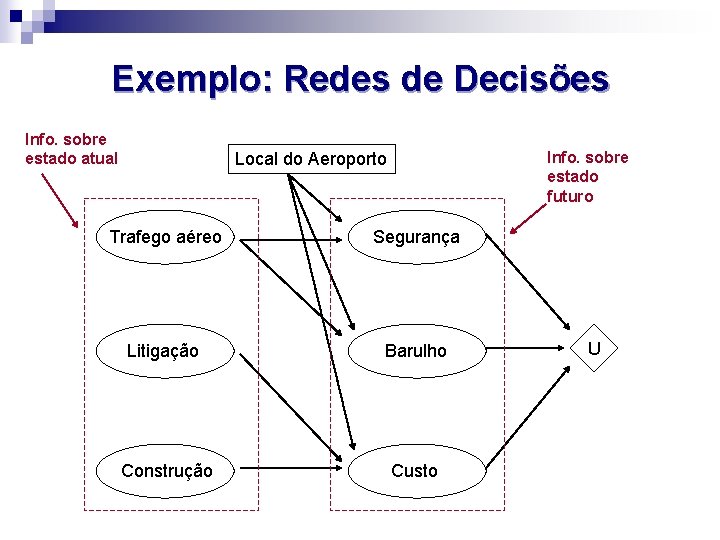
Exemplo: Redes de Decisões Info. sobre estado atual Info. sobre estado futuro Local do Aeroporto Trafego aéreo Segurança Litigação Barulho Construção Custo U
Teoria do Valor da Informação n Problemas anteriores assumiam que todas as informações estavam disponíveis n O que acontece quando elas não estão? ¨ n Cabe ao agente buscar as informações necessárias. . . No entanto. . . Obtenção de informações tem um custo associado ¨ Ex. : solicitação de um exame por parte de um medico ¨ n A Teoria do Valor da Informação permite que o agente escolha quais informações adquirir
Cálculo do Valor da Informação: Exemplo n Exemplo: comprar os direitos de exploração de reservas de petróleo: ¨ ¨ ¨ n Dois blocos A e B, apenas um possui óleo com valor C; Probabilidade de comprar o bloco certo = 0, 5 O preço de cada bloco é C/2 Consultor oferece uma pesquisa para detectar qual bloco possui petróleo. Qual o valor dessa informação? Solução: Calcular o valor esperado da informação = valor esperado da melhor ação dada a informação – valor esperado da melhor ação sem a informação; ¨ Pesquisador irá informar: “há óleo em A” ou “não há óleo em A” (p = 0, 5) ¨ Então: ¨ 0, 5 x valor de “comprar A” dado que “há óleo em A” + 0, 5 x valor de “comprar B” dado que “não há óleo em A” – 0 = = (0, 5 x C/2) + (0, 5 x C/2) – 0 = C/2
Valor da Informação: Exemplo n A 1 e A 2 duas rotas distintas através de uma montanha no inverno A 1 e A 2 são as únicas ações possíveis, com EU = U 1 e U 2, respectivamente ¨ A 1 = caminho mais baixo, sem muito vento ¨ A 2 = caminho mais alto, com muito vento ¨ ¨ n Nova evidência NE produzirá novas utilidades esperadas U 1’ e U 2’ ¨ n U (A 1) > U (A 2) Vale a pena adquirir NE? E se mudássemos o cenário? II) A 1 e A 2 são duas estradas onde venta muito, de mesmo tamanho e levamos um ferido grave ¨ III) Mesmas estradas A 1 e A 2 mas agora no verão ¨ n Conclusão: uma informação só terá valor caso gere uma mudança de plano, e se esse novo plano for significativamente melhor do que o antigo !
Parte 2: Decisões Complexas “Métodos para decidir o que fazer hoje, dado que nós poderemos ter que decidir de novo amanhã”
Problemas de Decisões Seqüenciais n Anteriormente estávamos lidando com problemas de decisão episódicos: ¨ n Utilidade de cada resultado de uma ação conhecido! Problemas de decisões seqüenciais: Utilidade do agente depende de uma seqüência de decisões ¨ Envolvem utilidades, incertezas e percepção ¨
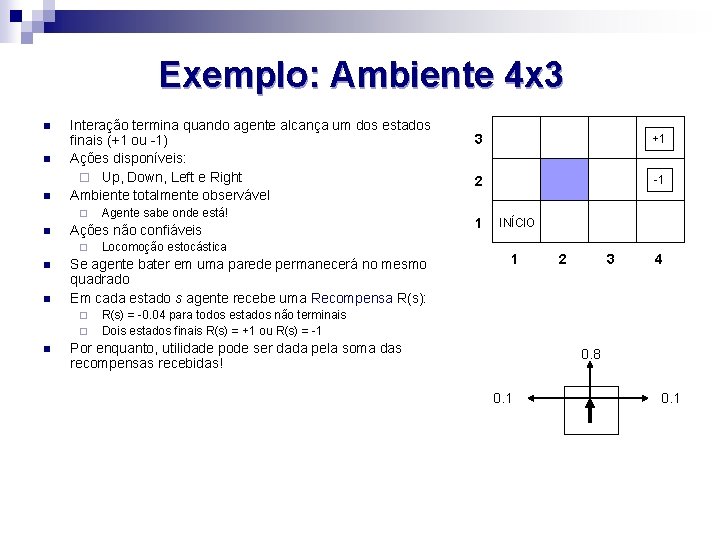
Exemplo: Ambiente 4 x 3 n n n Interação termina quando agente alcança um dos estados finais (+1 ou -1) Ações disponíveis: ¨ Up, Down, Left e Right Ambiente totalmente observável ¨ n Ações não confiáveis ¨ n n Locomoção estocástica Se agente bater em uma parede permanecerá no mesmo quadrado Em cada estado s agente recebe uma Recompensa R(s): ¨ ¨ n Agente sabe onde está! 3 +1 2 -1 1 INÍCIO 1 2 3 4 R(s) = -0. 04 para todos estados não terminais Dois estados finais R(s) = +1 ou R(s) = -1 Por enquanto, utilidade pode ser dada pela soma das recompensas recebidas! 0. 8 0. 1
Processo de Decisão de Markov (PDM) Especificação de um problema de decisão seqüencial em um ambiente totalmente observável com um modelo de transição de Markov e recompensas aditivas n Definido pelos seguintes componentes: Estado Inicial: S 0 ¨ Modelo de Transição: T(s, a, s’) ¨ n ¨ Função de Recompensa: R(s) n n Probabilidade de chegar a s’ como resultado da execução da ação a no estado s Utilidade a curto prazo do estado s para o agente Hipótese de transições Markovianas: ¨ Próximo estado depende apenas da ação atual e do estado atual, não dependendo de estados passados
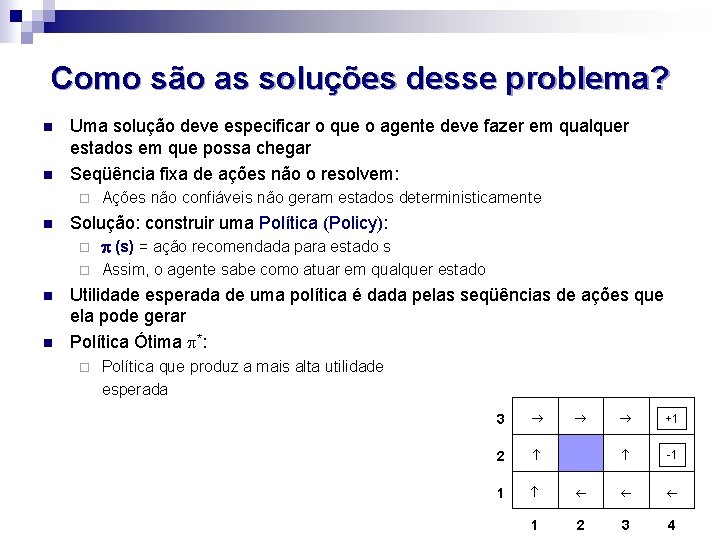
Como são as soluções desse problema? n n Uma solução deve especificar o que o agente deve fazer em qualquer estados em que possa chegar Seqüência fixa de ações não o resolvem: ¨ n Ações não confiáveis não geram estados deterministicamente Solução: construir uma Política (Policy): (s) = ação recomendada para estado s ¨ Assim, o agente sabe como atuar em qualquer estado ¨ n n Utilidade esperada de uma política é dada pelas seqüências de ações que ela pode gerar Política Ótima *: ¨ Política que produz a mais alta utilidade esperada 3 2 1 1 +1 -1 2 3 4
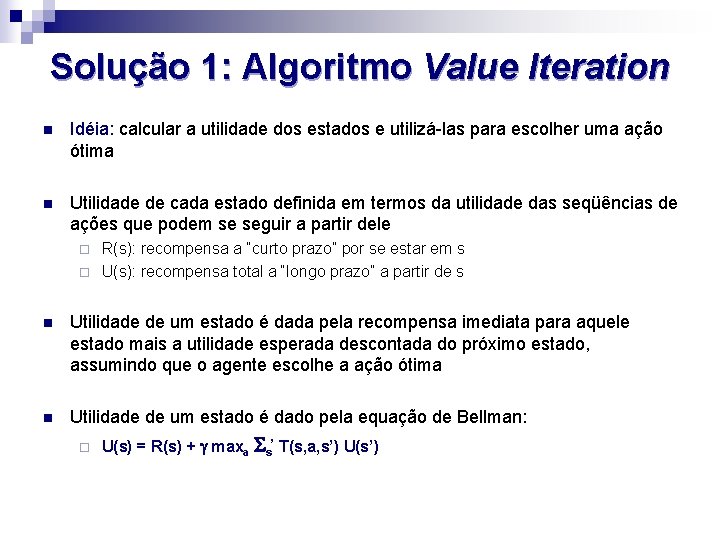
Solução 1: Algoritmo Value Iteration n Idéia: calcular a utilidade dos estados e utilizá-las para escolher uma ação ótima n Utilidade de cada estado definida em termos da utilidade das seqüências de ações que podem se seguir a partir dele R(s): recompensa a “curto prazo” por se estar em s ¨ U(s): recompensa total a “longo prazo” a partir de s ¨ n Utilidade de um estado é dada pela recompensa imediata para aquele estado mais a utilidade esperada descontada do próximo estado, assumindo que o agente escolhe a ação ótima n Utilidade de um estado é dado pela equação de Bellman: ¨ U(s) = R(s) + maxa s’ T(s, a, s’) U(s’)
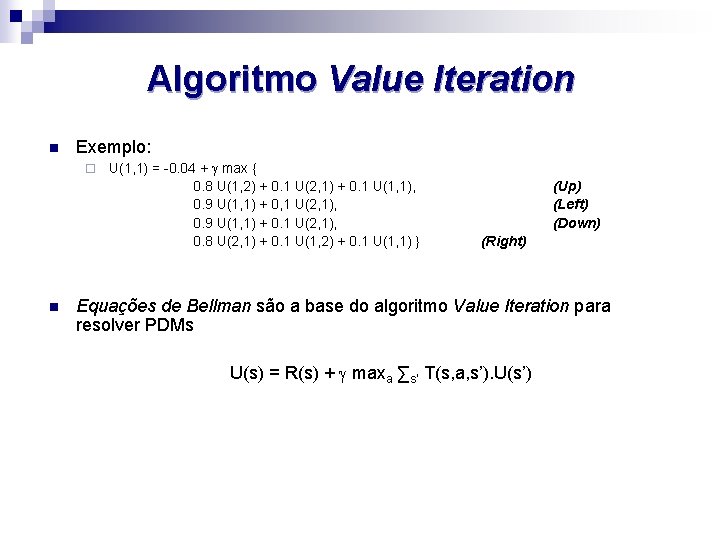
Algoritmo Value Iteration n Exemplo: ¨ n U(1, 1) = -0. 04 + max { 0. 8 U(1, 2) + 0. 1 U(2, 1) + 0. 1 U(1, 1), 0. 9 U(1, 1) + 0, 1 U(2, 1), 0. 9 U(1, 1) + 0. 1 U(2, 1), 0. 8 U(2, 1) + 0. 1 U(1, 2) + 0. 1 U(1, 1) } (Up) (Left) (Down) (Right) Equações de Bellman são a base do algoritmo Value Iteration para resolver PDMs U(s) = R(s) + maxa ∑s’ T(s, a, s’). U(s’)
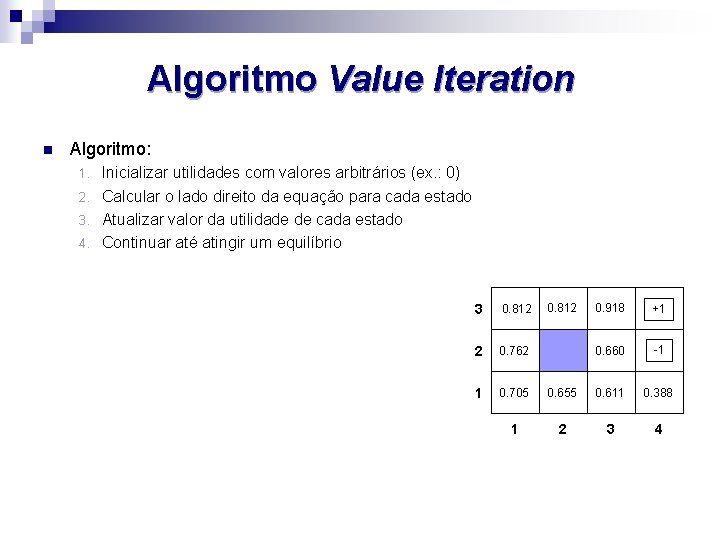
Algoritmo Value Iteration n Algoritmo: Inicializar utilidades com valores arbitrários (ex. : 0) 2. Calcular o lado direito da equação para cada estado 3. Atualizar valor da utilidade de cada estado 4. Continuar até atingir um equilíbrio 1. 3 0. 812 2 0. 762 1 0. 705 1 0. 812 0. 918 +1 0. 660 -1 0. 655 0. 611 0. 388 2 3 4
Algoritmo Policy Iteration n Idéia: se uma ação é claramente melhor que outras, então a magnitude exata da utilidade de cada estado não necessita ser precisa n Alterna entre dois passos, iniciando a partir de uma política inicial 0 qualquer: Avaliação da Política: dada política i , calcular Ui = U i ¨ Melhora da Política: calcular nova política i+1 , baseado em Ui ¨
Algoritmo Policy Iteration n Algoritmo: Enquanto não (mudou. Política) Para cada estado s se ( maxa s’ T(s, a, s’) U[s’] ) > ( s’ T(s, i(s), s’) U[s’]) então [s] = argmaxa s’ T(s, a, s’) U[s’] mudou. Política = true; n Algoritmo encerra quando passo Melhora da Política não produz nenhuma mudança nas utilidades
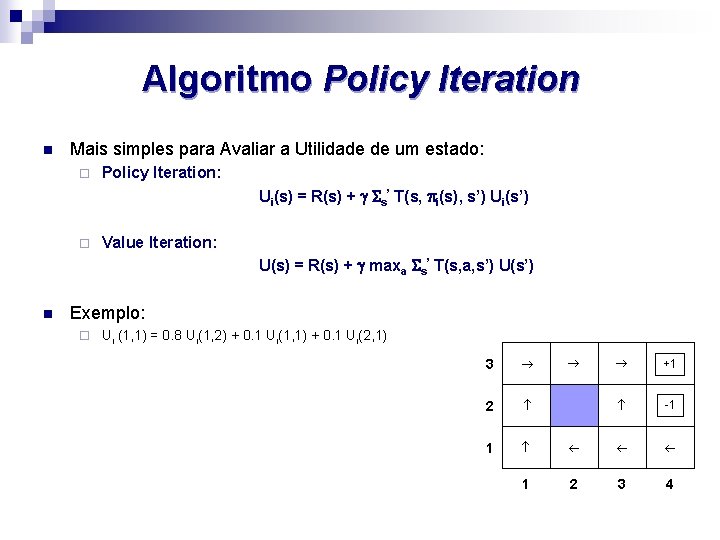
Algoritmo Policy Iteration n Mais simples para Avaliar a Utilidade de um estado: ¨ Policy Iteration: Ui(s) = R(s) + s’ T(s, i(s), s’) Ui(s’) ¨ Value Iteration: U(s) = R(s) + maxa s’ T(s, a, s’) U(s’) n Exemplo: ¨ Ui (1, 1) = 0. 8 Ui(1, 2) + 0. 1 Ui(1, 1) + 0. 1 Ui(2, 1) 3 2 1 1 +1 -1 2 3 4
Referência Bibliográfica n AIMA, Stuart Russel ¨ Cap. 16 e Cap. 17
- Slides: 32