
9 2 1 Sparkhttps archive apache orgdistspark2 4
- Slides: 46
9. 2. 1 下载安装文件 访问Spark官网(https: //archive. apache. org/dist/spark-2. 4. 0/在 页面中选择下载“spark-2. 4. 0 -bin-without-hadoop. tgz” 请使用hadoop用户登录Linux系统,打开一个终端,执行如下命令: $cd ~ $ sudo tar -zxvf ~/Downloads/spark-2. 4. 0 -bin-without-hadoop. tgz -C /usr/local/ $ cd /usr/local $ sudo mv. /spark-2. 4. 0 -bin-without-hadoop/. /spark $ sudo chown -R hadoop: hadoop. /spark # hadoop是当前登录Linux系统的用户名 《大数据基础编程、实验和案例教程(第 2版)》 厦门大学计算机科学系 林子雨 ziyulin@xmu. edu. cn
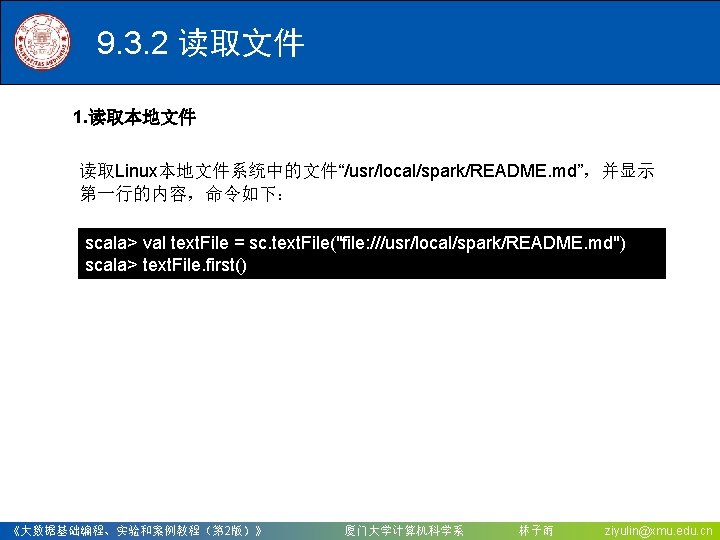
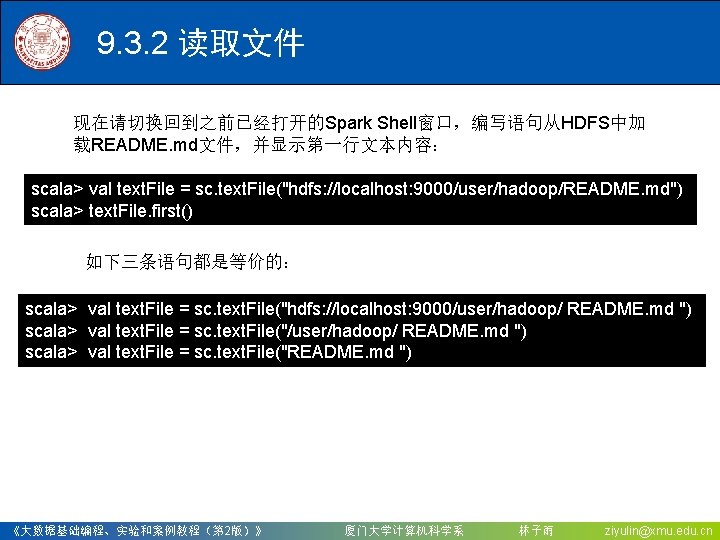
9. 3. 2 读取文件 现在请切换回到之前已经打开的Spark Shell窗口,编写语句从HDFS中加 载README. md文件,并显示第一行文本内容: scala> val text. File = sc. text. File("hdfs: //localhost: 9000/user/hadoop/README. md") scala> text. File. first() 如下三条语句都是等价的: scala> val text. File = sc. text. File("hdfs: //localhost: 9000/user/hadoop/ README. md ") scala> val text. File = sc. text. File("README. md ") 《大数据基础编程、实验和案例教程(第 2版)》 厦门大学计算机科学系 林子雨 ziyulin@xmu. edu. cn
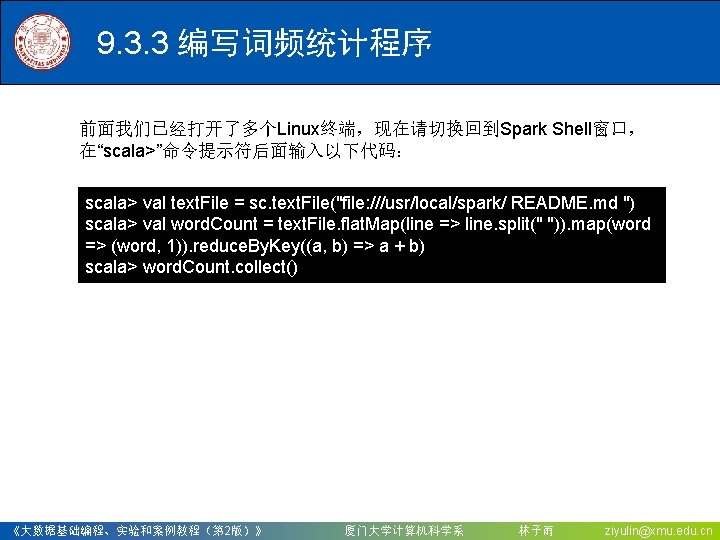
9. 3. 3 编写词频统计程序 前面我们已经打开了多个Linux终端,现在请切换回到Spark Shell窗口, 在“scala>”命令提示符后面输入以下代码: scala> val text. File = sc. text. File("file: ///usr/local/spark/ README. md ") scala> val word. Count = text. File. flat. Map(line => line. split(" ")). map(word => (word, 1)). reduce. By. Key((a, b) => a + b) scala> word. Count. collect() 《大数据基础编程、实验和案例教程(第 2版)》 厦门大学计算机科学系 林子雨 ziyulin@xmu. edu. cn
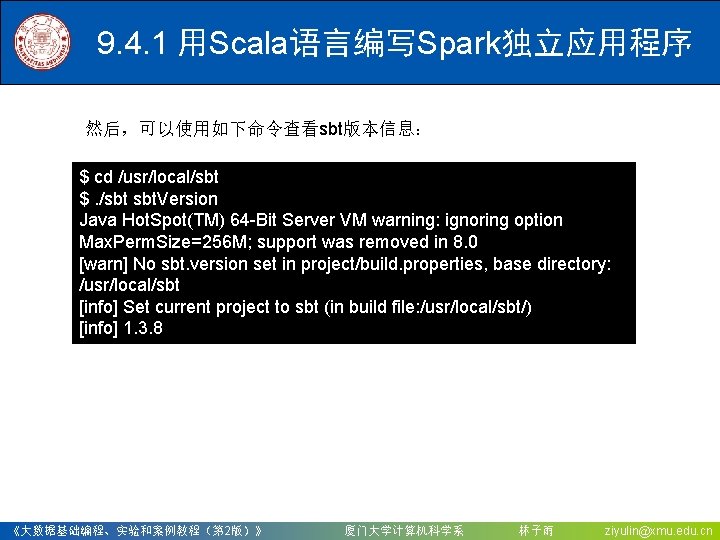
9. 4. 1 用Scala语言编写Spark独立应用程序 然后,可以使用如下命令查看sbt版本信息: $ cd /usr/local/sbt $. /sbt sbt. Version Java Hot. Spot(TM) 64 -Bit Server VM warning: ignoring option Max. Perm. Size=256 M; support was removed in 8. 0 [warn] No sbt. version set in project/build. properties, base directory: /usr/local/sbt [info] Set current project to sbt (in build file: /usr/local/sbt/) [info] 1. 3. 8 《大数据基础编程、实验和案例教程(第 2版)》 厦门大学计算机科学系 林子雨 ziyulin@xmu. edu. cn
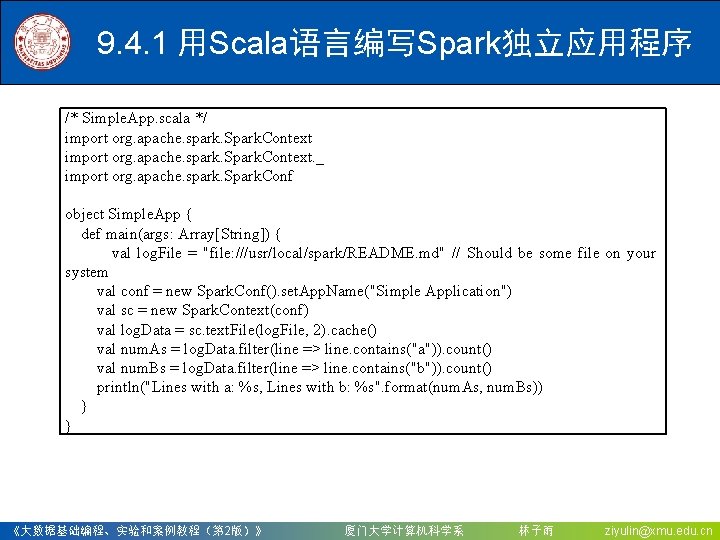
9. 4. 1 用Scala语言编写Spark独立应用程序 /* Simple. App. scala */ import org. apache. spark. Spark. Context. _ import org. apache. spark. Spark. Conf object Simple. App { def main(args: Array[String]) { val log. File = "file: ///usr/local/spark/README. md" // Should be some file on your system val conf = new Spark. Conf(). set. App. Name("Simple Application") val sc = new Spark. Context(conf) val log. Data = sc. text. File(log. File, 2). cache() val num. As = log. Data. filter(line => line. contains("a")). count() val num. Bs = log. Data. filter(line => line. contains("b")). count() println("Lines with a: %s, Lines with b: %s". format(num. As, num. Bs)) } } 《大数据基础编程、实验和案例教程(第 2版)》 厦门大学计算机科学系 林子雨 ziyulin@xmu. edu. cn
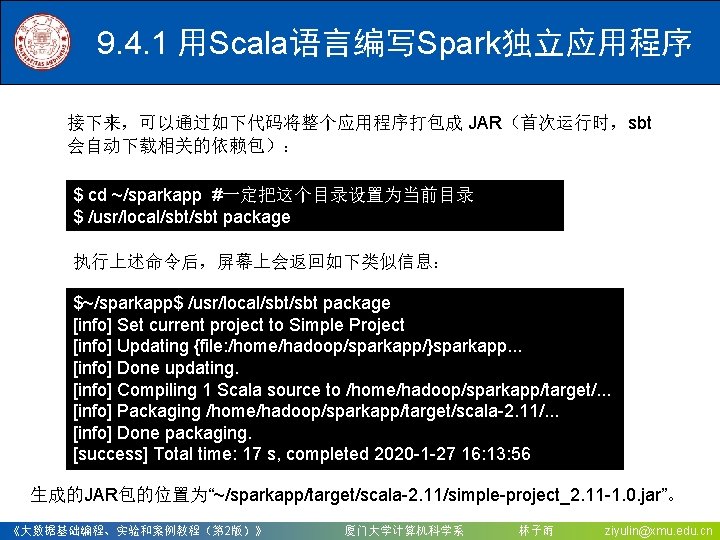
9. 4. 1 用Scala语言编写Spark独立应用程序 接下来,可以通过如下代码将整个应用程序打包成 JAR(首次运行时,sbt 会自动下载相关的依赖包): $ cd ~/sparkapp #一定把这个目录设置为当前目录 $ /usr/local/sbt package 执行上述命令后,屏幕上会返回如下类似信息: $~/sparkapp$ /usr/local/sbt package [info] Set current project to Simple Project [info] Updating {file: /home/hadoop/sparkapp/}sparkapp. . . [info] Done updating. [info] Compiling 1 Scala source to /home/hadoop/sparkapp/target/. . . [info] Packaging /home/hadoop/sparkapp/target/scala-2. 11/. . . [info] Done packaging. [success] Total time: 17 s, completed 2020 -1 -27 16: 13: 56 生成的JAR包的位置为“~/sparkapp/target/scala-2. 11/simple-project_2. 11 -1. 0. jar”。 《大数据基础编程、实验和案例教程(第 2版)》 厦门大学计算机科学系 林子雨 ziyulin@xmu. edu. cn
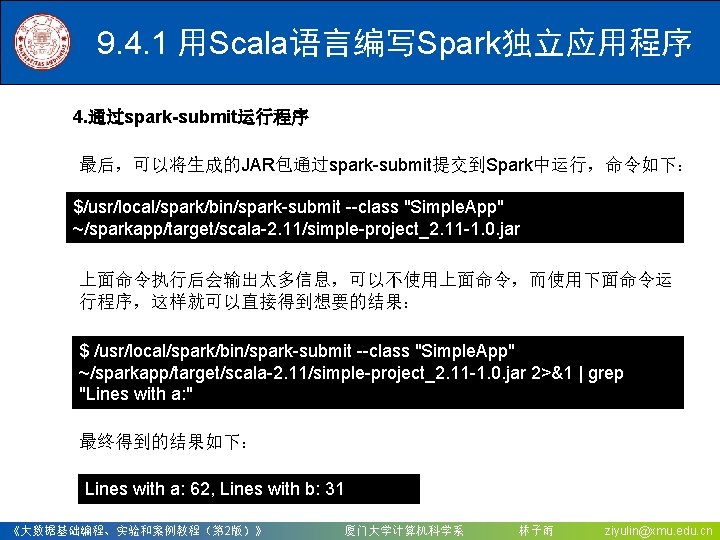
9. 4. 1 用Scala语言编写Spark独立应用程序 4. 通过spark-submit运行程序 最后,可以将生成的JAR包通过spark-submit提交到Spark中运行,命令如下: $/usr/local/spark/bin/spark-submit --class "Simple. App" ~/sparkapp/target/scala-2. 11/simple-project_2. 11 -1. 0. jar 上面命令执行后会输出太多信息,可以不使用上面命令,而使用下面命令运 行程序,这样就可以直接得到想要的结果: $ /usr/local/spark/bin/spark-submit --class "Simple. App" ~/sparkapp/target/scala-2. 11/simple-project_2. 11 -1. 0. jar 2>&1 | grep "Lines with a: " 最终得到的结果如下: Lines with a: 62, Lines with b: 31 《大数据基础编程、实验和案例教程(第 2版)》 厦门大学计算机科学系 林子雨 ziyulin@xmu. edu. cn
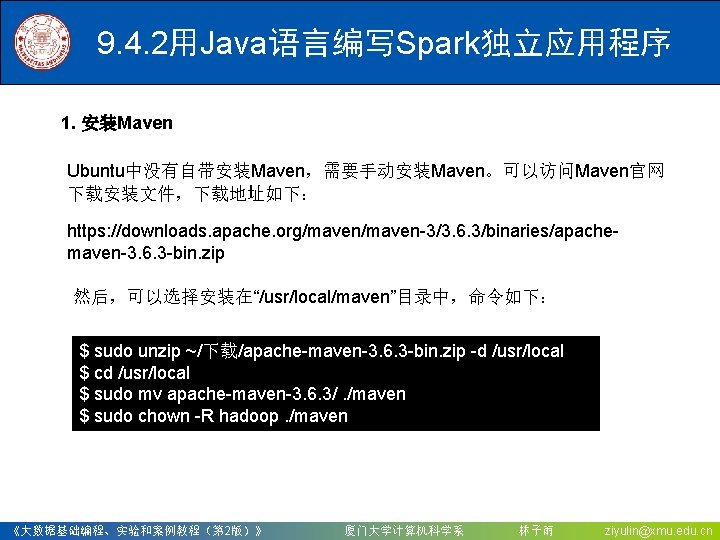
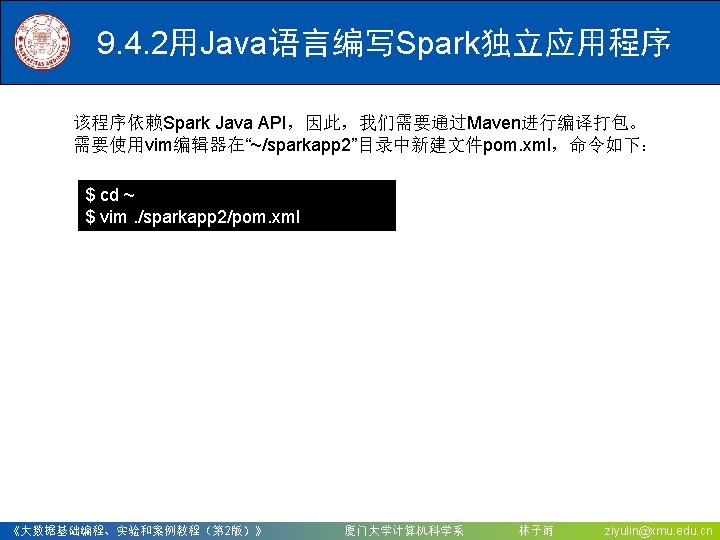
9. 4. 2用Java语言编写Spark独立应用程序 1. 安装Maven Ubuntu中没有自带安装Maven,需要手动安装Maven。可以访问Maven官网 下载安装文件,下载地址如下: https: //downloads. apache. org/maven-3/3. 6. 3/binaries/apachemaven-3. 6. 3 -bin. zip 然后,可以选择安装在“/usr/local/maven”目录中,命令如下: $ sudo unzip ~/下载/apache-maven-3. 6. 3 -bin. zip -d /usr/local $ cd /usr/local $ sudo mv apache-maven-3. 6. 3/. /maven $ sudo chown -R hadoop. /maven 《大数据基础编程、实验和案例教程(第 2版)》 厦门大学计算机科学系 林子雨 ziyulin@xmu. edu. cn
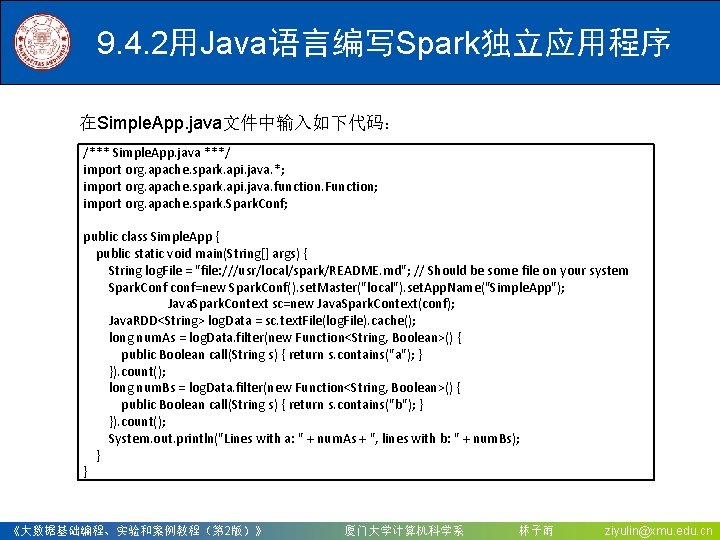
9. 4. 2用Java语言编写Spark独立应用程序 在Simple. App. java文件中输入如下代码: /*** Simple. App. java ***/ import org. apache. spark. api. java. *; import org. apache. spark. api. java. function. Function; import org. apache. spark. Spark. Conf; public class Simple. App { public static void main(String[] args) { String log. File = "file: ///usr/local/spark/README. md"; // Should be some file on your system Spark. Conf conf=new Spark. Conf(). set. Master("local"). set. App. Name("Simple. App"); Java. Spark. Context sc=new Java. Spark. Context(conf); Java. RDD<String> log. Data = sc. text. File(log. File). cache(); long num. As = log. Data. filter(new Function<String, Boolean>() { public Boolean call(String s) { return s. contains("a"); } }). count(); long num. Bs = log. Data. filter(new Function<String, Boolean>() { public Boolean call(String s) { return s. contains("b"); } }). count(); System. out. println("Lines with a: " + num. As + ", lines with b: " + num. Bs); } } 《大数据基础编程、实验和案例教程(第 2版)》 厦门大学计算机科学系 林子雨 ziyulin@xmu. edu. cn
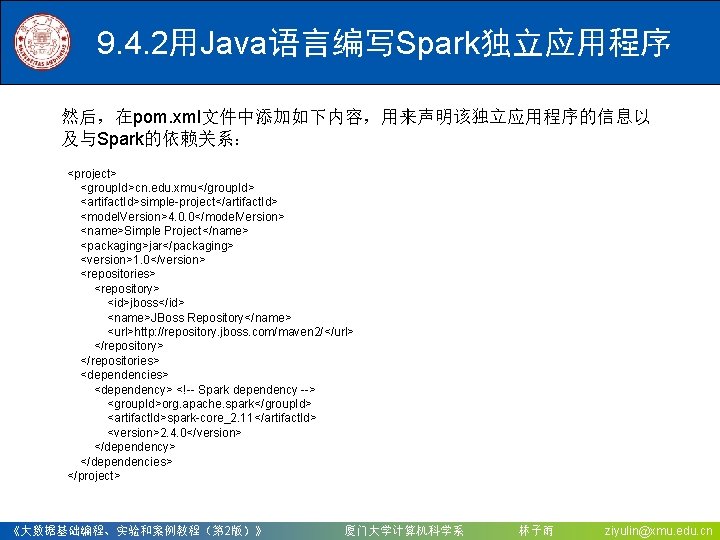
9. 4. 2用Java语言编写Spark独立应用程序 然后,在pom. xml文件中添加如下内容,用来声明该独立应用程序的信息以 及与Spark的依赖关系: <project> <group. Id>cn. edu. xmu</group. Id> <artifact. Id>simple-project</artifact. Id> <model. Version>4. 0. 0</model. Version> <name>Simple Project</name> <packaging>jar</packaging> <version>1. 0</version> <repositories> <repository> <id>jboss</id> <name>JBoss Repository</name> <url>http: //repository. jboss. com/maven 2/</url> </repository> </repositories> <dependencies> <dependency> <!-- Spark dependency --> <group. Id>org. apache. spark</group. Id> <artifact. Id>spark-core_2. 11</artifact. Id> <version>2. 4. 0</version> </dependency> </dependencies> </project> 《大数据基础编程、实验和案例教程(第 2版)》 厦门大学计算机科学系 林子雨 ziyulin@xmu. edu. cn
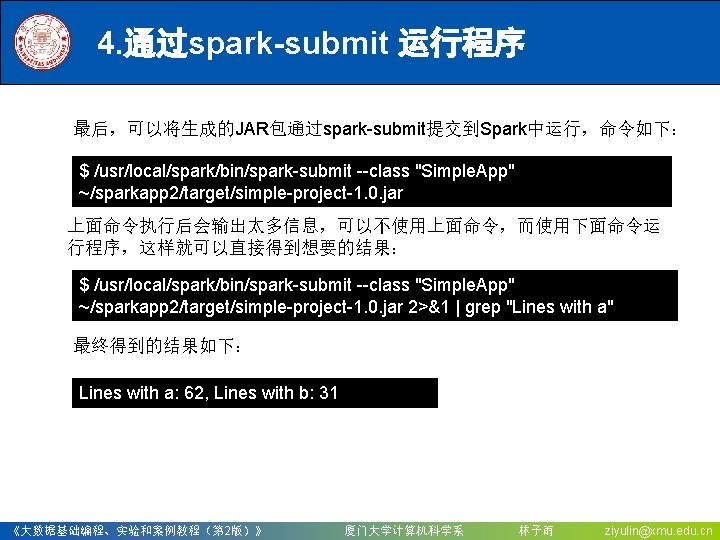
4. 通过spark-submit 运行程序 最后,可以将生成的JAR包通过spark-submit提交到Spark中运行,命令如下: $ /usr/local/spark/bin/spark-submit --class "Simple. App" ~/sparkapp 2/target/simple-project-1. 0. jar 上面命令执行后会输出太多信息,可以不使用上面命令,而使用下面命令运 行程序,这样就可以直接得到想要的结果: $ /usr/local/spark/bin/spark-submit --class "Simple. App" ~/sparkapp 2/target/simple-project-1. 0. jar 2>&1 | grep "Lines with a" 最终得到的结果如下: Lines with a: 62, Lines with b: 31 《大数据基础编程、实验和案例教程(第 2版)》 厦门大学计算机科学系 林子雨 ziyulin@xmu. edu. cn
Department of Computer Science, Xiamen University, 2020 《大数据基础编程、实验和案例教程(第 2版)》 厦门大学计算机科学系 林子雨 ziyulin@xmu. edu. cn